BullMQ: очереди задач в Node.js — повторы, прогресс и мастерская
Выносим отчёты и импорт из HTTP-запроса в фоновую очередь. Пробуем повторы, прогресс, задержки и параллельную обработку в мастерской, запускаем настоящий BullMQ с Node.js и Redis.
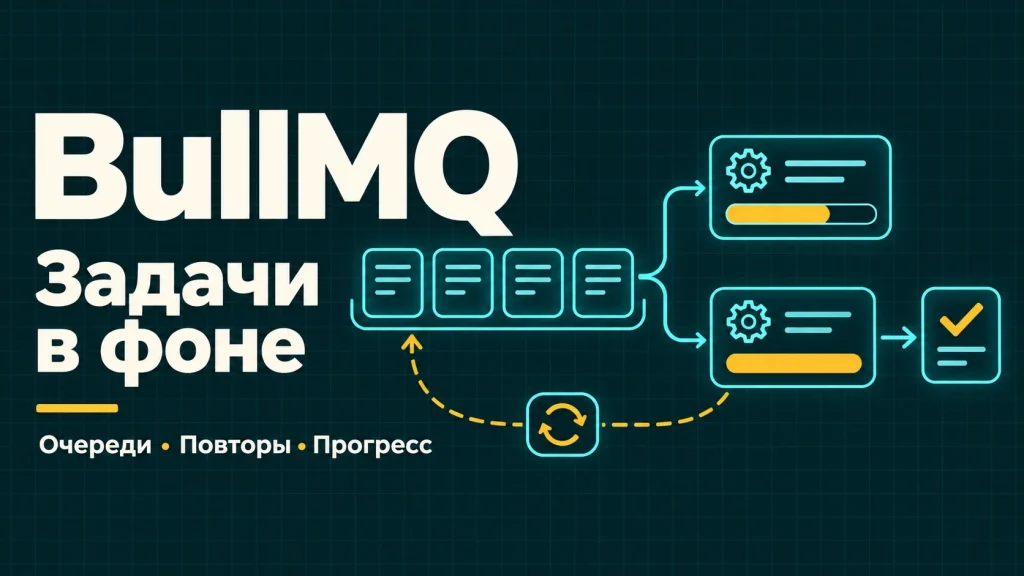
BullMQ помогает выполнять долгие операции в фоне: принимать задачу, передавать её обработчику, показывать прогресс и повторять работу после временной ошибки. Пользователь заказывает отчёт и получает понятный статус, импортирует записи и видит обработанные строки, запускает несколько независимых операций и продолжает пользоваться сервисом. Серверу при этом не нужно держать один HTTP-запрос открытым до конца всей работы.
В этом руководстве соберём очередь на Node.js и Redis. На странице можно поэкспериментировать с состояниями, повторами, задержкой и параллельностью. В архиве находится настоящий проект: отдельные API и worker, BullMQ, Redis, Docker Compose, панель задач и проверки. Разберём не только вызовы методов, но и ситуации, когда очередь помогает, когда она усложняет решение и почему повторная попытка требует аккуратной бизнес-логики.
Что такое BullMQ и какой результат получает пользователь
Очередь полезна, когда момент запроса и момент получения результата могут быть разнесены. Например, менеджер просит выгрузить заявки за месяц. API проверяет параметры и права, добавляет задание и возвращает его идентификатор. Отдельный обработчик выбирает данные, формирует файл и помечает работу завершённой. Интерфейс показывает состояние и предлагает скачать результат, когда он действительно готов.
Для человека это означает предсказуемое поведение: кнопка не зависает без объяснения, повторное открытие страницы не теряет смысл операции, а ошибка не исчезает за общей надписью «что-то пошло не так». Для разработчика появляются управляемые состояния, ограничение числа одновременных задач, повтор после сбоя и журнал причины. Очередь не делает медленный алгоритм быстрым, но помогает организовать его выполнение и объяснить ожидание.
BullMQ предоставляет классы для постановки и обработки задач, событий, расписаний и зависимостей между операциями. Здесь используем Node.js и Redis — привычный вариант для веб-сервиса. Текущая экосистема библиотеки шире: существуют другие SDK и backend-варианты. Выбор хранилища и языка стоит проверять по актуальной документации, а не по старому утверждению «эта библиотека работает только одним способом».
Официальная документация: Возможности BullMQ.
Где применять: отчёты, импорт, файлы и интеграции
| Задача сервиса | Зачем очередь | Что показать в интерфейсе |
|---|---|---|
| Выгрузка CSV или PDF | Отделить подготовку документа от HTTP-запроса | Принято → формируется → скачать |
| Импорт клиентов или товаров | Обрабатывать набор записей с контролем ошибок | Сколько обработано, сколько отклонено |
| Подготовка изображений | Ограничить нагрузку и организовать отдельные обработчики | Прогресс пакета и готовые файлы |
| Webhook или синхронизация | Повторить временно неудачную доставку | Попытка, следующий повтор, причина сбоя |
| Периодический расчёт | Запускать работу по расписанию | Последний результат и время следующего запуска |
Очередь хорошо вписывается в CRM, административную панель, личный кабинет, интернет-магазин и внутреннюю систему компании. Загрузка файла уже закончилась, но его проверка и обработка ещё продолжаются — это отдельная фоновая задача. Клиент запросил сложный отчёт, но ему не обязательно смотреть на неподвижный экран всё время подготовки. В этих местах понятная очередь превращает техническое ожидание в управляемый пользовательский сценарий.
Есть и противоположные случаи. Проверка обязательного поля, короткий поиск или простая запись в базу обычно должны дать непосредственный ответ. Если перенести каждую мелочь в очередь, появятся лишние состояния, задержки и инфраструктура. Полезный критерий: может ли пользователь продолжить работу после принятия операции и есть ли смысл получать её результат отдельно? Если ответ отрицательный, обычный запрос может быть проще.
Мини-мастерская: восемь сценариев очереди
Начните с отчёта: добавьте задачу, выберите её карточку и проследите путь от ожидания до готового CSV. Затем попробуйте импорт с прогрессом, временный сбой, окончательную ошибку, отложенный запуск, повтор одинакового ключа, партию задач и паузу. У каждого сценария есть объяснение, ожидаемый результат и исходный код. Это помогает связать движение карточек с конкретной настройкой BullMQ.
Меняйте один параметр за раз. Уменьшите число попыток у временного сбоя и сравните итог. Поставьте общую параллельность в единицу, добавьте несколько задач, затем разрешите три одновременные операции. Пауза позволяет увидеть, что новые задачи ждут продолжения, а уже выполняющиеся не обязаны останавливаться. В карточке смотрите не только процент, но и номер попытки, ошибку, результат и временную последовательность.
Открыть мастерскую на весь экран ↗Скачать Node.js-проект и исходники ZIP ↓
Как это работает: API, Queue, Redis и Worker
У системы есть несколько ролей. Producer создаёт задание: чаще всего это обработчик HTTP-запроса. Queue — программный доступ к очереди с её именем и настройками. Redis хранит данные и состояние. Worker получает работу и выполняет функцию обработки. API статуса связывает эту серверную часть с экраном пользователя. Эти роли можно разместить в отдельных процессах, даже если весь учебный стенд находится на одном компьютере.
| Компонент | Ответственность | Чего он сам не обещает |
|---|---|---|
| HTTP API | Проверить запрос, добавить задание, вернуть ID | Завершение работы к моменту ответа |
| Queue | Поставить задачу и получить её состояние | Исполнение бизнес-кода без worker |
| Redis | Хранить структуру очереди и переходы состояний | Защиту от любого отказа диска |
| Worker | Выполнить обработчик и сообщить итог | Автоматическую идемпотентность приложения |
| Панель задач | Показать ожидание, прогресс, результат и ошибку | Подмену серверного статуса красивой анимацией |
Практическая цепочка выглядит так: браузер → API → очередь в Redis → worker → результат → API статуса → браузер. Если остановить worker, API может продолжать принимать задания, и они будут ждать. Если Redis недоступен, producer не должен сообщать, что работа надёжно принята. Такой разбор помогает искать сбой на нужном участке, а не перезапускать все компоненты подряд.
Официальная документация: Очереди, Обработчики задач.
Запуск настоящего проекта на своём компьютере
Скачайте ZIP и распакуйте его в отдельную папку. Для основного пути нужен Docker с Linux-контейнерами и современный Docker Compose. Локально устанавливать Redis и зависимости Node.js не потребуется: они входят в сборку контейнеров. Если Docker ещё не знаком, начните с практического руководства по Docker Compose.
Первый запуск API, worker и Redis
# Windows PowerShell, из корня распакованного проекта
Copy-Item .env.example .env
docker compose config --quiet
docker compose up -d --build --wait
docker compose ps
В Linux/macOS вместо первой команды копирования используйте cp .env.example .env. Откройте http://127.0.0.1:3098. Интерфейс локального проекта явно показывает подключение к реальному API. Создайте отчёт, дождитесь завершения и скачайте CSV. Файл содержит учебные строки, поэтому его можно безопасно рассматривать как образец формата результата.
Первый запуск требует загрузки образов и установки пакетов. Если порт занят, измените внешний порт в .env согласно README. Для обычной остановки выполните docker compose down: именованный том Redis сохранится. Флаг удаления томов относится к отдельному полному сбросу данных и не нужен после каждого упражнения. При повторном запуске не перезаписывайте собственные настройки без сравнения.
Версии и зависимости: что важно в BullMQ 6
На дату подготовки, 7 ноября 2026 года, пакет BullMQ в npm имеет версию 6.7.1. Проект закрепляет BullMQ, ioredis и дерево зависимостей в package-lock.json. Для воспроизведения используйте npm ci, а обновление пакетов проводите отдельным шагом с повторной проверкой. Номер версии сам по себе не доказывает совместимость вашего старого кода и уже накопленных данных Redis.
В BullMQ 6 удалены старые API repeatable jobs: расписания создаются через Job Schedulers. В старых статьях можно встретить queue.add(..., { repeat: ... }) или обязательный QueueScheduler. Такие фрагменты нельзя механически переносить в новый проект. При миграции действующей системы сначала изучают переходный порядок для её версии и существующих расписаний. В новом примере мы сразу используем современный API.
Пауза и продолжение тоже должны соответствовать текущему контракту: await queue.resume() нужно дождаться. В этой статье функции показывают принцип, а полный запускаемый набор находится в архиве. Перед переносом в своё приложение полезно сверить установленные версии и методы с API, а не смешивать три руководства разных лет в одном файле.
Официальная документация: Изменения BullMQ 6.
Постановка задачи: ответ API ещё не результат работы
Producer принимает намерение пользователя: «сформировать отчёт с такими параметрами». До добавления задачи нужно проверить формат, допустимый объём и право на операцию. После успешного добавления можно вернуть HTTP 202 и идентификатор. Такой ответ означает принятие к обработке; файл может появиться позже, а задача может завершиться ошибкой. Интерфейс должен сохранять эту разницу в формулировках.
Принцип producer: добавить проверенные параметры и вернуть ID
import { Queue } from 'bullmq';

const queue = new Queue('reports', {
  connection: { host: 'redis', port: 6379, maxRetriesPerRequest: 1 },
});

const job = await queue.add('monthly-report',
  { reportId: 'demo-2026-11', period: '2026-11' },
  { attempts: 3, backoff: { type: 'exponential', delay: 1000 } },
);
// Только после успешного queue.add:
// HTTP 202 с идентификатором job.id.
// Конкретный маршрут получения статуса определяет ваше API.
Не отправляйте в задачу весь HTTP-запрос, объект соединения с базой или большой бинарный файл. Обычно достаточно идентификаторов, версии операции и небольших параметров. Сам файл размещают в подходящем хранилище, а worker получает контролируемую ссылку или внутренний ключ. Набор данных должен оставаться понятным и через несколько минут, когда запрос уже закончился, а пользователь закрыл вкладку.
Официальная документация: Устройство задач.
Запрос к настоящему API из архива после запуска Compose
$payload = @{
  scenario = 'report'; batch = 1; attempts = 1
  backoffMs = 1000; delayMs = 0; durationMs = 3000
  jobKey = 'demo-report'
} | ConvertTo-Json
$accepted = Invoke-RestMethod -Method Post `
  -Uri http://127.0.0.1:3098/api/jobs `
  -ContentType 'application/json' -Body $payload
$accepted.jobs[0].id
Invoke-RestMethod http://127.0.0.1:3098/api/snapshot
В этом проекте POST /api/jobs возвращает массив принятых задач и число запросов с уже существующим ID. GET /api/snapshot показывает состояния очереди, а GET /api/jobs/ID/result возвращает содержимое готового результата. До завершения задачи маршрут результата отвечает HTTP 409: сначала нужно дождаться completed. Так HTTP-контракт соответствует тому, что видит человек в панели.
Обработчик: отдельный процесс и понятный результат
Worker слушает ту же очередь и подключается к тому же хранилищу, что producer. Название очереди — часть соглашения между компонентами: опечатка легко создаёт ситуацию, когда задания добавляются, но никто их не берёт. Функция обработчика получает job, читает параметры, выполняет шаги и возвращает сериализуемый результат либо выбрасывает Error.
Схема worker; реальное формирование CSV реализовано в скачанном проекте
import { Worker } from 'bullmq';

const worker = new Worker('reports', async job => {
  await job.updateProgress({ percent: 10, stage: 'Подготовка данных' });
  // Здесь выполняется ваш код формирования отчёта.
  await job.updateProgress({ percent: 100, stage: 'Готово' });
  return { reportId: job.data.reportId, ready: true };
}, {
  connection: { host: 'redis', port: 6379, maxRetriesPerRequest: null },
  concurrency: 2,
});
worker.on('error', error => console.error('worker_error', error.message));
Код выше показывает контракт, а не заменяет полноценную генерацию файла. В учебном проекте обработчики действительно строят CSV или обрабатывают синтетические записи. В приложении результат должен содержать то, что нужно следующему шагу: ID документа, число строк, статус импорта. Секретные пути и внутренние исключения не стоит автоматически передавать в публичный ответ.
Полный обработчик из архива: прогресс, контролируемые ошибки, CSV и импорт
src/processor.js — тот же файл, который выполняется в контейнере worker
import {setTimeout as sleep} from 'node:timers/promises';
import {createCsvResult} from '../public/scenarios.js';
export function createProcessor(redis) {
 return async job=>{
  const {scenario='report',durationMs=3000}=job.data;
  const steps=scenario==='import'?12:6;
  await job.log(JSON.stringify({at:Date.now(),type:'info',message:`Начата попытка ${job.attemptsMade+1}.`}));
  await job.updateProgress(0);
  for(let step=1;step<=steps;step++){
   await sleep(Math.max(50,Math.floor(durationMs/steps)));
   if(step===2 && ((scenario==='retry'&&job.attemptsMade<2)||scenario==='failure')){
    const message=scenario==='retry'?'Учебный временный сбой: первые две попытки неудачны.':'Учебная ошибка исходных данных: повтор не исправляет причину.';
    await job.log(JSON.stringify({at:Date.now(),type:'retry',message}));
    throw new Error(message);
   }
   if(scenario==='import'){
    // Idempotent within this job: the same row key is overwritten, never appended.
    const key=`aen-demo:import:${job.id}`;
    await redis.hset(key,`client-${step}`,JSON.stringify({id:step,name:`Учебный клиент ${step}`}));
    await redis.expire(key,86400);
   }
   await job.updateProgress(Math.round(step/steps*100));
  }
  const result=createCsvResult(job.id,scenario);
  if(scenario==='import'){
   result.rows=await redis.hlen(`aen-demo:import:${job.id}`);
   result.filename=`import-${job.id}.json`;
   result.mime='application/json;charset=utf-8';
   result.content=JSON.stringify({jobId:job.id,rows:result.rows,items:Object.values(await redis.hgetall(`aen-demo:import:${job.id}`)).map(JSON.parse)},null,2);
   result.summary=`Обработаны ${result.rows} учебных записей без дублирования ключей этой задачи.`;
  }
  await job.log(JSON.stringify({at:Date.now(),type:'completed',message:'Обработка завершена. Результат сохранён вместе с задачей.'}));
  return result;
 };
}
Официальная документация: Обработчики задач, Возвращаемые результаты.
Состояния задачи: что означает каждая карточка
| Состояние | Что происходит | Как объяснить человеку |
|---|---|---|
| waiting | Задание готово к выбору worker | Ожидает свободного обработчика |
| active | Обработчик выполняет задачу | Работа идёт; показываем этап и прогресс |
| delayed | Срок запуска или повторной попытки ещё не наступил | Запланировано либо ожидает повтора |
| completed | Обработчик успешно вернул результат | Результат готов и доступен |
| failed | Работа завершилась неуспешно | Есть причина и понятный следующий шаг |
Не все переходы удастся заметить при периодическом обновлении интерфейса: короткая задача может пройти waiting между двумя запросами статуса. Это не ошибка, если серверный результат корректен. Пауза очереди добавляет своё состояние ожидания; подробности могут включать и другие технические состояния. Пользовательская панель имеет право группировать их, если не скрывает важный смысл и не выдаёт очередь за завершение.
Полезно хранить время создания, начала и окончания отдельно. Десять секунд в очереди и десять секунд работы — разные проблемы. Первая часто связана с нагрузкой или паузой, вторая — с самим обработчиком. Если показывать только общий секундомер, будет трудно понять, что ускорять. У завершённой задачи должен быть результат, а у неудачной — причина без раскрытия внутренних секретов.
Официальная документация: Устройство задач.
Пример 1. Отчёт CSV с получением готового файла
Сценарий отчёта имитирует привычную задачу административной панели: собрать данные по клиентам и отдать выгрузку. В настоящем проекте worker формирует CSV из контролируемого набора. После completed API позволяет скачать результат. Кнопка скачивания появляется по фактической готовности, а не по таймеру на странице. Это удобная основа для экспорта заказов, заявок, сверок и статистики.
Попробуйте закрыть и снова открыть локальную панель после запуска. Состояние настоящей очереди хранится на серверной стороне, а не только в памяти страницы. При этом сохраняемый срок истории ограничен политикой проекта. Для рабочего сервиса нужна собственная связь задания с пользователем и документом: человек должен видеть только свои отчёты и иметь возможность вернуться к ним через список операций.
Большие файлы лучше хранить отдельно от метаданных очереди. Redis не следует превращать в архив всех выгрузок. Worker может сохранить документ в файловое или объектное хранилище и вернуть его внутренний ID. API затем проверит права и выдаст скачивание. В учебном стенде CSV маленький, поэтому результат намеренно сделан простым и доступным для чтения исходников.
Официальная документация: Возвращаемые результаты.
Пример 2. Импорт и прогресс по выполненным шагам
При импорте процент должен быть связан с реальной работой. Если известно, что нужно обработать 12 строк, после трёх обработанных строк можно показать 25%. Если общий объём неизвестен, честнее показать этап и счётчик выполненных элементов, чем рисовать точный процент из случайного времени. Прогресс помогает пользователю понять движение, но завершение определяется состоянием задачи.
Принцип прогресса: saveRowIdempotently — функция сохранения вашего приложения
const total = rows.length;
for (let index = 0; index < total; index++) {
  await saveRowIdempotently(rows[index]);
  await job.updateProgress({
    percent: Math.round(((index + 1) / total) * 100),
    processed: index + 1,
    total,
    stage: 'Импорт записей',
  });
}
Обработчик не обязан отправлять событие на каждую строку из миллиона. Можно обновлять состояние раз в пакет или после заметного изменения процента. Это уменьшает нагрузку на Redis и интерфейс. Для пользователя полезны этапы «проверка», «запись», «подготовка результата» и итоговая статистика: обработано, пропущено, отклонено. Строка с ошибкой данных не всегда означает, что нужно отменить весь пакет.
В нашем примере повтор одной и той же задачи использует устойчивые ключи учебных записей. В реальном импорте ключ должен отражать смысл данных: например, ID клиента у источника и номер версии выгрузки. Если при каждой попытке создавать новые случайные идентификаторы, повтор может породить дубли, даже когда сама очередь работает корректно.
Пример 3. Временный сбой, attempts и backoff
Временная ошибка — обычная часть интеграции: внешний сервис занят, соединение разорвалось, база ненадолго недоступна. Повтор позволяет пережить такой сбой без ручного запуска. В мастерской первые две попытки специально завершаются ошибкой, а третья может пройти успешно. Поставьте attempts равным двум, затем трём: итог изменится по понятной причине.
Три попытки всего, с увеличивающейся паузой между повторами
await queue.add('sync-demo', { entityId: 'demo-42' }, {
  attempts: 3,
  backoff: { type: 'exponential', delay: 1000, jitter: 0.2 },
});
attempts: 3 включает первоначальный запуск, поэтому дополнительных повторов будет не больше двух. Fixed backoff сохраняет одинаковую паузу, exponential увеличивает её; jitter добавляет разброс, чтобы множество задач не вернулось к зависимому сервису одновременно. Без backoff повтор может последовать сразу. Это технические настройки устойчивости, а не способ гарантировать успех любой операции.
Для пользователя полезно различать «ожидает повторной попытки» и окончательное «не выполнено». В карточке показывайте последнюю причину, использованные попытки и следующий ожидаемый шаг. Одинаковая красная ошибка после каждого промежуточного сбоя создаёт лишнюю тревогу, а постоянная зелёная надпись скрывает проблему. Хорошая панель объясняет, работает ли автоматика и требуется ли действие человека.
Официальная документация: Повторы и backoff.
Пример 4. Когда повтор не исправит ошибку
Неверный формат данных, отсутствующий обязательный идентификатор или запрещённая операция не становятся правильными через секунду ожидания. Сценарий окончательной ошибки специально показывает исчерпание попыток. После этого полезно изучить причину и исправить входные данные. Безусловная кнопка «повторять бесконечно» способна только увеличить нагрузку и засорить журнал одинаковыми сообщениями.
Разделяйте неустранимую ошибку входных данных и временный сбой
import { UnrecoverableError } from 'bullmq';

if (!job.data.entityId) {
  throw new UnrecoverableError('Не указан идентификатор записи');
}
// Временный сбой в другом месте:
// throw new Error('Источник временно недоступен');
Сообщение для пользователя и технический журнал могут отличаться. Человеку достаточно понять, какое поле исправить или когда обратиться к администратору. В журнале нужны jobId, тип операции, попытка и техническая причина. Нельзя автоматически показывать браузеру полный stack trace с путями, строками подключения или токенами. Для ручного повторения также определите, повторяется исходная задача или создаётся новая версия операции.
В мастерской ручной повтор запускает ту же failed-задачу дополнительно: счётчик прежних попыток сохраняется. Поэтому после такого действия число завершённых попыток может стать больше первоначального автоматического лимита. Панель подписывает его как «автолимит», а журнал показывает историю. В сценарии постоянной ошибки новый запуск снова завершится неудачно: нажатие кнопки не меняет исходные данные.
Официальная документация: Ошибки без повторов.
Пример 5. Отложенная задача и обещание времени
Delay задаёт задержку до момента, когда задача станет доступной для обработки. Это пригодится для напоминания, отложенного пересчёта, проверки статуса через некоторое время или сглаживания серии быстрых изменений. После наступления срока задача всё ещё зависит от доступного worker и состояния очереди. Поэтому «не раньше указанного момента» точнее обещания «ровно в эту секунду».
Однократный отложенный запуск через пять секунд или позднее
await queue.add('check-status', { requestId: 'demo-42' }, {
  delay: 5000,
  attempts: 2,
});
В мастерской сначала видна delayed-карточка с ожиданием, затем задача переходит к исполнению. Для проверки нагрузки поставьте очередь на паузу и дождитесь наступления срока: готовность по времени не обязывает обработчик игнорировать паузу. Для рабочих напоминаний храните исходный момент и часовой пояс в понятном виде, а после изменения бизнес-события решайте, нужно ли отменить или перенести прежнюю задачу.
Отложенная задача отличается от расписания. Первая описывает один будущий запуск. Второе — правило создания новых задач. Если каждый открытый браузер вручную добавляет «следующий запуск», расписание быстро начнёт зависеть от вкладок пользователей. Такой процесс лучше держать на сервере и управлять одним устойчивым идентификатором.
Официальная документация: Отложенные задачи.
Пример 6. Одинаковый jobId и дедупликация
При двойном нажатии кнопки или повторе HTTP-запроса producer может дважды получить одно намерение. Пользовательский jobId помогает не создать ещё одну запись задачи с тем же ID в той же очереди, пока исходная запись сохраняется. В мастерской отправьте одинаковый ключ дважды и сравните возвращённый идентификатор. Изменение ключа означает уже другое задание.
Устойчивый jobId для одного учебного отчёта
await queue.add('report', { period: '2026-11' }, {
  jobId: 'report-demo-2026-11',
  removeOnComplete: { count: 100 },
});
Эта защита имеет границу: после удаления записи задачи тот же ID снова может быть принят. Поэтому политика хранения истории влияет и на подавление дублей. Пользовательский ID должен быть допустимым для BullMQ; в примере используем буквы, цифры и дефисы, без двоеточия. Добавьте в ключ идентификатор владельца и смысл операции, если они необходимы для разделения разных запросов.
Отдельная возможность BullMQ — deduplication. Она поддерживает собственные идентификаторы и правила времени жизни, а не просто совпадение jobId. Например, можно подавлять новые задачи, пока предыдущая операция ещё не завершена, либо сглаживать частые обновления. Выбирайте режим по требованию продукта. Ни один из этих механизмов сам по себе не гарантирует, что внешний платёж или запись в вашей базе выполнятся ровно один раз.
Официальная документация: Идентификаторы задач, Режимы дедупликации.
Идемпотентность: почему задача может выполниться повторно
Worker может успеть сохранить результат во внешней системе и завершиться до подтверждения состояния очереди. При восстановлении та же работа может быть выдана снова. Поэтому модель обработки требует готовности к повторному выполнению. Идемпотентная операция при повторе с тем же смысловым ключом не создаёт лишнего бизнес-эффекта: второй запуск подтверждает или обновляет тот же результат.
Для импорта это может быть уникальный ключ записи и upsert. Для документа — устойчивый ID сформированного отчёта. Для обращения к платёжному провайдеру — предусмотренный им idempotency key вместе с собственным учётом состояния. Простая проверка «есть ли запись» перед вставкой не всегда достаточна: между проверкой и действием может пройти другой процесс. Нужны ограничения и атомарность на уровне системы, где возникает эффект.
Старайтесь делать задачи небольшими и понятными. «Прочитать параметры, сохранить один результат, подтвердить выполнение» легче восстановить, чем цепочку несвязанных побочных действий без промежуточного учёта. Если задача состоит из этапов, храните их завершение и продумывайте повтор каждого. Учебный импорт показывает принцип устойчивого ключа, но не объявляется универсальной транзакцией для любых внешних сервисов.
Официальная документация: Идемпотентные задачи.
Пример 7. Несколько задач и ограничение параллельности
Concurrency определяет, сколько задач обработчик может вести одновременно. Это удобно для работы с ожиданием: одна операция ждёт ответ базы, другая обрабатывает следующий доступный шаг. В учебной панели общий лимит очереди меняется от одного до четырёх, а локальный worker допускает до четырёх. Поэтому выбранное значение ограничивает суммарную активную работу, а не просто меняет скорость анимации.
Глобальный и локальный лимиты решают разные задачи
// Лимит для всей очереди, включая несколько worker-процессов:
await queue.setGlobalConcurrency(3);

// Локальная настройка конкретного worker:
worker.concurrency = 4;
Добавьте партию независимых отчётов. При лимите один они будут выполняться последовательно; при большем значении несколько смогут стать active. Порядок завершения не обязан совпадать с порядком добавления: операции могут занимать разное время. Если следующий шаг зависит от предыдущего, это нужно описать как зависимость или последовательность, а не надеяться на случайную длительность.
Высокое concurrency не превращает один JavaScript-процесс в множество вычислительных ядер. Для тяжёлых синхронных вычислений нужны отдельные процессы, worker threads или sandboxed processors и контроль ресурсов. Также учитывайте пределы базы и внешнего API: увеличение параллельности может ухудшить время ответа всей системы. Подбирать значение стоит по измерениям очереди и зависимостей.
Официальная документация: Параллельность обработчика, Общий лимит очереди, Процессы и worker threads.
Пример 8. Пауза очереди и продолжение работы
Пауза полезна при обслуживании зависимости или расследовании ошибки. Она прекращает выдачу новых заданий на обработку, но уже активные задачи могут закончиться. Поэтому кнопка должна называться и объясняться именно как пауза очереди. Пользователь не должен ожидать, что нажатие мгновенно откатит уже выполненные записи или прервёт все текущие операции.
Глобальная пауза и продолжение очереди
await queue.pause();
// Новые задания можно добавить, но обработка ждёт продолжения.
await queue.resume();
В мастерской запустите несколько задач, включите паузу и добавьте ещё одну. Сравните судьбу active и ожидающих карточек. Затем продолжите очередь. В рабочем сервисе управление такой кнопкой обычно доступно администратору, а обычному пользователю показывается понятное состояние: «обработка временно приостановлена». Сам API постановки может иметь отдельное правило — принимать новые задания или временно отказывать.
Пауза конкретного worker и пауза всей очереди — разные действия. Кроме того, пауза не равна отмене задания. Отмена требует отдельного контракта: можно ли прервать операцию, как обработчик проверяет сигнал и что делать с уже созданным результатом. Не стоит привязывать удаление данных к кнопке, которая визуально обещает лишь временно остановить очередь.
Официальная документация: Пауза очереди и обработчика.
Как показывать прогресс: polling, события и восстановление экрана
Самый понятный путь для небольшого интерфейса — периодически запрашивать список или состояние выбранной задачи. Такой polling легко проверить через HTTP, он работает после обновления страницы и не требует постоянного соединения. При активной работе можно обновлять чаще, при отсутствии задач — реже, а в скрытой вкладке уменьшать нагрузку. Учебный локальный интерфейс получает серверные данные именно через API.
QueueEvents позволяет слушать события очереди независимо от конкретного worker. Из серверного процесса их можно передавать клиенту через SSE или WebSocket, если проекту действительно нужна малая задержка. Но событие не должно быть единственным источником истины экрана: клиент мог быть отключён, сообщение могло прийти до подписки, а вкладка могла перезагрузиться. При открытии и восстановлении соединения всё равно нужен снимок текущего состояния.
Наблюдение за событиями на сервере; доставка браузеру проектируется отдельно
import { QueueEvents } from 'bullmq';
const events = new QueueEvents('reports', {
  connection: { host: 'redis', port: 6379, maxRetriesPerRequest: null },
});
events.on('progress', ({ jobId, data }) => {
  console.log('progress', jobId, data);
});
events.on('failed', ({ jobId, failedReason }) => {
  console.log('failed', jobId, failedReason);
});
events.on('error', error => console.error('events_error', error.message));
Не рассылайте всем пользователям все jobId и результаты. Проверка владельца требуется и для запроса статуса, и для скачивания, и для подписки на события. Это особенно заметно в многопользовательской CRM: красивый общий список очереди может случайно показать чужую выгрузку. Учебная панель локальная и работает с синтетическими данными; рабочую модель доступа необходимо добавить перед использованием с реальными пользователями.
Официальная документация: События очереди.
Регулярные задачи через Job Schedulers
Периодический пересчёт показателей, очистка временных данных или ежедневная подготовка отчёта относятся к расписанию. В BullMQ 6 для этого используются Job Schedulers. У правила есть устойчивый ID; upsert создаёт или обновляет его. Это удобнее, чем при каждом старте приложения безусловно создавать ещё одно независимое расписание.
Принцип создания ежедневного расписания на 07:00 UTC
await queue.upsertJobScheduler('demo-daily-summary',
  { pattern: '0 0 7 * * *', tz: 'UTC' },
  { name: 'daily-summary', data: { kind: 'demo' },
    opts: { attempts: 3, backoff: { type: 'exponential', delay: 1000 } } },
);
Отдельное действие: удалить расписание, когда оно больше не нужно
await queue.removeJobScheduler('demo-daily-summary');Для знакомства в архиве предусмотрен отдельный ограниченный CLI-пример расписания. Он не включается сам при открытии страницы. Часовой пояс и смысл календарной даты важно задавать явно: ежедневный отчёт за московский день и запуск в 07:00 UTC — разные требования. При изменении времени продумайте, какой период данных должна обработать следующая задача.
Запустить учебное расписание: до трёх отчётов с интервалом 3000 мс
docker compose exec api node scripts/scheduler.mjs start
docker compose exec api node scripts/scheduler.mjs list
Посмотрите на появление задач в локальной панели и дождитесь результата. Скрипт использует устойчивый ключ demo-scheduler и ограничение limit: 3. Он не оставляет бесконечный генератор. Для явного удаления правила после опыта выполните следующую команду отдельно; уже начатую работу она не прерывает.
Завершить опыт с расписанием
docker compose exec api node scripts/scheduler.mjs stopРасписание не резервирует свободный процесс на каждую секунду календаря. Занятая очередь и недоступные workers влияют на фактическое исполнение. Также заранее решите, нужно ли после длительного простоя восстанавливать пропущенные периоды или достаточно последнего состояния. Такие требования относятся к вашему продукту; одна строка cron не описывает все правила восстановления.
Официальная документация: Job Schedulers, Параметры расписания.
Настройка Redis и соединений
Для очереди Redis хранит служебные структуры, которые нельзя произвольно вытеснять как обычный кеш. В проекте задана политика maxmemory-policy noeviction и включён AOF. При нехватке памяти нужно получать понятный сбой и реагировать на него, а не незаметно терять части очереди. Следите за объёмом данных, историей результатов и доступной памятью.
Соединения producer и worker имеют разные ожидания. HTTP-запрос не должен бесконечно зависать при недоступном Redis: producer нужен ограниченный путь отказа. Worker, напротив, обычно ожидает восстановления связи; для ioredis-подключения worker используется maxRetriesPerRequest: null. Blocking-операции и QueueEvents требуют собственных соединений или их дублирования. Это нужно учитывать при лимите подключений хостинга.
AOF и том повышают сохранность, но не заменяют резервное копирование и план восстановления. Настройка everysec допускает потерю последних записей при аварии в пределах соответствующего окна. Для критичных операций нужны требования к допустимой потере данных и повторной сверке с системой учёта. В локальном стенде Redis доступен только внутри сети Compose и не имеет опубликованного порта хоста.
Официальная документация: Соединения с Redis, Сохранение данных Redis, Подготовка к эксплуатации.
Compose: API и worker запускаются отдельно
Отдельные сервисы позволяют перезапускать HTTP-часть и обработчик независимо. Оба используют один образ приложения, но запускают разные команды. Redis хранит очередь в именованном томе. Это делает эксперимент наглядным: остановка worker оставляет задачи в ожидании, а запуск worker позволяет продолжить обработку. Конфигурация ниже взята непосредственно из архива.
Полная конфигурация учебного проекта
name: aen-bullmq
services:
  api:
    build: .
    ports:
      - "127.0.0.1:${APP_PORT:-3098}:3000"
    environment:
      REDIS_HOST: redis
      QUEUE_NAME: aen-workshop
    depends_on:
      redis:
        condition: service_healthy
    healthcheck:
      test: ["CMD", "node", "-e", "fetch('http://127.0.0.1:3000/health').then(r=>process.exit(r.ok?0:1)).catch(()=>process.exit(1))"]
      interval: 5s
      timeout: 5s
      retries: 10
      start_period: 10s
    init: true
    restart: unless-stopped
  worker:
    build: .
    command: ["node", "src/worker.js"]
    environment:
      REDIS_HOST: redis
      QUEUE_NAME: aen-workshop
    depends_on:
      redis:
        condition: service_healthy
    healthcheck:
      test: ["CMD", "node", "src/check-worker.js"]
      interval: 5s
      timeout: 5s
      retries: 10
      start_period: 10s
    init: true
    stop_grace_period: 30s
    restart: unless-stopped
  redis:
    image: redis:8.10.3-alpine
    command: ["redis-server", "--appendonly", "yes", "--appendfsync", "everysec", "--maxmemory-policy", "noeviction"]
    volumes:
      - queuedata:/data
    healthcheck:
      test: ["CMD", "redis-cli", "ping"]
      interval: 5s
      timeout: 3s
      retries: 10
    restart: unless-stopped
volumes:
  queuedata:
Порт 3098 опубликован на 127.0.0.1 и предназначен для локального открытия. Внутри сети контейнеры обращаются к Redis по имени сервиса. Для настоящего сервера дополнительно потребуются авторизация, TLS, сетевые ограничения, лимиты запросов, резервные копии и наблюдение. Не переносите открытую учебную панель управления очередью на публичный адрес без этой части проекта.
Хранение результатов, история и размер Redis
Завершённые задачи полезны для диагностики и экрана истории, но их нельзя бесконечно накапливать вместе с большими результатами. BullMQ позволяет ограничивать сохранение completed и failed записей по количеству и возрасту. Успешные и неудачные операции часто требуют разной глубины истории: ошибку нужно успеть расследовать, а давний готовый файл можно хранить отдельно.
Пример ограниченной истории; значения выбираются под нагрузку и требования проекта
const queue = new Queue('reports', {
  connection: { host: 'redis', port: 6379 },
  defaultJobOptions: {
    removeOnComplete: { age: 24 * 3600, count: 200 },
    removeOnFail: { age: 7 * 24 * 3600, count: 500 },
  },
});
Автоудаление выполняется в рамках обработки событий завершения, поэтому не следует воспринимать age как отдельный точный таймер удаления. И помните связь с jobId: удалённая запись больше не блокирует добавление новой задачи с таким же идентификатором. Долговременное состояние бизнес-операции лучше хранить в собственной модели данных, а очередь использовать для исполнения и наблюдения за работой.
Официальная документация: Хранение завершённых задач.
Остановка worker, блокировки и восстановление
При штатном обновлении worker желательно дать закончить активные задачи и закрыть соединения. Для этого используется await worker.close(). Процесс должен получить сигнал остановки, прекратить брать новую работу и иметь разумное время на завершение. Если контейнер принудительно убить раньше, исполнение может оборваться посередине, что снова возвращает нас к вопросу идемпотентности.
Worker поддерживает блокировку активной задачи. Если процесс погиб или надолго заблокировал event loop, блокировка может быть потеряна, а задача — признана stalled и возвращена к обработке либо завершена ошибкой по правилам восстановления. Stalled не означает просто «задача выполняется долго». Это технический сигнал потери ожидаемого контроля, который нужно расследовать по процессу, нагрузке и журналам.
Тяжёлый синхронный цикл способен мешать продлению блокировки и работе всего worker. Для CPU-задач рассмотрите sandboxed processors или worker threads; для вызовов внешних систем задавайте таймауты и ограничивайте объём. Увеличение времени блокировки без понимания причины может лишь отложить обнаружение зависшего процесса. Учебный проект использует управляемые асинхронные шаги, чтобы демонстрация оставалась наблюдаемой.
Официальная документация: Корректная остановка worker, Потеря блокировки и stalled, Процессы и worker threads.
Что добавить в рабочий сервис: лимиты, зависимости и PHP
Параллельность и ограничение частоты — разные вещи. Первая отвечает за число одновременно выполняемых задач, второе — за допустимое число запусков за период. Если внешняя система разрешает определённую частоту запросов, одного concurrency может быть недостаточно. При этом лимит задач не всегда равен лимиту HTTP-вызовов: одна задача может сделать несколько обращений, и это нужно учитывать отдельно.
Для зависимых операций существуют flows: например, сначала подготовить несколько частей документа, затем собрать общий результат. Разбивать процесс полезно тогда, когда этапы можно независимо повторить и объяснить. Не стоит создавать сложное дерево ради самой библиотеки. Начните с одной очереди, ясного типа задачи и корректного результата; добавляйте зависимость, когда она отражает реальный порядок работы.
BullMQ можно связать и с PHP-сервисом. Текущая документация описывает официальный PHP-клиент для постановки задач; другой путь — контролируемый HTTP API Node.js. В обоих случаях нужны единый контракт данных, проверка доступа и согласованные версии. В этой статье выполняемый пример остаётся на Node.js, поэтому PHP-интеграция рассматривается как направление расширения, а не как отдельно проверенный готовый проект.
Официальная документация: Ограничение частоты задач, Зависимости задач, PHP-клиент BullMQ.
Диагностика: почему задача стоит или повторяется
| Симптом | Что проверить | Что не делать вслепую |
|---|---|---|
| Задачи остаются в ожидании | Worker запущен, имя очереди совпадает, нет паузы | Удалять Redis и всю очередь |
| Каждая попытка снова падает | Причину, входные данные, доступность зависимости | Увеличивать attempts без ограничения |
| Процент не меняется | Вызывает ли processor updateProgress, отвечает ли API | Считать анимацию доказательством обработки |
| Создаются повторные документы | Идемпотентность результата и смысловой ключ | Полагаться только на jobId |
| Задержка истекла, работа не началась | Пауза, нагрузка и доступность worker | Обещать точную секунду запуска |
| Увеличилась память Redis | Историю задач, размеры результатов, retention | Включать вытеснение ключей очереди |
Команды наблюдения и штатного перезапуска учебного worker
docker compose ps
docker compose logs --tail=100 api
docker compose logs --tail=100 worker
docker compose logs --tail=100 redis
docker compose restart worker
В журнале связывайте сообщения одним jobId, но не ограничивайтесь только им. Полезны тип задачи, номер попытки, этап и длительность. Для оценки работы очереди смотрите время ожидания, число активных и неудачных задач, возраст самого старого задания и состояние зависимостей. Нулевой счётчик failed не гарантирует здоровье, если все новые задания часами лежат waiting.
После изменения кода, скопированного в Docker-образ, нужен docker compose up -d --build --wait. Один restart запускает прежний образ. Для HTTP-слоя можно использовать подходы из руководства по Fastify, а сценарии интерфейса — проверять по принципам мастерской Playwright.
Как проверить очередь и что входит в исходники
Проверка полезна, когда подтверждает действие и его результат. Созданный jobId ещё не доказывает работу worker. Completed ещё не доказывает правильное содержимое CSV. Проверяйте всю цепочку: добавление, наблюдаемый прогресс, итоговое состояние, содержимое результата и поведение после сбоя. Для повторов заранее создайте контролируемую ошибку и убедитесь, что число попыток и паузы соответствуют настройкам.
В архив включены тесты и smoke-сценарии. Они используют синтетические данные и отдельную учебную очередь. Проверяются реальные переходы, повторная попытка, окончательная ошибка, задержка, защита от дубля, пауза и ограничение параллельности. Проверки кода без Redis и интеграционный прогон — разные уровни: удачный unit-тест не подтверждает соединения, Lua-операции и сохранность очереди в контейнере.
evidence/http-smoke.json и evidence/lifecycle.json. Браузерная модель проверяется отдельно. Повторите проверки в своей среде после изменения зависимостей, Redis или обработчиков.В проекте есть API, worker, процессоры, панель, учебная модель, примеры конфигурации, Dockerfile, lock-файл, README и лицензии. Начните с запуска без изменений. Затем замените синтетический отчёт на свою небольшую операцию, добавьте понятный результат и проверьте повтор. После этого проектируйте доступ пользователей, хранение документов, наблюдение и восстановление. Так очередь остаётся объяснимой частью сервиса, а не скрытым местом, куда бесследно отправляются запросы.
Открыть мастерскую на весь экран ↗Скачать Node.js-проект и исходники ZIP ↓
Основные источники — официальное руководство BullMQ, репозиторий библиотеки и документация Redis. Ссылки на конкретные возможности расположены рядом с примерами. Для следующего шага полезно взять один реальный сценарий своего сервиса и описать четыре вещи: что считается принятием, как показывается ожидание, где хранится результат и что произойдёт при повторе.