Symfony DomCrawler: HTML и XML в PHP — мастерская и 8 практических задач
Разбираем HTML и XML в PHP: восемь практических задач, шестнадцать вариантов, мастерская с результатами настоящего выполнения, исходники и Linux/VPS.
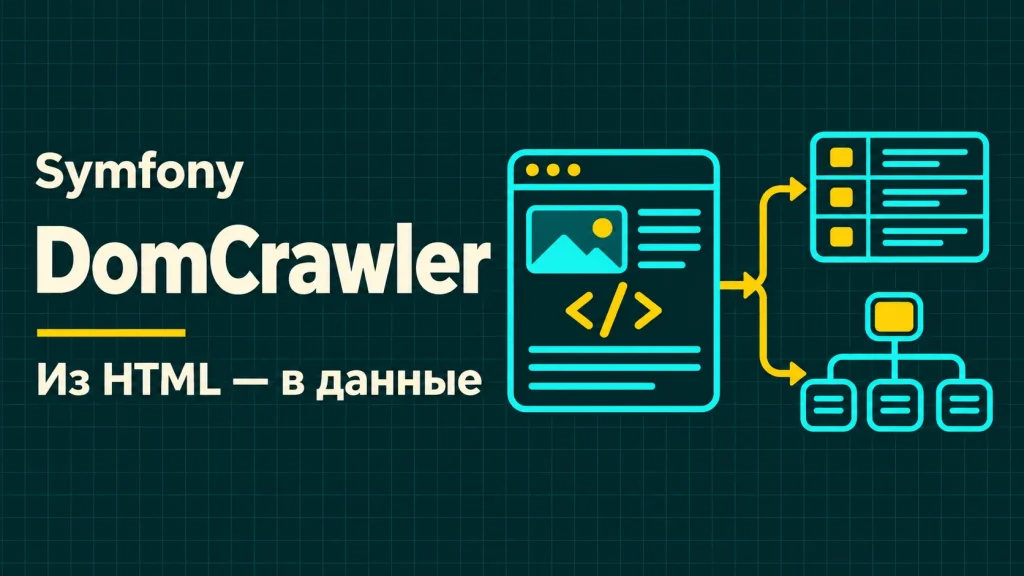
Symfony DomCrawler без фреймворка: HTML/XML в понятные данные. Восемь задач, шестнадцать вариантов, PHP-исходники, мастерская и практика Windows/Linux.
DomCrawler: из HTML-страницы в данные приложения
Иногда нужные данные существуют только в HTML: старый каталог услуг, сохранённая страница отчёта, таблица остатков, письмо с результатами операции или документ внешней системы. Человеку достаточно открыть страницу и прочитать её. Приложению нужны отдельные поля, устойчивые идентификаторы, числа и понятные ошибки. Symfony DomCrawler помогает пройти по структуре HTML или XML и получить именно такие значения.
В этой статье используем компонент самостоятельно, без полного Symfony-приложения. Разберём восемь задач: текст и атрибуты, карточки, таблицы, ссылки, формы, XML, кодировки и нормализацию. Для каждой есть вымышленный исходный документ, настоящий PHP-сценарий и проверенный результат. Можно начать с мастерской, сравнить варианты, посмотреть код и скачать проект.
Цель — получить воспроизводимый небольшой конвейер: прочитать документ, выбрать узлы, проверить поля, сформировать отчёт и только потом передать данные дальше. Такой подход пригодится для миграций, служебных интеграций, тестирования HTML-ответов и обработки собственных выгрузок. Он сохраняет источник и позволяет объяснить, откуда появилось каждое значение.
Где применять: импорт, миграция, контроль и интеграция
Представьте перенос сайта на новую систему. В старой базе уже трудно разобраться, зато сохранены HTML-страницы услуг с заголовком, ценой и кодом. Парсер собирает предварительный список, а проверка отделяет корректные записи от неполных. Редактор получает таблицу спорных строк, разработчик — JSON для дальнейшего импорта. Это практичнее ручного копирования, особенно когда страниц много и процесс нужно повторить.
Другой сценарий — контроль собственной страницы после выпуска. Небольшой тест проверяет наличие названия товара, ожидаемой ссылки, сообщения об ошибке и полей формы. Можно сравнивать серверный HTML с согласованным контрактом, не поднимая полноценный браузер для каждой простой проверки. Если поведение зависит от JavaScript, потребуется другой уровень теста.
В интеграциях без API DomCrawler отвечает за извлечение из уже полученного документа. Он может стать частью процесса, где отдельный HTTP-клиент загружает разрешённую страницу, хранит ответ и передаёт его парсеру. Важно заранее определить право доступа, частоту обновления, признаки успешного результата и действия при изменении разметки. Сама возможность найти селектор ещё не означает готовую устойчивую интеграцию.
Три слоя: загрузить, разобрать, принять результат
Удобно разделить работу на три этапа. Первый получает исходные байты: из файла, HTTP-ответа, очереди или объектного хранилища. Второй разбирает документ и извлекает поля. Третий проверяет бизнес-правила и решает, можно ли сохранять результат в приложение. DomCrawler находится во втором слое. Такое разделение позволяет повторить разбор без нового обращения к внешней системе.
В лаборатории сетевого этапа нет: используются фиксированные HTML/XML-файлы. Поэтому каждый опыт можно воспроизвести независимо от доступности чужого сайта. В реальном проекте полезно хранить безопасный снимок входа вместе с временем получения, идентификатором источника и хешем. Если импорт внезапно вернул пустой массив, вы сможете посмотреть именно тот документ, который обрабатывался.
Третий этап особенно важен. Извлечённая строка «от 8 000 USD» ещё не является рублёвой ценой. Пустая таблица может означать изменение селектора, страницу входа или настоящий пустой набор. Парсер должен дать наблюдаемые факты; решение «заменить весь каталог» принимается после проверки количества, обязательных полей и допустимости изменений.
DomCrawler, DOMDocument, регулярные выражения и Puppeteer
DOMDocument уже входит в PHP при наличии DOM-расширения. Он даёт дерево документа и низкоуровневую работу с узлами. DomCrawler добавляет удобный набор выборок, обходов, извлечения текста, ссылок и форм. В нашей лаборатории это сокращает служебный код вокруг каждой карточки. При этом знания структуры документа остаются полезными: библиотека не угадывает назначение произвольной разметки.
Регулярное выражение подходит для проверки уже извлечённой строки, например формата числа. Но извлекать вложенные карточки и связывать заголовок с ценой удобнее через дерево. Восьмой опыт как раз сочетает оба инструмента: DomCrawler находит элементы, а отдельная функция строго проверяет формат цены. Не приходится превращать один большой шаблон в парсер всей страницы.
Puppeteer нужен, когда требуется настоящий браузер: выполнить JavaScript, дождаться интерфейса, нажать кнопку, переключить вкладку. DomCrawler не исполняет сценарии страницы. Если содержимое появилось только после fetch в браузере, в исходном HTTP-ответе его может не быть. На сайте есть подробная мастерская Puppeteer; эти инструменты удобно выбирать по месту появления нужных данных.
Установка через Composer и версии проекта
В архиве зафиксированы Symfony DomCrawler 7.4.22, CssSelector 7.4.22 и Masterminds HTML5 2.12.0. Ветка 7.4 выбрана для PHP 8.2 и новее. Для проекта нужны расширения dom и mbstring; проверка зависимостей включена в composer.json. Bootstrap 5.3.9 оформляет браузерную мастерскую и хранится локально, поэтому для просмотра не требуется внешний CDN.
При создании своего проекта устанавливают компоненты командой require. В готовом архиве уже есть composer.lock, поэтому используйте install: он воспроизводит согласованные версии. Команда update меняет дерево зависимостей и должна сопровождаться повторением тестов. Автозагрузчик подключается одной строкой; устанавливать полный фреймворк, роутер или контейнер сервисов не требуется.
Если Composer пока непривычен, начните с руководства по зависимостям и командам Composer. Официальное описание независимого компонента находится в документации DomCrawler 7.4. Для примеров этой статьи ориентируйтесь на установленную ветку, а не переносите новые возможности другой версии без проверки.
composer require "symfony/dom-crawler:^7.4" "symfony/css-selector:^7.4"
# В скачанном проекте:
composer install --no-interaction --no-plugins --prefer-dist
composer validate --strict
composer audit
Мини-мастерская: восемь задач и шестнадцать вариантов
Выберите практическую задачу, затем вариант исходного документа. Например, в таблице сравните пустую ячейку с полностью отсутствующей; в карточках переключитесь на изменившийся CSS-класс; в XML поменяйте префикс пространства имён. Ниже находятся вход, полный PHP-файл сценария и полученный результат. Кнопка разбора по шагам последовательно раскрывает эти части.
Мастерская показывает записи настоящего PHP-выполнения. Браузер не запускает PHP, не отправляет формы и не посещает ссылки из документов. Это прямо обозначено в интерфейсе. Поиск в таблице фильтрует уже полученный массив; он не меняет CSS-селектор. Чтобы выполнить свой HTML, скачайте архив, измените фикстуру или используйте готовую CLI-команду.
Можно скачать JSON опыта и CSV результата, скопировать исходный документ и PHP, открыть файлы проекта. Экспорт включает весь текущий вариант, даже если строка поиска скрыла часть записей. В запись входят версии и хеши исходников. Это позволяет связать видимый результат с конкретным кодом и обнаружить случай, когда файл изменили, а запись забыли пересоздать.
Первый запуск в Windows: от архива до результата
Распакуйте проект в отдельный каталог и откройте там PowerShell. Сначала убедитесь, что команды php и composer относятся к нужным установленным версиям. На машине может быть несколько PHP: от веб-сервера, IDE и системного PATH. Команда php –ini покажет активный конфигурационный файл, а php -m — реально загруженные расширения, а не только строки в чужом php.ini.
После установки зависимостей capture выполняет все варианты и записывает результат. Test проверяет данные, границы ввода, CLI-коды и соответствие записи свежему выполнению. Build-public собирает файлы для просмотра исходников. Затем serve открывает локальный сервер на loopback. Перейдите по адресу ниже; открытие HTML через file:// не подходит для загрузки JSON через fetch.
Эти команды не обращаются к внешним бизнес-системам и не требуют паролей. При первом install Composer скачивает открытые зависимости. Если порт занят, выберите другой только для своего сервера и измените адрес в браузере. Для остановки достаточно Ctrl+C в том терминале, где запущен serve; закрывать чужие PHP-процессы не нужно.
php --version
php --ini
php -m
composer install --no-interaction --no-plugins --prefer-dist
composer capture
composer test
composer build-public
composer serve
# http://127.0.0.1:8521
Linux: тот же проект и отдельные расширения PHP
На Ubuntu или Debian CLI-интерпретатор и XML/mbstring обычно устанавливаются отдельными пакетами. Названия ниже относятся к системному PHP выбранного выпуска. Перед установкой проверьте, что его версия не ниже 8.2 и поддерживается вашим окружением. Если на сервере уже работают сайты, установка новой ветки PHP не должна незаметно переключать их PHP-FPM.
Composer запускайте от обычного пользователя проекта. В воспроизводимой проверке архив устанавливался в чистой Linux-среде с Composer 2.11.1 и PHP 8.5.12; Windows-запуск использовал PHP 8.3.33. Оба варианта получили одинаковые данные. Это проверяет переносимость конкретного проекта, но не заменяет приёмку прав, расписания и путей на вашем VPS.
Публичную мастерскую можно раздавать как статические файлы. Для серверного извлечения нужен CLI и закрытый рабочий каталог. Не следует запускать php -S на публичном интерфейсе как постоянный production-сервер: в этой инструкции он служит локальному просмотру. Организация фонового запуска разобрана отдельно ниже.
sudo apt update
sudo apt install php-cli php-xml php-mbstring unzip ca-certificates
php --version
php -m
# Установите Composer 2 по инструкции getcomposer.org.
composer install --no-interaction --no-plugins --prefer-dist
composer capture
composer test
php -S 127.0.0.1:8521 -t public
Опыт 1. Текст и атрибуты без выдуманных значений
В первой задаче извлекаются заголовок заявки, статус и ссылка на отчёт. Один документ содержит все поля, во втором статус и ссылка отсутствуют. Результат сохраняет это различие: неизвестное поле становится null. Подстановка ready по умолчанию была бы удобна для оформления, но исказила бы смысл источника и могла запустить неправильное действие в приложении.
Обратите внимание на text и innerText. В нашем сообщении часть фразы находится внутри strong. Полный текст включает слово из дочернего элемента, непосредственный текст его исключает. Такое различие полезно для подписи, внутри которой есть отдельная метка или дополнительное пояснение. Выбор метода зависит от того, какие части относятся к вашему полю.
Перед attr проверяется наличие узла. Для обязательных полей иногда лучше выбросить отдельную ошибку контракта и остановить импорт. Для необязательных — вернуть null и продолжить. Главное, чтобы это было явное решение: отсутствие элемента, пустая строка и известное значение не должны сливаться в одно состояние.
<?php
use Workshop\Lab;
return static function(string $html, int $variant): array {
    $c = Lab::html($html);
    $link = $c->filter('a.details');
    return ['rows'=>[['title'=>Lab::text($c,'h1'), 'status'=>Lab::text($c,'.status'),
        'href'=>$link->count() ? $link->attr('href') : null]],
        'note'=>'text() объединяет текст потомков; innerText() ниже оставляет только непосредственный текст.',
        'details'=>['allText'=>$c->filter('.message')->text(), 'directText'=>$c->filter('.message')->innerText(), 'linksFound'=>$link->count()]];
};
Пустая выборка: нормальный случай или сломанный контракт
Один и тот же пустой результат может иметь разные причины. В личном кабинете действительно нет заявок; карточки переименовали; сервер вернул страницу входа; текст подгрузился JavaScript; HTML обрезался. Поэтому count, равный нулю, стоит трактовать вместе с контекстом. Для контрольной страницы можно ожидать обязательный заголовок и хотя бы одну служебную метку до разбора списка.
В нашей второй теме вариант с изменённым классом устанавливает needsReview. Он не объявляет исходный документ пустым каталогом. Для реального импорта полезно задать разумные пороги: количество записей, допустимое уменьшение относительно прошлого запуска, долю отклонённых строк. Эти пороги относятся к бизнес-процессу и требуют настройки под источник.
Сохраняйте старое подтверждённое состояние до принятия нового результата. Если очередной разбор дал ноль, поддержке нужны источник, версия селектора и безопасный фрагмент входа, а не только сообщение «импорт завершён». Отдельный статус «требуется проверка» помогает интерфейсу показать понятную причину и предложить повтор после исправления.
Опыт 2. Карточки: сохраняем связь полей
Три карточки услуг содержат ID, название и цену. Выборка начинается с article.service, а уже внутри каждой карточки ищутся h2 и .price. Это важнее, чем кажется: если отдельно собрать все заголовки и отдельно все цены, пропуск одного поля может сместить массивы и приклеить цену соседней услуги. Локальный контекст удерживает поля вместе.
Метод each формирует по одной записи из выбранного узла. В этом опыте цена пока остаётся строкой, потому что задача — показать извлечение структуры. Нормализацию в целые копейки выполняет восьмой сценарий. Такое разделение облегчает диагностику: можно увидеть, был ли неверный текст уже в HTML или ошибка появилась при преобразовании.
Выбирайте селекторы, описывающие смысл, если вы контролируете источник: класс сущности, data-id, data-field. Длинная цепочка из нескольких div и nth-child сильнее зависит от декоративной перестановки. Но даже понятный класс является договорённостью, которую нужно тестировать на сохранённых примерах после обновления сайта.
<?php
use Workshop\Lab;
use Symfony\Component\DomCrawler\Crawler;
return static function(string $html, int $variant): array {
    $c = Lab::html($html);
    $rows = $c->filter('article.service')->each(static fn(Crawler $n) => [
        'id'=>$n->attr('data-id'), 'title'=>Lab::text($n,'h2'), 'priceText'=>Lab::text($n,'.price')]);
    return ['rows'=>$rows,'note'=>count($rows) ? 'Выборка ограничена каждой карточкой: заголовок и цена не смешиваются между записями.' : 'Ожидались карточки, но селектор ничего не нашёл. Не затирайте предыдущий каталог пустым импортом.',
        'details'=>['selector'=>'article.service', 'count'=>count($rows), 'needsReview'=>count($rows)===0]];
};
CSS и XPath: удобство не отменяет контекст
Для простых карточек CSS-селекторы читаются привычно: article.service, h2, атрибут data-field. Компонент CssSelector переводит их в XPath. При сложной структуре или XML можно использовать XPath напрямую. В обоих случаях важно знать, относительно какого набора узлов выполняется следующий шаг, и не превращать локальную выборку в случайный поиск по всему документу.
Селектор в серверном парсере не является состоянием открытого браузера. Здесь нет движения мыши, фокуса пользователя и вычисленного внешнего вида. В наших тестах p:hover не даёт узлы; это не способ узнать, над чем находится курсор. Для семантики поддерживаемых конструкций смотрите CssSelector выбранной версии.
В XML-сценарии есть полезная тонкость: выбранный item становится контекстом вложенной обработки. Мы явно начинаем путь с descendant-or-self::s:item и затем выбираем дочернее имя. Проверка выполняется на обоих вариантах XML. Перед копированием выражения в другой контекст проверьте его на одном узле и на полной коллекции: одинаково выглядящие пути могут давать разные результаты.
$cards = $crawler->filter('article.service');
foreach ($cards as $element) {
    $card = new Crawler($element);
    $title = $card->filter('h2')->text();
}
// XML, когда текущая выборка — item:
$name = $item->filterXPath('descendant-or-self::s:item/s:name')->text();
Опыт 3. Таблица: ноль, пустая ячейка и пропуск
В таблице остатков три товара. У первого известное положительное количество, у второго — ноль, у третьего значение неизвестно. Варианты отличаются причиной: ячейка присутствует, но пуста, либо её вообще нет. Результат хранит stock и sourceState. Это позволяет интерфейсу показать «нет данных», не выдавая неизвестный остаток за отсутствие товара.
Поля выбираются по data-field. Если убрать одну ячейку, следующий столбец не начнёт считаться остатком только из-за позиции. Для сторонней таблицы таких атрибутов может не быть: тогда потребуется сопоставление заголовков и явная проверка структуры. Таблицы с rowspan и colspan требуют дополнительной нормализации сетки; текущий опыт не обещает автоматически разобрать любой визуальный отчёт.
Проверьте строгий формат числа до преобразования. Простое приведение произвольной строки к int способно скрыть ошибку. В нашем контракте допустимы только неотрицательные целые цифры. Единицы измерения и дробные количества потребуют другого правила. Это правило следует записать рядом с типом поля, а не держать в голове автора импорта.
<?php
use Workshop\Lab;
use Symfony\Component\DomCrawler\Crawler;
return static function(string $html, int $variant): array {
    $rows = Lab::html($html)->filter('tbody tr')->each(static function(Crawler $row) {
        $raw = Lab::text($row,'[data-field="stock"]');
        return ['id'=>$row->attr('data-id'), 'name'=>Lab::text($row,'[data-field="name"]'),
            'stock'=>$raw!==null && preg_match('/\A\d+\z/',$raw) ? (int)$raw : null,
            'sourceState'=>$raw===null ? 'cell_missing' : ($raw==='' ? 'empty' : 'value')];
    });
    return ['rows'=>$rows,'note'=>'Нулевой остаток — число 0. Пустая или отсутствующая ячейка — null с отдельной причиной.', 'details'=>['unknown'=>count(array_filter($rows,fn($r)=>$r['stock']===null))]];
};
Опыт 4. Ссылки: получить адрес не значит его посетить
Вход содержит путь к файлу через .., путь от корня, query-параметр и абсолютную ссылку. Crawler получает базовый URI документа и разрешает адреса относительно него. Благодаря этому очередь будущей загрузки может хранить полный URL. Без корректной базы относительный путь теряет связь с исходной страницей и легко приводит к неправильному запросу.
Второй вариант добавляет mailto, JavaScript и другой host. Пример отдельно выставляет allowedForQueue по схеме и имени узла. Все адреса остаются текстом: мастерская не выполняет переходов и не отправляет сетевых запросов. Так читатель видит границу между извлечением ссылки и решением приложения о дальнейшем действии.
Проверка host в этом фрагменте предназначена для демонстрации отбора, а не для универсальной защиты сетевого клиента. При реальном скачивании нужно учитывать редиректы, DNS, внутренние IP, объём ответа и разрешённые источники. Лучше заранее ограничить набор интеграций, чем принимать произвольный URL от посетителя публичного endpoint.
<?php
use Workshop\Lab;
use Symfony\Component\DomCrawler\Crawler;
return static function(string $html, int $variant): array {
    $rows = Lab::html($html)->filter('a')->each(static function(Crawler $n) {
        $uri = $n->link()->getUri();
        $parts = parse_url($uri);
        $allowed = in_array(strtolower($parts['scheme']??''),['https','http'],true)
            && strtolower($parts['host']??'') === 'demo.invalid'
            && !isset($parts['user']) && !isset($parts['pass']);
        return ['text'=>$n->text(), 'raw'=>$n->attr('href'), 'resolved'=>$uri, 'allowedForQueue'=>$allowed];
    });
    return ['rows'=>$rows,'note'=>'Crawler разрешает URI. Решение о допустимом host и схеме принимает приложение. Опыт не выполняет HTTP-загрузку.', 'details'=>['base'=>'https://demo.invalid/catalog/page.html']];
};
Опыт 5. Формы: поля, выбор варианта и отсутствие отправки
Форма расчёта содержит email, тариф, checkbox, disabled-поле и кнопку. Сначала мастерская показывает исходный набор, затем вариант с изменённым адресом, тарифом team и отмеченным checkbox. В details видны метод, разрешённый action и вложенные PHP-значения. Это удобно для интеграционных тестов HTML-форм или анализа контракта старого интерфейса.
Form умеет подготовить значения, но сам по себе не выполняет HTTP-запрос. В проекте нет скрытого вызова submit или внешнего сервиса. Это позволяет безопасно исследовать структуру на вымышленной странице. Для настоящей отправки нужен отдельный клиент, корректная сессия и правила приложения, включая CSRF, права и допустимость побочных эффектов.
Посмотрите, какие поля отсутствуют в результате: disabled не отправляется, неотмеченный checkbox тоже. Если сервер ожидает отдельное значение false, его обработка должна быть предусмотрена в вашем контракте. Нельзя автоматически считать, что все видимые в HTML input обязательно попадут в набор отправляемых полей.
<?php
use Workshop\Lab;
return static function(string $html, int $variant): array {
    $form = Lab::html($html)->selectButton('Рассчитать')->form();
    if ($variant===1) {
        $form['order[email]']='demo@example.invalid';
        $form['order[plan]']->select('team');
        $form['order[newsletter]']->tick();
    }
    $values = $form->getPhpValues();
    $rows=[];
    foreach ($form->getValues() as $name=>$value) $rows[]=['field'=>$name,'value'=>$value];
    return ['rows'=>$rows,'note'=>'Данные только сформированы. HTTP-клиент и отправка не вызываются. Disabled-поле не входит в successful controls.',
        'details'=>['method'=>$form->getMethod(),'uri'=>$form->getUri(),'phpValues'=>$values]];
};
Опыт 6. XML: важен URI пространства имён
XML-выгрузка содержит два элемента услуги. В первом документе используется префикс svc, во втором ext. При этом URI пространства имён одинаковый. Мы регистрируем собственный префикс s и используем его в XPath, поэтому оба документа дают одинаковые записи. Это помогает пережить косметическую смену префикса у поставщика без переписывания логики.
Сумма в XML уже передаётся целым числом копеек по контракту нашего примера. В производственном импорте тип и диапазон всё равно проверяются до записи. Атрибут ID и вложенное имя извлекаются отдельно. Не следует удалять namespace из текста регулярной заменой только ради короткого запроса: можно потерять различие между одинаковыми локальными именами из разных словарей.
Загрузчик лаборатории отвергает DTD и ENTITY, использует DOMDocument с LIBXML_NONET и восстанавливает прежний режим ошибок libxml. Такая политика соответствует нашим небольшим фиксированным документам. Если вашему обмену действительно нужны другие возможности XML, требования нужно обсуждать отдельно и проверять парсер именно для этого формата.
<?php
use Workshop\Lab;
use Symfony\Component\DomCrawler\Crawler;
return static function(string $xml, int $variant): array {
    $c = Lab::xml($xml);
    $c->registerNamespace('s','urn:aen:services');
    $rows = $c->filterXPath('//s:item')->each(static function(Crawler $n) {
        $n->registerNamespace('s','urn:aen:services');
        return ['id'=>$n->attr('id'),'name'=>$n->filterXPath('descendant-or-self::s:item/s:name')->text(),
            'amountMinor'=>(int)$n->filterXPath('descendant-or-self::s:item/s:amount')->text()];
    });
    return ['rows'=>$rows,'note'=>'Собственный префикс s связан с URI пространства имён; написание префикса в исходном XML несущественно.',
        'details'=>['namespace'=>'urn:aen:services','xpath'=>'//s:item']];
};
Опыт 7. Незакрытые теги и старая кириллица
HTML бывает несовершенным: в первом варианте закрывающие теги li отсутствуют, но HTML5-парсер восстанавливает список и возвращает три пункта. Это удобно при обработке старых страниц, однако исправление дерева не является доказательством корректности документа. Вы получите структуру после разбора, которая иногда отличается от буквальной вложенности исходной строки.
Второй файл физически записан в Windows-1251. Загрузчик получает явную кодировку, а результат JSON сохраняется в UTF-8. В браузере исходник показан после преобразования для удобства чтения; запись содержит исходный charset и SHA-256 реальных байтов. Так можно отличить отображаемый текст от файла, который поступил в PHP.
Не пытайтесь лечить любую «кракозябру» последовательными преобразованиями наугад. Сначала установите кодировку источника из контракта, корректного заголовка или спецификации выгрузки. Повторная перекодировка уже испорченных данных не возвращает потерянные символы. Сохранение исходных байтов помогает повторить диагностику после исправления настройки.
<?php
use Workshop\Lab;
use Symfony\Component\DomCrawler\Crawler;
return static function(string $html, int $variant): array {
    $charset = $variant===1 ? 'Windows-1251' : 'UTF-8';
    $c = Lab::html($html,$charset);
    $rows = $c->filter('li')->each(static fn(Crawler $n)=>['name'=>$n->text()]);
    return ['rows'=>$rows,'note'=>$variant===1 ? 'Исходные байты Windows-1251 переданы с явной кодировкой. JSON результата — UTF-8.' : 'HTML5-парсер восстановил незакрытые li. Это не проверка корректности всего документа и не очистка опасного HTML.',
        'details'=>['charset'=>$charset,'count'=>count($rows)]];
};
Опыт 8. Нормализация цен и отчёт об отклонённых строках
В последнем опыте извлечение превращается в подготовку данных для приложения. Цена с пробелами, неразрывным пробелом, запятой и знаком рубля проверяется отдельной функцией. Результат хранится целым числом копеек: 1 250,50 становится 125050. Нулевая цена остаётся допустимым нулём. Строка с другой валютой или произвольным префиксом не угадывается, а отклоняется.
Кроме формата цены проверяются ID, название и повтор идентификатора. В ошибочном варианте одна запись принимается, две попадают в errors с причиной. Это позволяет показать отчёт оператору и принять решение о частичном импорте или полной остановке. Лаборатория не выбирает такую политику за ваше приложение и не пишет результат в базу.
Для сложных бизнес-правил лучше вынести DTO и отдельную валидацию. На сайте есть материал о Symfony Validator. Здесь правила нарочно компактны, чтобы связь между HTML, извлечённой строкой и итоговым типом оставалась очевидной.
<?php
use Workshop\Lab;
use Symfony\Component\DomCrawler\Crawler;
return static function(string $html, int $variant): array {
    $rows=[]; $errors=[]; $seen=[];
    foreach (Lab::html($html)->filter('article.service') as $element) {
        $n = new Crawler($element);
        $id = $n->attr('data-id');
        $title = Lab::text($n,'h2');
        $price = Lab::text($n,'.price');
        $minor = $price!==null ? Lab::minor($price) : null;
        if (!$id || isset($seen[$id]) || !$title || $minor===null) {
            $errors[]=['id'=>$id,'reason'=>isset($seen[$id]) ? 'duplicate_id' : 'invalid_fields']; continue;
        }
        $seen[$id]=true;
        $rows[]=['id'=>$id,'title'=>$title,'amountMinor'=>$minor,'currency'=>'RUB'];
    }
    return ['rows'=>$rows,'note'=>'Строковые цены преобразованы в целые копейки. Ошибочные записи отделены; в БД ничего не записывается.',
        'details'=>['accepted'=>count($rows),'rejected'=>count($errors),'errors'=>$errors]];
};
JSON и CSV: результат должен сохранить смысл
JSON удобен для следующего машинного этапа: числа остаются числами, null не превращается в пустую строку, а рядом можно сохранить причины отклонения. CSV подходит для ручного просмотра и передачи в табличный редактор, но требует явного соглашения о разделителе, кодировке и интерпретации пустых значений. В мастерской CSV начинается с UTF-8 BOM для удобства некоторых настольных программ.
Строки, начинающиеся с символов формул, получают защитный апостроф перед записью в CSV. В нашем ошибочном варианте название начинается со знака равенства, поэтому различие можно увидеть непосредственно. Это мера для экспорта в таблицы; исходное значение JSON сохраняется. Не стоит незаметно менять бизнес-данные только ради одного способа отображения.
Поиск в интерфейсе не меняет экспорт. Кнопки скачивают полный результат выбранного варианта, а не случайно видимые строки. Такое поведение подписано рядом с управлением. В рабочем сервисе полезно предлагать отдельные действия «все результаты» и «по текущему фильтру», если оба режима действительно нужны пользователям.
// PHP 8.2+: escape задан явно, строки завершает LF.
fputcsv($stream, $headers, ',', '"', '', "\n");
fputcsv($stream, $values, ',', '"', '', "\n");

$json = json_encode($result,
    JSON_PRETTY_PRINT | JSON_UNESCAPED_UNICODE | JSON_THROW_ON_ERROR);
Готовая CLI-команда для собственного HTML-файла
В архиве есть bin/extract.php. Он принимает локальный UTF-8 HTML размером до одного MiB, использует нормализацию восьмого сценария и выдаёт JSON. Это уже рабочая точка входа для небольшого импорта, а не только фрагмент внутри статьи. Для другой разметки измените селекторы и контракт, добавьте обезличенную фикстуру и повторите тесты.
Без output результат идёт в stdout. С параметром output команда создаёт временный файл в выбранном каталоге и заменяет целевой JSON через rename. Каталог должен существовать. Не указывайте важный файл в качестве учебного вывода: команда явно предназначена для замены указанного отчёта. Входной документ при этом не изменяется.
Код завершения помогает расписанию и CI: ноль означает принятую непустую выборку, два — отклонённые строки или пустой результат, единица — ошибку чтения или выполнения. При коде два отчёт сохраняется для разбора, но его нельзя автоматически считать готовой заменой каталога. Сначала проверяется статус, затем выполняется следующий этап.
# PowerShell:
New-Item -ItemType Directory -Force .runtime | Out-Null
php bin/extract.php --input fixtures/cards.html --output .runtime/services.json
$LASTEXITCODE

# Bash:
mkdir -p .runtime
php bin/extract.php --input fixtures/cards.html --output .runtime/services.json
echo $?
Подключение HTTP-клиента: сохранить границы ответственности
Когда источник находится в сети, сначала получите ответ контролируемым клиентом, проверьте статус и размер, сохраните нужные метаданные, а затем передайте тело парсеру. Для PHP на сайте есть практическое руководство по Guzzle. Не смешивайте поиск селектора с повторами запросов и обработкой авторизации в одном длинном блоке.
Например, сетевой слой может сохранить разрешённый HTML в закрытый input.html, после чего отдельная CLI-задача сформирует отчёт. Если селектор сломается, повторные попытки парсинга не создадут лишнюю нагрузку на источник. Если источник недоступен, сохранённый предыдущий документ остаётся материалом для диагностики, но должен быть помечен своим временем получения.
Ограничивайте таймауты, размер, число редиректов и источники. При авторизованных ответах храните cookies и токены отдельно от логов и публикуемых фикстур. Тестовые данные для статьи следует обезличить, а не выдавать реальный кабинет за демонстрацию. Этот проект специально не содержит универсального HTTP endpoint для произвольных URL.
Linux/VPS: код, вход и отчёты вне web-root
На выделенном или облачном сервере парсер удобно запускать отдельным служебным пользователем. Код находится в /opt/domcrawler, вход и отчёты — в /var/lib/domcrawler. Пользователю достаточно читать проект и писать в рабочий каталог. Публичная папка сайта не должна одновременно служить складом приватных HTML-выгрузок, логинов или результатов клиентов.
Команды ниже создают пример такой структуры. Перед chown проверьте точные каталоги: операция относится только к этому новому проекту. Composer устанавливает зависимости от служебного пользователя, а не от root. Путь к PHP и доступность расширений проверяются в той же среде, где будет запускаться команда по расписанию.
Первый запуск выполняйте на вымышленном cards.html. Проверьте файл отчёта и код завершения, затем заменяйте источник на свой. Развёртывание включает не только «процесс стартовал», но и права, ограничение размера, место хранения, наблюдаемость и понятную процедуру повторного запуска. Полный runbook находится в docs/LINUX-VPS.md архива.
sudo useradd --system --home /opt/domcrawler --shell /usr/sbin/nologin domcrawler
sudo install -d -o domcrawler -g domcrawler -m 0750 /opt/domcrawler
sudo install -d -o domcrawler -g domcrawler -m 0750 /var/lib/domcrawler
# Скопируйте проект в /opt/domcrawler и проверьте путь:
sudo chown -R domcrawler:domcrawler /opt/domcrawler
cd /opt/domcrawler
sudo -u domcrawler composer install --no-dev --no-interaction --no-plugins --prefer-dist
sudo -u domcrawler php bin/extract.php --input fixtures/cards.html --output /var/lib/domcrawler/services.json
Systemd: расписание с наблюдаемым результатом
Для ежедневной обработки подготовленного файла можно использовать oneshot service и timer. Служба запускает один CLI-процесс, ограничивает время и память, а журнал хранит код завершения. Пример предполагает, что отдельный контролируемый этап уже подготовил /var/lib/domcrawler/input.html. Получение файла из сети здесь не скрыто внутри запуска.
Пределы времени и памяти являются начальными настройками примера, а не универсальной нормой. Измерьте реальный размер документа и поведение своего парсера. Если нормальный вход требует больше ресурсов, пересмотрите бюджет осознанно; если внезапно вырос в десятки раз, сначала выясните причину. DOM-модель удерживает дерево в памяти, поэтому большие выгрузки требуют отдельного подхода.
После первого ручного systemctl start проверьте status, journalctl и JSON. Только потом включайте timer. Ошибка с кодом два должна оставаться заметной, даже если часть строк успешна. Один timer не создаёт второй активный экземпляр той же service, однако ручной PHP и другие пути запуска могут работать параллельно. Координация таких путей — отдельная задача, например Symfony Lock.
[Service]
Type=oneshot
User=domcrawler
Group=domcrawler
WorkingDirectory=/opt/domcrawler
ExecStart=/usr/bin/php bin/extract.php --input /var/lib/domcrawler/input.html --output /var/lib/domcrawler/services.json
NoNewPrivileges=true
PrivateTmp=true
ProtectSystem=strict
ReadWritePaths=/var/lib/domcrawler
TimeoutStartSec=60
MemoryMax=256M
UMask=0027
Отладка: что проверять, когда данных нет
Начните с фактического входа. Это HTML нужной страницы, JSON ошибки, пустое тело или форма авторизации? Затем проверьте кодировку, базовый URI и количество узлов на каждом шаге. Полезно временно вывести count для карточек, затем для обязательных полей внутри первой карточки. Так быстрее понять, где именно исчезает ожидаемая структура.
Если поля сместились, ищите выборку по порядковому номеру и независимое объединение массивов. Если ссылки ведут не туда, сравните базовый адрес, тег base и редиректы сетевого этапа. Если XML ничего не возвращает, проверьте namespace URI и контекст XPath. Если символы повреждены, сравните исходные байты и заявленную кодировку до любых преобразований.
Не исправляйте результат ручным редактированием recording.json. Исправьте исходник или контракт, добавьте тест и повторите capture. Иначе интерфейс покажет удобную картинку, которая больше не соответствует PHP. Для собственной системы полезнее сохранить ошибочный документ как отдельную обезличенную регрессионную фикстуру.
Проверки, исходники и практический следующий шаг
Проект прошёл по 97 проверок в Windows и чистой Linux-среде. Проверяются реальные значения, ноль и null, контекст карточек, разрешение ссылок, поля формы, XML-префиксы, кодировка, цены, CSV, отказ от DTD, пути фикстур и коды CLI. Кроме того, каждая записанная попытка сравнивается со свежим выполнением, а файлы — с сохранёнными SHA-256. Результаты восьми тем и шестнадцати вариантов совпали между системами.
Эти проверки относятся к приложенному проекту. Они не означают, что любой чужой сайт сохранит разметку, что arbitrary HTML безопасен для вывода или что ваш production VPS уже настроен. В браузере вход и код отображаются текстом, без исполнения HTML. При переносе данных в собственный интерфейс продолжайте экранировать вывод и проверять назначение ссылок.
Скачайте архив и выберите один реальный небольшой документ, который вы вправе обрабатывать. Сначала определите поля и неизвестные значения, затем замените фикстуру и селекторы, добавьте ожидаемый результат в тест. Сохраните отдельный отчёт до записи в приложение. Для дальнейшей справки пригодятся DOMDocument, работа с кодировками PHP и официальная документация компонентов, указанная выше.
composer capture
composer test
composer build-public

# Проверить отрицательный вариант:
php bin/extract.php --input fixtures/cards-invalid.html
# Ожидаемый код завершения: 2, причина в details.errors.

# Остановка локального просмотра: Ctrl+C.
# Остановка своего расписания на VPS:
sudo systemctl disable --now domcrawler-import.timer