fast-xml-parser: XML и JSON — мастерская и 9 задач для интеграций
Разбираем и собираем XML по-настоящему: девять задач, редактируемые документы, настройки, ошибки, экспорт и Node.js CLI для Windows/Linux.
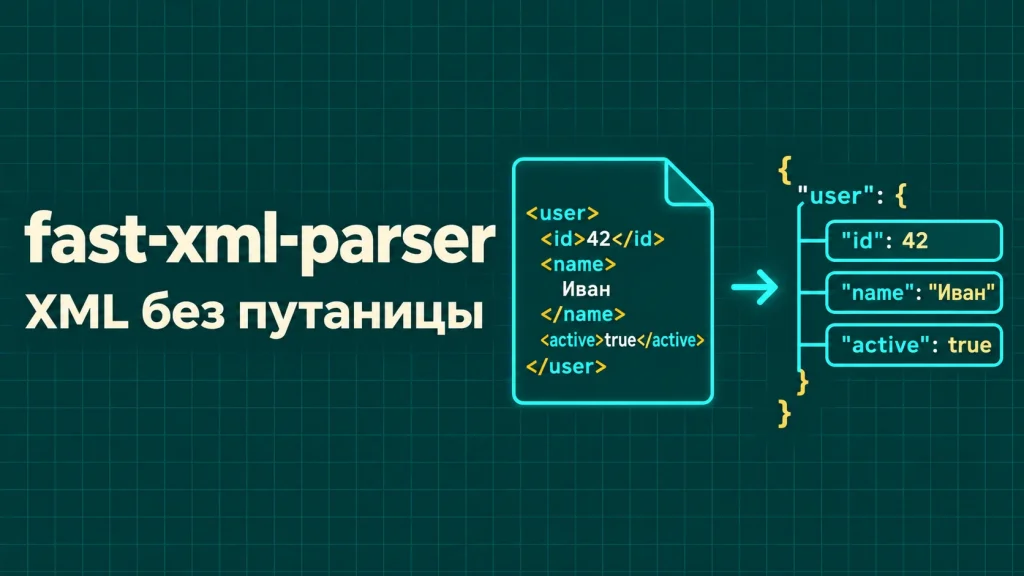
XML и JSON в реальных интеграциях: атрибуты, массивы, строки, namespaces, CDATA, ошибки и обратная сборка. Девять задач, девятнадцать вариантов и настоящий браузерный runtime.
fast-xml-parser: из документа в понятные данные
Поставщик прислал каталог в XML, платёжная система вернула документ, партнёр ожидает заказ в определённой структуре. Для приложения это ещё не готовые товары, платежи и заявки, а текст с тегами, атрибутами и правилами представления значений. Его нужно прочитать, проверить и превратить в модель, с которой сможет работать ваш код.
fast-xml-parser помогает пройти этот путь в JavaScript и Node.js. Библиотека разбирает XML в JavaScript-объекты; в закреплённой версии также доступны проверка синтаксиса и обратная сборка XML. Вместо ручного поиска подстрок вы получаете явную структуру: поля, вложенные элементы и коллекции. Настройки позволяют управлять атрибутами, массивами, типами значений и порядком узлов.
Ниже — девять задач и девятнадцать исходных вариантов. Это настоящая мастерская: меняйте текст, включайте параметры, запускайте обработку и скачивайте результат. Тот же адаптер работает в Node.js CLI. В исходниках есть тесты, инструкции Windows/Linux и практический пример запуска импорта на VPS. Все названия и документы учебные.
Где применять: каталог, заказ, обмен и диагностика
Первое полезное применение — импорт каталога. Артикул из атрибута становится внешним идентификатором, название — строкой модели, количество проходит проверку диапазона. Можно показать оператору все ошибки файла до записи в базу. Это удобнее ситуации, когда первая половина товаров обновилась, а на середине документ оказался непригодным.
Второе применение — формирование исходящего заказа. Ваш сервис собирает обычный объект из проверенных данных, а XMLBuilder превращает его в текст для партнёра. В именах компаний встречаются амперсанды, в комментариях — знаки сравнения. Правильное экранирование значений избавляет от части ошибок, которые легко получить при склеивании строк вручную.
Ещё один сценарий — инструмент поддержки интеграций. Внутренний кабинет принимает небольшой образец документа, показывает дерево, выбранные настройки и путь до проблемного поля. Разработчик и оператор обсуждают конкретные данные. При этом формат XML не определяет транспорт: файл может приходить через HTTP, SFTP, очередь или загрузку в кабинете. Получение и авторизация отправителя остаются отдельными этапами.
Парсер, валидатор и контракт решают разные задачи
XMLParser отвечает за представление документа в JavaScript. XMLValidator ищет синтаксические проблемы: например, когда открывающий тег title закрывается как name. Наш контракт импорта проверяет уже смысл полученных полей: допустим ли ID, присутствует ли название, находится ли количество в нужном диапазоне.
Эти уровни нельзя подменять друг другом. Документ с отрицательным остатком может быть корректным XML. Объект с красивыми ключами может содержать товар другой организации. Успешная сборка XML также не подтверждает, что партнёр примет его по своей XSD или бизнес-правилам. Для интеграции нужны согласованные требования к структуре и данным.
Если задача состоит в выборе узлов документа через CSS/XPath на PHP, полезно сравнить подход со статьёй про Symfony DomCrawler. Здесь мы изучаем другой рабочий путь: XML превращается в объект, затем приложение явно проверяет этот объект. Ни один из вариантов сам по себе не создаёт права доступа к данным.
Версии, зависимости и дальнейшее развитие API
В проекте закреплены fast-xml-parser 5.12.1, Bootstrap 5.3.9 и esbuild 0.28.2. Для проверки интерфейса используется JSDOM 31.0.1. Версии сверены 13 ноября 2026 года; package-lock.json сохраняет точные зависимости и integrity. Для повторения выбран Node.js 24 LTS, не ниже 24.15.0 с учётом средств тестирования.
Важная особенность актуального проекта: авторы выделяют builder и validator в самостоятельные пакеты. В проверенной версии 5.12.1 экспорты XMLBuilder и XMLValidator ещё работают; именно они использованы и протестированы в архиве. При переходе на следующую major-версию проверьте рекомендации по миграции, вместо механической замены номера пакета. Эти изменения описаны в официальном репозитории и заметке о выделении builder.
Авторский код и перечисленные зависимости распространяются по MIT; тексты лицензий находятся в архиве. Браузерная сборка лежит локально рядом с мастерской и не загружает библиотеку с CDN при каждом запуске. Это позволяет проверить именно тот набор файлов, который вы скачали.
Мини-мастерская: измените документ и сравните результат
Выберите задачу и исходный вариант. При переключении примера обработка запускается автоматически. После собственного изменения текста или настройки нажмите кнопку разбора: старый результат скрывается, чтобы его нельзя было принять за результат нового документа. Ошибка также заменяет предыдущее состояние.
В обычных XML-задачах доступны две вкладки. «Ваши настройки» показывает выбранную конфигурацию, «Базовый разбор» — контрольное выполнение того же XML со скрытыми атрибутами и автоматическим распознаванием типов текста. Это два настоящих запуска, а не заранее нарисованное сравнение. Полный набор параметров можно раскрыть ниже.
Библиотека выполняется в Worker вашего браузера. Документ не отправляется на сервер и не сохраняется в localStorage. Исходники подгружаются как статический JSON; это отдельный запрос за кодом проекта, без содержимого редактора. Скачивание результата сохраняет наблюдение вместе с настройками, а кнопка исходного документа возвращает именно введённый XML или JSON. Для длительной работы откройте мастерскую на весь экран.
Быстрый старт в Windows и PowerShell
Распакуйте архив, откройте PowerShell в каталоге проекта и проверьте установленную версию Node. Для готовой мастерской достаточно встроенного сервера: он использует стандартные модули Node. Установка npm-зависимостей потребуется для CLI, изменения реализации, пересборки и тестов.
Команда npm ci использует lock-файл. Флаг ignore-scripts запрещает установочные сценарии пакетов; проект с этой командой действительно проверен. После сборки откройте http://127.0.0.1:8542. Сервер слушает loopback и завершается через Ctrl+C. Двойной клик по index.html не заменяет HTTP-запуск: Worker и просмотр исходников зависят от правил браузера для локальных файлов.
Если порт занят, задайте другой через $env:PORT. Не останавливайте неизвестный процесс ради учебной мастерской. В PowerShell переменная среды задаётся отдельно; запись PORT=8642 перед командой относится к Bash. Весь ZIP уже содержит исходники, поэтому локальная копия не зависит от повторного скачивания архива с сайта.
node --version
npm ci --ignore-scripts --no-audit --no-fund
npm run build
npm test
npm run serve
# Другой порт, если нужен:
$env:PORT = '8642'
npm run serve
Linux и воспроизводимый запуск в контейнере
На Linux используйте тот же package-lock.json и выполните отдельную установку зависимостей. Копировать node_modules с Windows не нужно: инструменты сборки могут включать файлы конкретной платформы. Версии Node в наших проверках различались в пределах ветки 24, а исходники, результаты и готовая браузерная сборка совпали.
Для CLI в проекте есть Dockerfile с Node 24.22.2-bookworm-slim. Он ставит только production-зависимости, запускает процесс под пользователем node и не открывает сетевые порты. Встроенный пример можно выполнить с отключённой сетью контейнера: XML читается из локального файла. Для своего файла используйте bind mount только на чтение и проверьте права доступа.
Если Docker пока незнаком, пригодится наша мастерская Docker Compose. Здесь контейнер решает узкую задачу воспроизводимого Node-окружения; он не превращает проверенный документ в применённое изменение базы. Сам импорт необходимо спроектировать отдельно.
npm ci --ignore-scripts --no-audit --no-fund
npm run build
npm test
PORT=8642 npm run serve
# Отдельный запуск CLI без публикации портов:
docker build -t aen-xml-lab:1 .
docker run --rm --network none aen-xml-lab:1 arrays fixtures/arrays.xml
Задача 1. Атрибуты: сохранить внешний ID
В каталоге товар может иметь атрибут id и дочерние элементы title, qty. Если игнорировать атрибуты, название и количество останутся, но ключ для сопоставления с существующей записью исчезнет. Такой результат выглядит правдоподобно, поэтому ошибка часто обнаруживается лишь на этапе обновления товаров.
Включённое ignoreAttributes:false сохраняет атрибуты. Префикс @_ делает различие заметным: свойство @_id относится к атрибуту, а id — к дочернему элементу. Во втором варианте мастерской присутствуют оба. Это помогает увидеть, почему произвольное удаление префикса может создать неоднозначный контракт.
Оставляйте правила сопоставления рядом с кодом импорта. Например, внешний ID всегда берётся из @_id, а внутренний ID базы создаётся приложением. Не используйте первый попавшийся похожий ключ. Для воспроизведения детали переключите сохранение атрибутов и изучите обе вкладки результата на одном документе.
import { XMLParser } from 'fast-xml-parser';
const parser = new XMLParser({
  ignoreAttributes: false,
  attributeNamePrefix: '@_',
  parseTagValue: false,
  parseAttributeValue: false
});
const data = parser.parse('<product id="00125"><id>supplier-42</id></product>');
// data.product['@_id'] === '00125'
// data.product.id === 'supplier-42'
Задача 2. Один элемент и коллекция
XML не содержит отдельного маркера массива. Один product может превратиться в объект, а два соседних product — в массив. Тогда потребителю приходится проверять форму значения перед каждым обходом. Ошибка особенно неприятна, когда тестовый каталог содержал много товаров, а первый реальный файл содержит ровно один.
Для известных коллекций задайте isArray по точному пути. В нашем контракте это catalog.product. Правило не распространяется на любой элемент с названием product в произвольном месте документа. Такая точность защищает от случайного изменения структуры вложенных объектов при расширении формата поставщика.
Отдельно решите вопрос пустого каталога. isArray не создаёт отсутствующий тег: значение product может отсутствовать целиком. Нужно явно выбрать поведение приложения — считать файл пустой партией, отклонять его или применять специальную операцию очистки. Последний вариант особенно опасно получать случайно из отсутствующего поля, поэтому мастерская не трактует пустой документ как команду удаления.
const parser = new XMLParser({
  ignoreAttributes: false,
  parseTagValue: false,
  isArray: (_name, path, _leaf, isAttribute) =>
    !isAttribute && path === 'catalog.product'
});
const data = parser.parse('<catalog><product id="00125"/></catalog>');
// Array.isArray(data.catalog.product) === true
Задача 3. Строковые ID и осмысленное преобразование типов
Артикул 00125 и число 125 похожи визуально, но означают разные данные. Почтовые индексы, номера договоров и внешние идентификаторы также могут иметь ведущие нули. Если преобразовать их в числа на входе, восстановить исходную запись из одного результата уже нельзя.
Практичный подход — сначала оставить текст строками, затем преобразовать поля по контракту. Количество становится целым числом после проверки диапазона, дата разбирается по согласованному формату, сумма переводится в используемую приложением денежную модель. Формат документа не сообщает, какие значения являются идентификаторами, а какие участвуют в арифметике.
Во втором варианте есть большой ID 9007199254740993. В строковом режиме он сохраняется точно. Не стройте контракт на случайном поведении автоматического распознавания конкретной версии: явное правило понятнее при обновлении зависимости. В мастерской числовой режим можно включить отдельно и увидеть фактическое решение библиотеки на каждом поле. Текст true также показывает, что преобразование касается не только цифр.
const parser = new XMLParser({
  parseTagValue: false,
  parseAttributeValue: false
});
const data = parser.parse('<invoice><id>00125</id><amount>1490.50</amount></invoice>');
// id и amount пока строки.
// Тип и масштаб суммы проверяет контракт приложения.
Задача 4. Namespaces и коллизии имён
Документ может объединять данные нескольких систем. В примере s:item обозначает остаток, а p:item — цену. После удаления префиксов оба имени превращаются в item; библиотека может объединить значения в коллекцию. Вы получите синтаксически допустимый объект, но потеряете ясное различие между двумя предметными смыслами.
Поэтому removeNSPrefix — настройка под известный формат, а не универсальное упрощение. В мастерской видно, как результат меняется при её включении. Второй вариант показывает обратную ситуацию: разные префиксы могут указывать на один URI. Сравнение только строк a:item и b:item тоже не заменяет понимание пространств имён.
fast-xml-parser удобно сохраняет имена в объекте, но такой результат не объявляется полноценной namespace-aware моделью DOM. Для строгой интеграции проверяйте ожидаемые объявления xmlns и договоритесь о разрешении URI. Если задача требует сложных правил пространств имён и XSD, выбирайте инструменты, которые действительно покрывают эти требования, а не расширяйте смысл одного переключателя.
<inventory xmlns:s="urn:stock" xmlns:p="urn:price">
  <s:item>12</s:item>
  <p:item>1490.50</p:item>
</inventory>
Задача 5. CDATA и порядок смешанного содержимого
У каталога с простыми полями порядок часто несущественен: title и qty можно читать по именам. У текстового документа ситуация другая. Между словами располагаются выделенные фрагменты, ссылки, паузы или повторяющиеся команды. Обычный объект не всегда выражает исходное чередование этих узлов.
preserveOrder возвращает структуру, в которой порядок представлен последовательностью элементов массива. В нашем примере видны текст до b, сам b, следующий текст, i и CDATA. Во втором варианте команды action разделены pause. Сравнение с обычным объектом объясняет пользу настройки лучше абстрактного обещания «сохранить XML».
CDATA — это способ записать текст, содержащий специальные символы. Она не даёт права исполнять получившийся HTML. Мастерская выводит результат через textContent: строка с em или img остаётся видимым текстом. Для сохранения исходной последовательности используется cdataPropName; это отдельный аспект от разрешения HTML в интерфейсе. Переносы, вид кавычек и исходные отступы всё равно не становятся побайтовой гарантией.
const parser = new XMLParser({
  preserveOrder: true,
  trimValues: false,
  cdataPropName: '#cdata',
  parseTagValue: false
});
const nodes = parser.parse('<p>До <b>важно</b> после.</p>');
// В nodes[0].p сохранена последовательность текста и b.
Задача 6. Ошибка синтаксиса с настоящей строкой и столбцом
Повреждённый XML лучше отклонить до создания прикладных объектов. Первый вариант содержит несовпадающий закрывающий тег на третьей строке. XMLValidator возвращает код, сообщение, строку и столбец; мастерская показывает именно эти значения. Кнопка перехода выделяет соответствующую строку в редакторе.
Исправьте тег вручную и повторите запуск. Ошибка исчезнет, появится результат текущего документа. Такое поведение полезно в панели поддержки: человеку понятно, где исправить исходный файл, а система не продолжает показывать старые успешно разобранные данные рядом с новой ошибкой.
Проверка синтаксиса вызывается явно. Успех возвращает true, ошибка — объект. После него наш адаптер не запускает XMLParser. Подробнее форма ответа описана в документации XMLValidator. При этом наличие корректного закрывающего тега ничего не говорит о допустимости отрицательного количества — это следующая проверка.
import { XMLValidator } from 'fast-xml-parser';
const validation = XMLValidator.validate(xml);
if (validation !== true) {
  const { code, msg, line, col } = validation.err;
  // Вернуть понятную ошибку; не применять документ к базе.
}
Задача 7. Собрать XML без ручной склейки значений
Седьмая задача принимает JSON заказа. В нём есть внешний ID, клиент, комментарий и позиции. Перед сборкой собственная функция проверяет разрешённые поля, формат артикула и количество. После этого создаётся новый объект с известными именами XML-элементов и атрибутов.
XMLBuilder экранирует значения: амперсанд в названии компании превращается в ссылку amp, знак меньше в комментарии — в lt. Это отличается от вставки значения между строковыми тегами. Однако builder не должен получать произвольные JSON-ключи пользователя как доверенные имена элементов. Поэтому в проекте применяется разрешённый контракт, а не универсальное «JSON любой формы в XML».
Собранный документ проверяется и разбирается обратно. Мастерская сравнивает восстановленные поля заказа, а не исходные байты XML. Изменение порядка свойств входного JSON не ломает это сравнение. При необходимости точной XML-каноникализации или цифровой подписи нужен соответствующий механизм: обычный builder его не заменяет.
import { XMLBuilder } from 'fast-xml-parser';
const object = {
  order: {
    '@_id': '00125',
    customer: 'Свет & Дом',
    note: 'Доставка < 2 дней',
    item: [{ '@_sku': '00007', qty: '2' }]
  }
};
const xml = new XMLBuilder({
  ignoreAttributes: false, format: true, processEntities: true
}).build(object);
Задача 8. Проверить контракт после разбора
Восьмой пример отделяет пригодность данных от корректности XML. Рабочий вариант превращается в две строки приложения. Проблемный вариант содержит короткий ID, пустое название и отрицательное количество. Синтаксический разбор успешен, но наш контракт возвращает три ошибки с путями до полей.
При любой ошибке rows остаётся пустым. Это намеренное правило учебного импорта: проверка не отдаёт частичный набор, который следующий этап может случайно сохранить. Другой проект может разрешать частичное применение, но тогда ему нужны явные статусы принятых и отклонённых строк, итог партии и возможность повторной обработки.
Для сложной схемы удобно использовать Ajv и JSON Schema. В нашем небольшом контракте достаточно обычных функций: ID из пяти цифр, название длиной от одного до восьмидесяти символов, целое количество от нуля до ста тысяч. Дополнительно проверяются повторяющиеся ID внутри партии. Такие правила принадлежат приложению и должны меняться вместе с его требованиями.
const idOk = typeof id === 'string' && /^\d{5}$/.test(id);
const qtyOk = typeof qty === 'string'
  && /^\d{1,6}$/.test(qty)
  && Number(qty) <= 100000;
if (!idOk) errors.push({ path: 'catalog.product[0].@_id', message: 'Неверный ID' });
// Преобразование Number выполняем после проверки формата и диапазона.
Задача 9. Entities: наблюдаем поведение закреплённой версии
Ссылки amp и lt позволяют передать символы, которые имеют специальное значение в XML. Настройка processEntities управляет их обработкой. В первом варианте девятой задачи можно увидеть строку с буквальным & либо уже раскрытым амперсандом. Это реальный результат выбранной конфигурации.
При проверке версии 5.12.1 обнаружилась важная деталь: числовая ссылка A остаётся текстом при htmlEntities:false, даже когда processEntities включён. С htmlEntities:true она превращается в A. В мастерской есть отдельный переключатель, а в тестах закреплены оба исхода. Такое наблюдение нельзя превращать в универсальное правило XML или переносить на другую версию без проверки.
Основание видно в исходнике выбранного тега: настройка передаётся decoder как numericAllowed. Общие режимы описаны в документации entities. Для интеграции важно зафиксировать ожидаемый результат на собственных образцах, а не только включить параметр с подходящим названием.
new XMLParser({ processEntities: true, htmlEntities: false })
.parse('<note>& A</note>');
// В проверенной v5.12.1: { note: '& A' }
new XMLParser({ processEntities: true, htmlEntities: true })
.parse('<note>& A</note>');
// В проверенной v5.12.1: { note: '& A' }Размер входа и запрет DOCTYPE в нашем адаптере
Мастерская предназначена для небольших документов. До обращения к библиотеке она считает UTF-8 байты и отклоняет вход больше 32768 байт. Количество символов не заменяет этот размер: кириллица обычно занимает больше одного байта. Третий вариант девятой задачи специально превышает лимит и получает отказ политики, а не ошибку синтаксиса XML.
DOCTYPE и объявления ENTITY запрещены отдельной проверкой проекта. Библиотека поддерживает и другие режимы, поэтому сообщение честно называет источник отказа. Использован консервативный текстовый фильтр: такая последовательность будет отклонена даже внутри комментария, CDATA или JSON-строки. Это осознанная граница учебного адаптера, не полноценный анализ DTD.
Для внешнего API ограничивайте размер ещё на уровне чтения HTTP body, до накопления всей строки в памяти. Если документ приходит из файла, проверьте размер до readFile и повторно проверьте фактически прочитанные данные. Эти меры не заменяют авторизацию отправителя, квоты и проверку прикладного контракта.
const bytes = new TextEncoder().encode(text).byteLength;
if (bytes > 32768) throw new Error('Вход слишком большой');
if (/<!\s*(?:DOCTYPE|ENTITY)\b/i.test(text)) {
  throw new Error('DOCTYPE/ENTITY запрещены политикой проекта');
}
// Только после этих проверок вызывается XMLValidator.
Worker: интерфейс остаётся управляемым
Разбор XML — вычислительная работа. Даже библиотека на JavaScript может занять поток, особенно на необычной структуре документа. В мастерской обработка вынесена в Worker. Основная страница отвечает за редактор и кнопки, а рабочий поток получает строку и настройки, выполняет библиотеку и возвращает результат.
При новом запуске прежний Worker прекращается. У каждого выполнения есть номер, поэтому запоздалый ответ не заменит результат следующего документа. Если пользователь изменил текст, прошлое состояние скрывается. Это полезный общий приём для редакторов, поиска, анализа файлов и любых операций, где ответы могут приходить не в том порядке, в котором запускались.
После двух секунд ожидания мастерская завершает Worker. Это бюджет таймера, а не жёсткая гарантия реального времени: занятый планировщик может вызвать обработчик позже. Node CLI использует тот же принцип через worker_threads. Для постоянного сервиса выгоднее переиспользуемый пул с ограниченной очередью; такой подход разобран в материале про Piscina.
Node.js CLI: файл, результат и код завершения
CLI подходит для импорта по расписанию, проверки выгрузки перед загрузкой и диагностики в CI. Он принимает ключ задачи и путь локального UTF-8 файла. Сетевой URL не является допустимым источником в этой команде. XMLParser и прикладные проверки используются те же, что и в браузере, поэтому примеры не расходятся на две реализации.
Успех возвращает код завершения 0. Ошибка входа, синтаксиса или контракта возвращает 2. Сам результат печатается как JSON. Это позволяет скрипту следующего этапа отличить пригодный документ от просто существующего файла. Не игнорируйте код завершения, даже если stdout удалось записать в файл.
У CLI нет подключения к CRM или базе: он проверяет и преобразует. Это удобная точка встраивания, но пока не полноценный промышленный импорт. Вы можете вызвать адаптер из своего сервиса, добавить авторизацию источника и затем применять только проверенные строки в транзакции.
# Bash:
node tools/cli.mjs contract fixtures/contract.xml
echo $?
# PowerShell:
node tools/cli.mjs arrays fixtures/arrays.xml
$LASTEXITCODE
Как превратить опыт в рабочий конвейер импорта
Разделите получение, проверку и применение. Сначала сохраните поступивший файл под временным именем. После завершения записи переименуйте его в окончательное имя в пределах одной файловой системы. Обработчик не должен читать документ в тот момент, когда загрузчик дописывает его последние строки.
Затем посчитайте контрольную сумму и создайте запись партии. Сохраните источник, время получения, размер и итог проверки. Хеш помогает распознать повтор точно такого же файла, но не является цифровой подписью и не подтверждает автора. Доверие к отправителю обеспечивается отдельным каналом и правилами доступа.
После успешного контракта применяйте изменения транзакционно или явно фиксируемыми пакетами. Уникальный внешний ID помогает сделать повтор безопасным. Ошибка второй попытки не должна создавать дубликаты товаров. При загрузке XML через HTTP полезны ограничения и диагностика из статьи про Undici; её HTTP-таймауты относятся к доставке, а Worker-бюджет этой мастерской — к вычислению.
Linux/VPS: разместить статическую мастерскую
Готовый public можно раздавать обычным веб-сервером. На VPS не требуется запускать Node только ради браузерной страницы: JS-файлы уже собраны. Перенесите содержимое public в отдельный каталог, предоставьте веб-серверу чтение и сохраните правильные MIME-типы для JS, CSS и JSON.
Ниже пример location внутри существующего server-блока Nginx. Он не предназначен для замены всего конфига. После изменения выполните nginx -t, затем reload. Подробнее ежедневные настройки описаны в нашей мастерской Nginx. HTTPS настраивается на виртуальном хосте обычным для вашего сервера способом.
Если используется CSP, учтите загрузку собственного скрипта, Worker и sources.json. Для статической мастерской достаточно разрешений на её ресурсы своего происхождения; отключать всю политику не требуется. Не выкладывайте рядом исходные документы поставщика, ключи доступа и node_modules. Документация проекта отдельно объясняет условия использования внутри iframe.
location /xml-workshop/ {
    alias /var/www/xml-workshop/;
    index index.html;
    add_header X-Content-Type-Options nosniff always;
}
Linux/VPS: запуск проверки через systemd
Для серверного CLI создайте отдельного пользователя без интерактивного входа. Исходники разместите в /opt/xml-import, входной файл — в отдельном каталоге /var/lib/xml-import/incoming. Сервису нужно чтение кода и файла; права изменения самого проекта ему не нужны. Устанавливайте production-зависимости во время развёртывания, а не при каждом запуске.
В unit указан /usr/bin/node. На своём VPS сначала проверьте command -v node и используйте фактический абсолютный путь. Файл fixtures в учебном примере заменяется вашим проверенным путём. Код завершения 2 должен оставлять unit в неуспешном состоянии, чтобы ошибка не исчезла из наблюдения.
Архив содержит полный пример unit и timer с часовым расписанием. Он выполняет проверку, а не запись в бизнес-систему. stdout демонстрационного CLI содержит данные документа; в production разумно журналировать только идентификатор партии, число строк и пути ошибок. Не переносите подробный учебный вывод с персональными или коммерческими данными в общедоступный журнал.
[Service]
Type=oneshot
User=xml-import
Group=xml-import
WorkingDirectory=/opt/xml-import
ExecStart=/usr/bin/node /opt/xml-import/tools/cli.mjs contract /var/lib/xml-import/incoming/catalog.xml
TimeoutStartSec=15
NoNewPrivileges=true
ProtectSystem=strict
ProtectHome=true
PrivateTmp=true
UMask=0077
UTF-8, переносы строк и точность обратной сборки
Браузерный редактор уже работает со строкой Unicode. CLI дополнительно декодирует байты файла как UTF-8 с отказом на некорректной последовательности. Если партнёр присылает Windows-1251, строка encoding в XML не перекодирует файл за вас. Нужен отдельный согласованный этап декодирования перед XMLParser.
Обратная сборка не обещает сохранить каждую исходную деталь. Различаться могут отступы, пустые элементы, вид кавычек и представление ссылки на символ. Поэтому в задаче заказа сравниваются нормализованные прикладные поля. Это именно выбранный контракт сравнения, а не доказательство эквивалентности любых двух XML-документов.
Если XML входит в цифровую подпись, юридически значимый обмен или формат с обязательной XSD, используйте предусмотренные стандартом инструменты. Не пересобирайте подписанный документ обычным builder перед проверкой подписи. Для обычного каталога вопрос проще: заранее определите, какие поля и значения должны пережить преобразование, и закрепите их тестами.
Что проверено в проекте
На Windows с Node 24.19.0 и в Linux-контейнере с Node 24.22.2 прошли по двадцать тестов. Проверялись сохранение атрибутов, стабильная коллекция, строковые ID, namespaces, порядок и CDATA, настоящие ошибки XMLValidator, экранирование builder, контракт, entities, ограничения входа, Worker-таймаут и коды CLI.
Все девятнадцать готовых вариантов выполнены в настоящих Node-потоках на обеих ОС. Семантические результаты и хеши исходников совпали; байты браузерной сборки также совпали. Длительность обработки исключена из сравнения, поскольку она зависит от конкретного запуска. QA-файл сохраняет доказательства этих запусков, но публичная мастерская не использует его как готовый ответ.
Отдельный тест открывает собранный интерфейс в JSDOM и подключает настоящий собранный worker через Node-адаптер. Он проходит девять экранов, изменение входа, очистку старого результата и инертное отображение HTML из CDATA. Это проверка кода интерфейса, которую нужно дополнить реальным браузером и мобильной шириной. Локальный Linux-контейнер также не объявляется проверенным production VPS.
npm test
npm run capture
# qa/actual-node-results.json: реальные результаты Node
npm run build
# public/worker.js: библиотека для настоящего браузерного выполнения
Производительность: что измерять в своём приложении
Название библиотеки не заменяет измерения. В мастерской показано время внутри обработчика и общая задержка с созданием Worker. Эти числа отвечают на разные вопросы. Нельзя сравнивать один маленький запуск в браузере с обработкой большого файла на VPS и называть разницу ускорением алгоритма.
Для своей нагрузки измерьте размер документов, число узлов, количество одновременных импортов, время проверки контракта и пиковую память. XMLParser создаёт объектную структуру в памяти; большая выгрузка может требовать потокового подхода с обработкой по элементам. Ограничение очереди часто полезнее бесконечного увеличения числа рабочих потоков.
Сначала добейтесь правильности на маленьких документах, затем добавляйте реалистичный объём. Включите редкие поля, одиночную коллекцию, пустой документ, повтор ID и повреждённую структуру. Именно эти варианты показывают, насколько устойчив ваш конвейер, когда поставщик меняет данные или присылает не тот файл.
Исходники и следующий практический шаг
Скачиваемый проект содержит готовую мастерскую, исходные модули, CLI, тесты, fixtures, Dockerfile, инструкции Windows/Linux и пример VPS. Просмотр исходников доступен прямо на странице: выберите файл, раскройте код и скачайте его отдельно. Полный архив позволяет изменить не только XML, но и сам контракт приложения.
Начните со своего небольшого документа. Опишите, откуда берётся внешний ID, какие элементы являются коллекциями, что считается пустым значением и какие поля можно преобразовать в числа. Затем добавьте отрицательный вариант рядом с успешным: потерянный атрибут, один товар вместо нескольких, неверный namespace или повтор строки.
Полезный результат такого упражнения — понятный адаптер на границе системы. Он получает документ, явно сообщает о проблеме либо возвращает проверенную прикладную структуру. Доставка, авторизация и применение в базе остаются видимыми этапами. Тогда fast-xml-parser помогает построить поддерживаемую интеграцию, которую можно объяснить другому разработчику и проверить на конкретных данных.