NATS и JetStream: сообщения Node.js — мастерская и 9 практических задач
От публикации до подтверждения: девять реальных опытов NATS, история и повторы JetStream, интерактивная мастерская и исходники Node.js Windows/Linux.
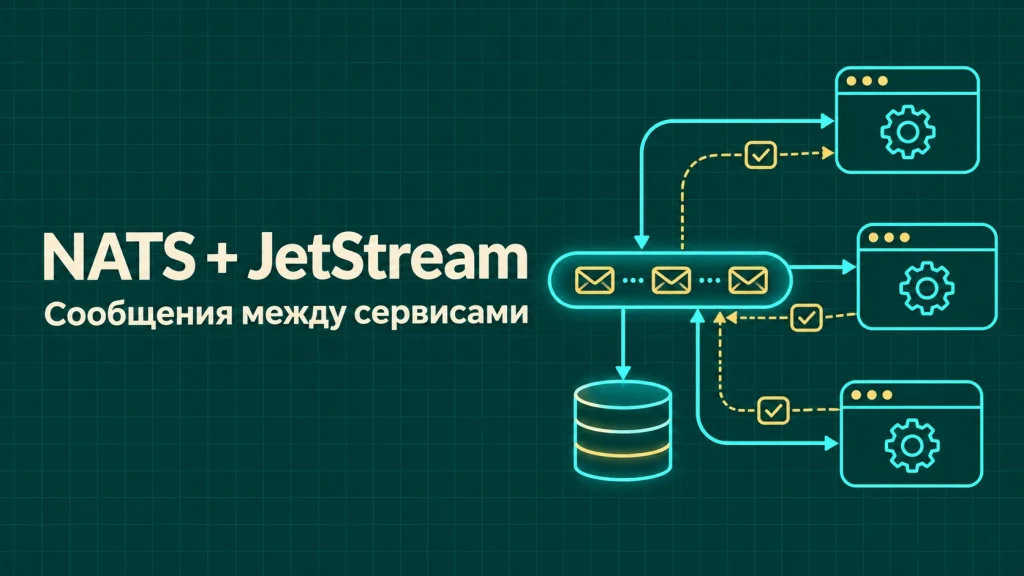
NATS и JetStream на практике: сообщения, ответы, группы обработчиков, история, подтверждения и повторы. Девять настоящих опытов, интерактивная мастерская и исходники Node.js для Windows/Linux.
NATS: связать сервисы через понятные события
Клиент оформил заказ. Одному сервису нужно создать задачу на исполнение, другому — обновить отчёт, третьему — подготовить уведомление. Если каждый участник напрямую вызывает все остальные системы, связи быстро становятся трудными для изменения: добавление нового получателя требует правки отправителя и учёта его ошибок.
NATS позволяет передавать сообщения через subjects — именованные темы маршрутизации. Отправитель сообщает о событии, заинтересованные подписчики получают его. Request/reply добавляет запрос с ответом, queue group распределяет сообщения между обработчиками, а JetStream сохраняет историю и отслеживает подтверждения потребителей.
В статье разберём девять задач на Node.js: от двух подписчиков до повторной доставки, дедупликации и ограничения незавершённой работы. Для каждого опыта действительно запускался NATS server. Мини-мастерская воспроизводит сохранённые события этих запусков; архив позволяет повторить сетевой обмен самостоятельно на Windows и Linux. Отдельно рассмотрим, что нужно изменить для использования на VPS.
Где применять: заказы, фоновые процессы и интеграции
В сервисном бизнесе событие order.created может заинтересовать несколько независимых функций. Исполнение создаёт заявку, аналитика обновляет витрину, уведомления выбирают канал отправки. Отправитель не обязан знать конкретные адреса всех этих обработчиков, но обязан поддерживать понятный контракт события: идентификатор, тип, версию схемы и необходимые данные.
Другой сценарий — запрос к внутреннему сервису. Например, процесс оформления спрашивает актуальную цену и ждёт ответ ограниченное время. Здесь уместен request/reply: вызывающему коду нужен конкретный результат сейчас. Для длительного формирования отчёта полезнее событие и отдельное сообщение о готовности, чем долго удерживаемый синхронный запрос.
NATS не заменяет базу данных, управление правами и предметную модель. Для привычных фоновых заданий со своим интерфейсом очереди сравните подход с BullMQ: области применения пересекаются, но шина событий, очередь задач и история независимых потребителей требуют разных решений. Начните с нужного поведения, а затем выбирайте механизм.
Core NATS и JetStream: что меняется в доставке
Core NATS передаёт сообщения активным подписчикам. Он удобен для уведомлений и взаимодействия работающих сервисов, когда история не нужна или восстанавливается из другого источника. Сообщение, опубликованное без нужного подписчика, не превращается автоматически в ожидающее задание. Queue group распределяет Core-сообщение, но не добавляет ему долговременное хранение.
JetStream создаёт другой рабочий контракт: stream сохраняет сообщения, consumer хранит состояние чтения, клиент получает данные и подтверждает их. Отправитель и обработчик могут работать в разное время. Повторная доставка означает, что обработчик должен допускать повтор сообщения и защищать внешний бизнес-эффект.
PubAck, подтверждение consumer и запись результата в вашей базе — разные события. Нельзя считать заказ обработанным только потому, что брокер подтвердил сохранение. Основные понятия раскрыты в официальном обзоре JetStream. В нашей лаборатории различия видны по конкретным событиям и счётчикам, а не по одной надписи «успех».
Версии и точные границы учебного стенда
Проверенный сервер — NATS 2.15.3 в официальном Alpine-образе. Используются модульные Node-пакеты @nats-io/transport-node 3.4.0 и @nats-io/jetstream 3.4.0. Точные npm-зависимости зафиксированы lock-файлом; Linux-образ клиента дополнительно закреплён digest и при проверке содержит Node 24.22.2. На Windows клиент выполнялся в Node 24.19.0.
Брокер в обоих случаях работает в Linux Docker. Поэтому переключатель Windows/Linux относится к среде клиента, а не к утверждению, что мы тестировали два разных варианта серверной ОС. В опытах используются вымышленные заказы и отдельные потоки с уникальным префиксом. Существующий брокер вашего проекта не нужен.
Проверен один брокер без TLS и авторизации, доступный через loopback. Это удобный локальный стенд; перенос такой конфигурации на публичный интерфейс VPS не предусмотрен. Источники и лицензии NATS доступны в релизе сервера и архиве. Кластер, отказы узлов и восстановление production-хранилища не выдаются за выполненные испытания.
Мини-мастерская: пройти событие от публикации до ack
Выберите среду клиента и задачу. Кнопка следующего события подсвечивает очередной шаг сохранённого опыта: публикацию, получение, отказ, повтор или подтверждение. Можно показать всю последовательность сразу, вернуться к началу и скачать JSON конкретного опыта. Подтверждённый итог виден отдельно, поэтому количество подсвеченных карточек не выглядит счётчиком ещё работающего брокера.
В браузере нет подключения к NATS. Порядок карточек взят из настоящего Node-запуска, а подсветка помогает читать этот порядок; её скорость не измеряет задержку сети. Для новой доставки с другими данными нужно запустить исходный проект. Такое разделение позволяет изучать инфраструктурный инструмент на обычной странице без доступа к открытому брокеру.
Ниже расположен отдельный тренажёр subject: вводите имя события и проверяйте шаблоны с * и >. Он прямо обозначен как локальная учебная модель сопоставления, а не сетевой результат. В просмотре исходников доступны capture, Compose, конфигурация сервера и инструкции. Для удобного чтения всех событий откройте мастерскую на весь экран.
Windows: первый запуск собственного брокера
Потребуются Node.js и Docker Desktop с Linux-контейнерами. Распакуйте архив в отдельный каталог. Имя Compose project указывается явно: так контейнеры и volume лаборатории отделены от других проектов. Клиентский порт опубликован как 127.0.0.1:14222, HTTP-мониторинг — как 127.0.0.1:18222.
Сначала запустите брокер и дождитесь готовности. Наличие созданного контейнера ещё не означает, что он принимает подключения. Проверьте лог и healthz, затем запускайте capture. После успеха появится запись Windows в public/recording.json. Повторный запуск создаёт свои уникальные тестовые streams и удаляет их в finally.
Статическую мастерскую можно открыть отдельно через npm run serve на порту 8544. Готовые записи уже включены в архив; для их просмотра Docker не требуется. В конце остановите только свой сервер через Ctrl+C и свой Compose project. Не завершайте чужие контейнеры или весь Docker ради освобождения порта.
npm ci --ignore-scripts --no-audit --no-fund
docker compose -p aen-nats-lab up -d nats
docker compose -p aen-nats-lab logs --tail=30 nats
Invoke-RestMethod http://127.0.0.1:18222/healthz
npm run capture
npm run serve
Linux: локальный клиент и полностью контейнерный повтор
На Linux команды Compose остаются теми же, а проверку HTTP удобно выполнить curl. Если клиент запускается непосредственно на хосте, NATS_URL указывает на loopback-порт 14222. В контейнере клиента используется nats://nats:4222: имя nats разрешается внутри сети Compose, поэтому порт хоста здесь не участвует.
Сервис linux в Compose собирает Node-окружение и сохраняет recording-linux.json через bind mount public. Сначала дождитесь готовности брокера, затем запускайте одноразовый клиент с –rm. depends_on задаёт порядок запуска, но не заменяет проверку того, что брокер уже отвечает. Если работаете на VPS, сохраняйте закрытые порты точно так же.
Если раньше не использовали Compose, наш материал про Docker Compose объясняет сети, volumes и команды диагностики. Важно различать контейнер, именованный volume и файлы результата на хосте: они имеют разные жизненные циклы и правила очистки.
docker compose -p aen-nats-lab up -d nats
curl --fail http://127.0.0.1:18222/healthz
docker compose -p aen-nats-lab build linux
docker compose -p aen-nats-lab run --rm linux
# Остановка лаборатории с сохранением volume:
docker compose -p aen-nats-lab down
Подключение, subjects и данные сообщения
Subject — последовательность токенов через точку. Например, orders.eu.created можно использовать для события заказа из европейского подразделения. Подписка orders.*.created выбирает один промежуточный токен, orders.> — один или несколько последующих токенов. Wildcard используется в шаблоне подписки; опубликованное сообщение имеет конкретный subject.
Содержимое передаётся как байты. В лаборатории объект сериализуется в JSON и кодируется TextEncoder; получатель читает JSON. В своём приложении всё равно проверяйте схему: неверный JSON, неизвестная версия события и отсутствие event_id должны давать управляемый отказ. Пример подхода есть в мастерской Ajv.
В следующих фрагментах nc, js, jm и enc обозначают подключение, JetStream-клиент, административный API и кодирование JSON. Это сокращённые примеры отдельных операций: имена потоков упрощены, служебная подготовка поясняется рядом с кодом. Полный исполняемый жизненный цикл с уникальными именами, проверками и очисткой находится в capture.mjs. Не запускайте административный API с правами обычного production-публикатора.
import { connect } from '@nats-io/transport-node';
import { jetstream, jetstreamManager } from '@nats-io/jetstream';
const nc = await connect({ servers: 'nats://127.0.0.1:14222' });
const js = jetstream(nc);
const jm = await jetstreamManager(nc);
const enc = value => new TextEncoder().encode(JSON.stringify(value));
Опыт 1. Два подписчика получают одно событие
Первый опыт создаёт две активные подписки на один subject. После публикации заказа обе получают данные. Это базовая модель fan-out: уведомления и аналитика могут реагировать независимо, без выбора одного «главного» получателя на уровне отправителя.
Перед публикацией вызывается flush, чтобы сервер успел обработать зарегистрированные подписки. После отправки опыт ждёт именно два получения и проверяет результат. В данном стенде обе подписки находятся в одном процессе и используют одно подключение: это честная проверка поведения подписок, а не тест межпроцессной отказоустойчивости.
Такой механизм подходит для оперативных уведомлений, но не должен незаметно становиться единственным способом сохранить важное бизнес-событие. Если получатель обязан прочитать событие после своего отключения, понадобится хранение либо восстановление из другого источника. Core pub/sub сам по себе не создаёт историю для будущего подписчика.
const received = [];
const a = nc.subscribe('demo.news', {
  callback: (err, message) => {
    if (err) throw err;
    received.push({ subscriber: 'A', data: message.json() });
  }
});
// В полном опыте добавлена аналогичная подписка B.
await nc.flush();
nc.publish('demo.news', enc({ order: 104, status: 'created' }));
Опыт 2. Запрос, ответ и отсутствующий сервис
Request/reply удобно применять, когда вызывающий процесс действительно нуждается в результате: цене, признаке доступности или вычисленном ответе внутреннего сервиса. Клиент создаёт временный inbox для ответа и задаёт предел ожидания. В лаборатории сервис возвращает цену 1490 RUB для переданного SKU.
Второй запрос направляется на subject без responder. Получен реальный отказ клиента, который сохранён в записи вместе с именем и сообщением ошибки. Это не выдуманный HTTP-статус и не искусственная задержка интерфейса. В частности, отсутствие responder может быть обнаружено раньше истечения указанного timeout.
Важная практическая граница: ошибка ожидания не всегда доказывает, что удалённая операция не выполнялась. Ответ мог потеряться после изменения состояния. Для операций с побочным эффектом используйте устойчивый идентификатор запроса и правила повторения. Устройство механизма описано в документации request/reply; сам таймаут не превращает взаимодействие в транзакцию.
try {
  const reply = await nc.request('demo.price', enc({ sku: 'A104' }), {
    timeout: 1500
  });
  console.log(reply.json());
} catch (error) {
  console.error(error.name, error.message);
}
Опыт 3. Queue group распределяет работу
Третий опыт создаёт две подписки с общей группой workers и публикует двенадцать задач. Каждое сообщение получает один участник группы. Итог проверяет двенадцать различных номеров задач; таблица результата показывает фактическое распределение между A и B.
Пропорция не обязана быть шесть на шесть. Не используйте равенство долей как критерий корректности такого теста. По той же причине различие распределения между Windows и Linux не означает расхождение бизнес-результата. Существенно, что все ожидаемые номера получены без дублирования в этом конкретном запуске.
Queue group полезна для распределения нагрузки между работающими экземплярами. Но группа Core NATS не сохраняет незавершённое задание после падения обработчика и не требует подтверждения результата. Если работа должна пережить отключение потребителя, переходите к JetStream consumer и проектируйте ack, повтор и идемпотентность.
nc.subscribe('demo.jobs', {
  queue: 'workers',
  callback: (error, message) => {
    if (error) throw error;
    console.log('worker A', message.json());
  }
});
// Подписка B использует тот же subject и queue: 'workers'.
Опыт 4. Stream сохраняет сообщение и возвращает PubAck
Stream связывается с шаблоном subjects и сохраняет подходящие сообщения. В лаборатории используется File storage, ограничение ста сообщений, одного MiB и часа хранения. Три заказа публикуются до подключения читателя; сервер возвращает sequence для каждого, а info подтверждает три сохранённые записи.
PubAck означает, что JetStream подтвердил публикацию по своему контракту. Он не сообщает, что товар отгружен, письмо отправлено или транзакция CRM завершена. Поэтому полезно показывать пользователю приложения отдельные состояния: принято системой, ожидает обработки, выполнено, требуется повтор или вмешательство.
Хранилище одного брокера — часть стенда, а не отказоустойчивый кластер. Для важной нагрузки необходимо отдельно выбрать репликацию, стратегию резервирования и восстановление. Сам факт storage:file подтверждён в опыте, а испытание отключения узла в него не включено.
import { StorageType } from '@nats-io/jetstream';
await jm.streams.add({
  name: 'ORDERS', subjects: ['orders.*'], storage: StorageType.File,
  max_msgs: 100, max_bytes: 1048576, max_age: 3600e9,
  duplicate_window: 120e9
});
for (let i = 1; i <= 3; i++) {
  const ack = await js.publish('orders.created', enc({ order: 100 + i }), {
    msgID: `order-${i}`
  });
  console.log(ack.seq, ack.duplicate);
}
Опыт 5. Pull consumer и подтверждение обработки
Consumer отслеживает состояние чтения stream. Durable consumer имеет устойчивое имя, с которым обработчик может связываться повторно. В нашем опыте shipping запрашивает одно сообщение через next, получает заказ и отправляет ackAck. Сервер подтверждает ack, после чего num_ack_pending равен нулю.
Здесь нет реальной операции отгрузки: подтверждается механизм consumer. В приложении ack отправляют после устойчивого результата. Если отправить его до записи в базу, а затем процесс упадёт, брокер уже будет считать сообщение подтверждённым. Обратная последовательность оставляет возможность повтора, которую и должна выдерживать прикладная логика.
Для нескольких сообщений можно использовать fetch с размером партии и временем ожидания. Непрерывные обработчики используют подходящий API потребления, ограничивая объём одновременно взятой работы. Отличия pull-режимов разобраны в официальном руководстве; увеличенный batch не должен превышать возможности ваших downstream-сервисов.
import { AckPolicy, DeliverPolicy } from '@nats-io/jetstream';
await jm.consumers.add('ORDERS', {
  durable_name: 'shipping', ack_policy: AckPolicy.Explicit,
  deliver_policy: DeliverPolicy.All, ack_wait: 2e9, max_deliver: 3
});
const consumer = await js.consumers.get('ORDERS', 'shipping');
const message = await consumer.next({ expires: 1200 });
if (message) await message.ackAck();
Опыт 6. Повторная доставка после nak
Иногда сообщение корректно, но выполнить работу сейчас невозможно: временно недоступна база или внешний сервис. В шестом опыте обработчик явно отправляет nak с задержкой 150 миллисекунд. Брокер повторно выдаёт тот же sequence, а deliveryCount становится не меньше двух. После повторного получения отправляется подтверждение.
Это реальная повторная доставка, вызванная nak. В записи не моделируется потеря ack или падение процесса. Такие ситуации также важны для приложения, но требуют собственных испытаний. Не приравнивайте количество учебных карточек к доказательству всех возможных отказов распределённой системы.
В потоке этого опыта находится одна задача, поэтому повтор хорошо виден. В полном проекте для неё созданы отдельный RETRY-поток и consumer retry, а не продолжается чтение shipping. В общем потоке новые сообщения могут прийти раньше повторного, и порядок выполнения бизнес-операций необходимо проектировать отдельно. Также ограничивайте число попыток и наблюдайте исчерпание max_deliver: установка этого числа сама по себе не создаёт готовый процесс разбора неисправимых сообщений.
// Подготовка: отдельный RETRY stream с одной задачей
// и durable consumer retry с AckPolicy.Explicit.
const retry = await js.consumers.get('RETRY', 'retry');
const first = await retry.next({ expires: 1200 });
if (!first) throw new Error('Сообщение не получено');
first.nak(150);
const again = await retry.next({ expires: 1600 });
if (!again) throw new Error('Повтор не получен');
console.log(first.seq === again.seq, again.info.deliveryCount);
await again.ackAck();
Опыт 7. Дедупликация публикации и её окно
Повтор публикации возможен даже у аккуратного клиента: подтверждение не пришло, отправитель не знает, сохранилось ли сообщение. Стабильный msgID помогает JetStream распознать такой повтор в пределах настроенного окна. В опыте повторно отправляется order-1, PubAck содержит duplicate:true, а число записей остаётся равным трём.
Окно лаборатории — 120 секунд. За его пределами нельзя обещать то же поведение. Не генерируйте новый случайный msgID для каждой попытки одного события: брокер увидит разные публикации. При этом разные события одного заказа тоже должны различаться, например по event_id или типу и версии события.
Этот механизм относится к записи в stream. Он не запрещает обработчику дважды вызвать оплату или отправить два письма при повторной доставке. Дедупликация публикации и идемпотентность бизнес-операции полезны вместе, но решают разные задачи. Не называйте результат этого опыта гарантией «бизнес-действие ровно один раз».
const duplicate = await js.publish('orders.created', enc({ order: 101 }), {
  msgID: 'order-1'
});
console.log(duplicate.duplicate); // true внутри окна опыта
const info = await jm.streams.info('ORDERS');
console.log(info.state.messages); // по-прежнему 3
Как сделать бизнес-операцию идемпотентной
Допустим, событие создаёт счёт в вашей базе. Храните event_id с уникальным ограничением и выполняйте регистрацию события вместе с изменением состояния в одной транзакции. Если транзакция уже применена, повтор должен возвращать известный успешный результат, а не создавать второй счёт.
Если после commit процесс упал до ack, сообщение придёт повторно. Именно поэтому порядок «сначала устойчивый результат, потом подтверждение» требует идемпотентного обработчика. Если же отправить ack раньше commit, появляется другой риск: сообщение подтверждено, а действие потеряно. Эти два окна отказа нужно обсуждать явно.
Для внешнего API транзакция вашей базы не охватывает чужой сервер. Используйте поддерживаемый им idempotency key и храните состояние взаимодействия. Когда изменение базы должно породить событие, рассмотрите outbox: событие записывается рядом с бизнес-изменением, а отдельный процесс доставляет его брокеру. В текущем стенде нет такой базы и платёжного API; это архитектурные шаги внедрения, которые требуют дополнительных тестов.
Опыт 8. Независимый consumer читает историю
Stream с Limits retention сохраняет события независимо от того, подтвердил ли их shipping. Поэтому новый consumer audit может прочитать все три заказа с начала истории. Восьмой опыт создаёт именно такого независимого читателя, запрашивает партию и подтверждает полученные сообщения.
Это полезно для аналитики, восстановления проекции и нового сервиса, который подключили позже. При этом consumer — состояние на сервере, а не просто ещё одно имя переменной JavaScript. Два обработчика, работающие с одним durable consumer, делят его прогресс; два разных consumer могут читать историю независимо.
Replay имеет последствия для побочных эффектов. Пересчитать аналитическую витрину и заново отправить письма всем клиентам — совершенно разные операции. Для восстановления используйте отдельную проекцию, режим без внешних отправок или проверенный идемпотентный обработчик. Доступность истории не означает, что любой её повтор безопасен для бизнеса.
await jm.consumers.add('ORDERS', {
  durable_name: 'audit', ack_policy: AckPolicy.Explicit,
  deliver_policy: DeliverPolicy.All
});
const audit = await js.consumers.get('ORDERS', 'audit');
const batch = await audit.fetch({ max_messages: 3, expires: 1200 });
for await (const message of batch) {
  console.log(message.seq, message.json());
  await message.ackAck();
}
Опыт 9. Ограничить незавершённую работу
Быстро получить сообщение и быстро завершить операцию — разные возможности. Если обработчик заберёт тысячи задач, а база обслуживает только несколько запросов, работа накопится в памяти приложения. Ограничения на стороне consumer помогают сделать поток управляемым.
В последнем опыте max_ack_pending установлен в два. Получены две задачи, третья попытка next завершается без сообщения. После ack одной из задач появляется место, и следующий pull получает третий элемент. Такой результат показывает реальное влияние настройки на выдачу, а не только значение в конфиге.
Подбирайте вместе размер batch, число работающих экземпляров, время обработки и ack_wait. Слишком короткий ack_wait способен привести к повторной доставке ещё обрабатываемого сообщения. Слишком большая партия увеличит время удержания данных и сложность остановки. Наблюдайте не только скорость поступления, но и возраст самой старой ожидающей задачи.
await jm.consumers.add('LIMIT', {
  durable_name: 'slow', ack_policy: AckPolicy.Explicit,
  max_ack_pending: 2, ack_wait: 2e9, max_deliver: 3
});
// Полный опыт: next, next, next→null, ack, next→третья задача.
Retention, лимиты и значение подтверждения
В лаборатории используется обычная Limits retention. Она позволяет читателю audit увидеть сообщения даже после подтверждения shipping. Это подходит для истории событий с ограниченным сроком хранения. При другой политике значение ack для удаления данных может отличаться, поэтому retention выбирают по назначению потока.
Interest учитывает интерес потребителей, WorkQueue предназначена для распределяемой работы. Но ни название политики, ни удаление подтверждённого сообщения не превращают внешний эффект в exactly-once транзакцию. Лимиты количества, байтов и возраста остаются важны при любом выборе: отставший consumer не должен предполагать, что история будет доступна бесконечно.
Конкретные различия описаны в руководстве по retention. Для приложения письменно определите срок восстановления, допустимое отставание и поведение при достижении лимита. В статье не утверждается, что наш короткий опыт исчерпал диск или все пределы хранения: они настроены, а проверенный отказ здесь относится к max_ack_pending.
Linux/VPS: авторизация и закрытая сеть
Первое изменение для VPS — убрать предположение, что любой процесс с сетевым доступом имеет право работать с брокером. Учебный capture намеренно разрешает только два адреса изолированного стенда. Не снимайте это ограничение для подключения к production: создайте отдельное приложение и отдельную конфигурацию.
Если все сервисы живут на одном сервере, можно оставить их в закрытой Docker-сети, а порт хоста публиковать только на loopback при необходимости. Настройте аутентификацию и permissions по subjects. Публикатору заказов обычно не нужны права создавать и удалять streams через административный API.
Ниже пример пользователя, который публикует только orders.created и получает PubAck через inbox; stream должен существовать заранее. APP_PASSWORD берётся из окружения процесса NATS. Ссылка на переменную в конфигурации не заключена в кавычки: иначе это был бы буквальный текст. Этот фрагмент не включён в выполненные локальные опыты и не является готовой политикой для всей системы.
Шаблон _INBOX.> широк в пределах общего account: для недоверенных приложений используйте отдельные accounts или собственный inbox-prefix и соответствующие permissions. Полный список разрешений worker зависит от его API: pull, consumer info и ack нужно учитывать отдельно. Основы описаны в документации authentication и authorization; развёрнутые пояснения находятся в LINUX-VPS.md.
authorization {
  users: [{
    user: "order-publisher"
    password: $APP_PASSWORD
    permissions: {
      publish: { allow: ["orders.created"] }
      subscribe: { allow: ["_INBOX.>"] }
    }
  }]
}
TLS и мониторинг: разные соединения и разные права
Для связи между машинами используйте TLS с проверкой имени сервера и доверенного CA. Не отключайте проверку сертификата, чтобы скрыть ошибку имени. При mTLS отдельно настройте требования к клиентскому сертификату. Наличие сертификата сервера не заменяет прикладные permissions.
Клиентский TLS не включает автоматически защиту monitoring, cluster, leafnode и остальных типов соединений. Это отдельные настройки, что подчёркивает официальная документация TLS. На одном VPS разумно оставить monitoring закрытым и открывать его через SSH-туннель для диагностики.
Начните с healthz, varz и jsz. Они помогают увидеть ответ сервера, подключения, состояние JetStream и очереди подтверждений. Мониторинговый HTTP-порт не получает автоматически user/password-аутентификацию NATS-клиентов. Не публикуйте его наружу только потому, что брокер уже требует пароль. Описания endpoint доступны в руководстве по мониторингу.
curl --fail http://127.0.0.1:18222/healthz
curl --fail http://127.0.0.1:18222/varz
curl --fail 'http://127.0.0.1:18222/jsz?streams=true&consumers=true'
docker compose -p aen-nats-lab logs --tail=100 nats
Volume, restart и резервное восстановление
Данные JetStream находятся в /data/jetstream на именованном volume. Обычный down лабораторного Compose project сохраняет volume, а down -v удаляет его данные. Эти действия не равнозначны. Также capture сам удаляет созданные им временные streams при завершении, поэтому пустая история после capture не является признаком потери данных при restart.
В LINUX-VPS.md есть отдельное упражнение: создать собственный AEN_PERSIST_CHECK, сохранить сообщение, перезапустить только брокер своего стенда и сравнить состояние. Это инструкция для самостоятельной проверки, а не часть уже записанных девяти опытов. Для полноценной приёмки необходимо также прочитать payload и проверить восстановление выбранного consumer.
Резервирование требует отдельной процедуры snapshot/backup и проверенного restore. Случайное копирование активного каталога не объявляйте согласованной резервной копией. Репликация помогает с некоторыми отказами узлов, но не отменяет ошибочное удаление и срок retention. Один контейнер с File storage остаётся одним узлом, даже если файлы лежат на постоянном volume.
Остановка, ошибки клиента и наблюдаемость
Обработчик должен завершаться управляемо. Перестаньте брать новую работу, дождитесь допустимого завершения уже начатых операций и завершите соединение. В capture используется drain; в настоящем сервисе добавьте внешний предел ожидания, чтобы остановка не зависла навсегда на чужом API.
Отдельно наблюдайте разрывы подключения, повторное соединение, ошибки публикации и неполученный ack. Настройка reconnect не означает, что любая операция будет незаметно и правильно повторена. Особенно внимательно обрабатывайте неизвестный исход публикации: стабильный event_id и дедупликация помогают, но не заменяют журнал состояния приложения.
В логах полезны event_id, subject, stream sequence, номер попытки и длительность обработки. Полное содержимое сообщений может включать чувствительные данные, поэтому его не следует выводить автоматически в общий журнал. Для корреляции нескольких сервисов можно развить подход с метриками и трассировкой; сначала обеспечьте понятный статус каждой операции и контролируемое повторение.
try {
  // Подписки, публикации и обработка сообщений приложения.
} finally {
  await nc.drain();
}
// В промышленном worker остановка новой работы и её дедлайн
// задаются приложением отдельно.
Что подтверждено Windows/Linux запусками
На каждой платформе выполнены девять опытов и шестнадцать проверок результатов. Настоящие клиенты обменивались сообщениями с NATS 2.15.3: получены два fan-out сообщения, ответ и отказ request/reply, двенадцать задач группы, сохранённые записи, ack, повтор после nak, дедупликация, независимая история и блокировка выдачи до подтверждения.
Исходники клиента и конфигурации совпадают по хешам между Windows и Linux. Время записи, уникальные имена streams и случайное распределение задач между подписчиками могут различаться. Это ожидаемые свойства конкретных запусков; их нельзя сравнивать как жёстко одинаковую строку результата.
Проверки не включают падение физического сервера, проверенный кластер, потерю ack, транзакцию в бизнес-базе и TLS production-соединения. Практические инструкции VPS отделены от этих доказательств. Такой список границ помогает понять, что уже можно повторить из архива и какие испытания необходимы перед использованием в вашей системе.
Скачать проект и внедрить один сценарий
Архив содержит Node-клиент, Docker Compose, конфигурацию NATS, Windows/Linux записи, статическую мастерскую и отдельную инструкцию для VPS. Исходники можно читать прямо на странице и скачивать по одному файлу. Запуск capture создаёт новый фактический опыт; просмотр готовой записи ничего не публикует брокеру.
Выберите один понятный сценарий: событие нового заказа, запрос цены или обработку фоновой задачи. Зафиксируйте subject, схему данных, устойчивый ID и поведение при повторе. Отдельно решите, нужна ли история, когда отправляется ack и как пользователь приложения узнаёт об окончательном результате.
После успешного случая проверьте отказ: нет responder, обработчик вернул nak, публикация повторена, выдача ограничена. Именно различие между этими состояниями делает очередь наблюдаемой и полезной. NATS даёт механизмы доставки и хранения, а надёжность вашего процесса складывается из контракта, подтверждений, повторяемости действий и проверенного развёртывания.