Bruno: API-коллекции, проверки и CI — мастерская и 8 практических тем
API-запросы как файлы проекта: параметры, JSON, переменные, Bearer, ошибки и отчёты. Восемь тем, четырнадцать реальных запросов и готовая коллекция.
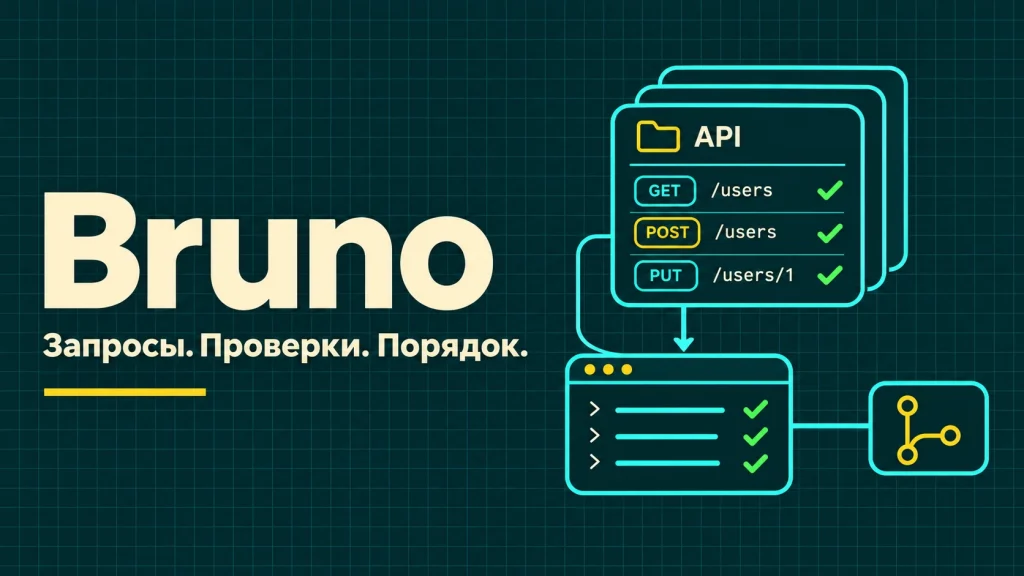
Bruno: API-коллекции в Git, запросы, переменные и проверки. Восемь практических тем, 14 настоящих HTTP-запросов, интерактивная мастерская и исходники Windows/Linux.
Bruno: запросы к API, которые остаются частью проекта
Вы добавили форму заявки, подключили каталог услуг или поменяли ответ серверного метода. В браузере всё выглядит нормально, но после следующей правки фильтр начинает игнорировать параметр, авторизация возвращает лишние данные, а число в отчёте меняет тип. Проверять каждый такой случай вручную неудобно. Хочется сохранить запрос вместе с ожидаемым результатом и запускать его снова перед выпуском.
Bruno позволяет организовать такую работу через коллекции API. Запросы, переменные, окружения и проверки хранятся в файлах проекта. Их можно открыть в клиенте, обсудить в Git, передать коллеге и выполнить командой CLI. Коллекция постепенно становится практическим описанием того, как ваш API должен вести себя в обычных и ошибочных ситуациях.
В статье разберём восемь тем на небольшом сервисе заявок: GET, параметры, POST JSON, цепочки, ошибки полей, учебную авторизацию, ответ 429 и падение теста при HTTP 200. Внутри страницы есть мастерская с четырнадцатью записями настоящих запросов. Исходники включают локальный Node.js API, коллекцию, набор данных, JSON/JUnit-отчёты и команды для Windows, Linux и CI.
Где применять: интерфейсы, интеграции, выпуск и поддержка
Для разработчика интерфейса коллекция полезна ещё до готового экрана. Можно проверить, какие параметры нужны таблице, как выглядит пустая страница, что сервер отвечает на неверное поле и какой заголовок требуется закрытому методу. Когда форма появляется в приложении, её сетевой контракт уже понятен: не нужно угадывать структуру JSON по случайному успешному запросу.
Для серверной команды это набор повторяемых проверок после изменения контроллера, сериализатора, маршрутов или авторизации. Для интеграции с собственным сервисом — документация рабочих запросов, которую можно выполнить. Для поддержки — воспроизводимый пример ошибки: конкретное окружение, параметры и ожидаемый результат вместо сообщения «сегодня таблица странно работает».
Особенно хорошо начинать с короткого smoke-набора перед выпуском: готовность API, чтение справочника, создание тестовой сущности, проверка прав и один негативный случай. Такой набор должен завершаться быстро и давать понятную причину ошибки. Не пытайтесь сразу превратить коллекцию в копию всего приложения: сначала покройте те действия, поломка которых действительно мешает пользователю.
Bruno Desktop, CLI и файлы коллекции
В настольном клиенте удобно собирать и изучать запросы визуально. CLI нужен для запуска из терминала и автоматизации. В нашем проекте фактически проверен именно CLI 4.3.0. Мастерская ниже показывает его результаты в собственном интерфейсе сайта; она не изображает окно Bruno Desktop и не требует установки настольного приложения для чтения статьи.
Мы используем формат .bru: один текстовый файл описывает запрос, его тело, скрипты и тесты; bruno.json обозначает корень коллекции. Это позволяет видеть изменения обычным diff: поменялся URL, поле JSON или ожидаемое значение. Bruno также развивает OpenCollection YAML; для этого материала выбран поддерживаемый .bru, чтобы весь скачанный набор можно было повторить одной закреплённой версией CLI.
Открытая основа проекта и коммерческие возможности продукта — разные уровни. Все опыты статьи выполнены локальным пакетом @usebruno/cli без платной активации. Не переносите это утверждение автоматически на каждую функцию Desktop или корпоративную интеграцию: актуальное разделение описано в документации лицензирования.
Мини-мастерская: восемь тем и четырнадцать реальных запросов
Выберите задачу слева или в мобильном списке. Откройте заголовки, сравните тело исходящего запроса с ответом, затем прочитайте проверки. Кнопка «Показать по шагам» последовательно раскрывает сохранённые части опыта. В теме пагинации есть обычный запрос и три строки набора данных, в авторизации — три связанных запроса, в последней теме — неправильное и исправленное ожидание.
Каждый пример сопровождается исходным .bru. Его можно скопировать или скачать, а всю коллекцию получить отдельным ZIP. Генератор команды помогает выбрать PowerShell или Bash, адрес своего тестового стенда и формат отчёта. Он создаёт текст команды, не выполняет запросы из браузера. Для запуска служит скачиваемый проект, где поднимается собственный API на loopback.
Механизм обозначен прямо: мастерская воспроизводит записи настоящего Bruno CLI в Safe Mode. Ответы, тесты и времена взяты из реального выполнения; временный адрес и пути нормализованы. Это не симуляция сервера на JavaScript в странице. Свою изменённую коллекцию нужно запускать локально, а не пытаться редактированием видимого JSON изменить уже записанный результат.
Что находится в архиве и какие версии использованы
В package-lock.json закреплены @usebruno/cli 4.3.0 и Bootstrap 5.3.9. Для повторения рекомендуем Node.js 24 LTS. Фактические проверки сделаны на Node 24.19.0 в Windows и Node 24.22.2 в чистом Linux-контейнере. Нижняя граница собственного проекта задана как Node 22.19; отдельный прогон на каждой допустимой минорной версии здесь не заявляется.
Каталог src содержит учебный HTTP API, collection — запросы и окружение Local, tools — запуск CLI, построение записи и статический сервер, tests — проверки границ API и целостности отчётов. В public лежит готовая мастерская и результаты. Зависимости node_modules не нужно переносить между системами: npm ci устанавливает их по lock на той ОС, где выполняется опыт.
Документ docs/LINUX-CI.md объясняет серверный запуск и обработку кода завершения. README содержит быстрый путь для обеих ОС. Собственный код распространяется под MIT, зависимости сохраняют свои лицензии. Установка с –ignore-scripts фактически проверена: этому стенду не понадобились произвольные install-скрипты пакетов. Новую версию CLI сначала проверяйте отдельной веткой, сохраняя прежний lock.
bruno-project/
  collection/
    bruno.json
    environments/Local.bru
    scenarios/*.bru
    dataset/pages.bru
    data/pagination.json
    failure/08-contract-broken.bru
  src/api.mjs
  tools/capture.mjs
  public/recording.json
  public/reports/
  docs/LINUX-CI.md
  package.json
  package-lock.json
Первый запуск в Windows: один воспроизводимый опыт
Распакуйте ZIP в обычный каталог, откройте PowerShell и перейдите в корень проекта. Сначала проверьте Node, затем установите зависимости по lock. В командах используется npm.cmd: так запуск не зависит от политики исполнения одноимённого PowerShell-скрипта npm.ps1. Это не требует ослабления системной политики и установки CLI глобально.
Команда capture сама запускает собственный API на свободном локальном порту, вызывает Bruno, сохраняет отчёты и закрывает сервер. Build добавляет локальный Bootstrap, исходники для просмотра и ZIP коллекции. Test проверяет границы учебного API и соответствие записи текущему коду. После start мастерская доступна на 127.0.0.1:8515; для завершения достаточно Ctrl+C в её терминале.
Первый запуск требует загрузки npm-зависимостей. После установки запросы опытов обращаются только к нашему loopback API, а страница использует локальные ресурсы. Если вы открыли index.html как файл и не видите данные, используйте npm start: загрузка recording.json рассчитана на HTTP-сервер, а поведение file:// ограничивается политиками браузера.
node --version
npm.cmd ci --ignore-scripts --no-audit --no-fund
npm.cmd run capture
npm.cmd run build
npm.cmd test
npm.cmd start
# http://127.0.0.1:8515
# Остановка: Ctrl+C
Linux: тот же проект на рабочей машине и сервере
На Linux последовательность та же, только команда называется npm без суффикса .cmd. Используйте поддерживаемый Node LTS из выбранного способа установки и проверьте node –version до npm ci. Не копируйте node_modules из Windows и не устанавливайте зависимости случайно от root, если дальше проект должен обслуживать отдельный непривилегированный пользователь.
На VPS разместите исходники, например, в /srv/api-checks/bruno-project. Это каталог инструментов проверки, а не публичный webroot. Сам Bruno CLI выполняет работу и завершается, поэтому постоянный systemd-сервис ему не нужен. Если задача запускается после deploy, её место — шаг процесса выпуска или отдельная контролируемая команда с сохранением exit code и отчётов.
Для просмотра мастерской с удалённого сервера удобно использовать SSH-туннель. Статический сервер остаётся привязан к 127.0.0.1, а вы открываете страницу на своём компьютере. Учебный API не стоит публиковать наружу: он содержит фиксированные данные авторизации, хранит записи в памяти и создан для повторения примеров. Практика проверки собственного staging API разобрана ниже.
cd /srv/api-checks/bruno-project
npm ci --ignore-scripts --no-audit --no-fund
npm run capture
npm run build
npm test
npm start

# В другом терминале на своём компьютере:
ssh -L 8515:127.0.0.1:8515 user@your-server
API лаборатории: достаточно реалистичный и предсказуемый
Наш сервис содержит каталог услуг и заявки. Услуги имеют ID, название, признак активности и цену; созданная заявка получает ID, клиента, количество и статус draft. Это небольшой предметный контекст, в котором понятно, зачем фильтровать список, передавать JSON и читать созданную сущность. Пользовательские данные полностью вымышлены.
Сервис специально предсказуем: каталог фиксирован, заявки живут в памяти процесса, а перезапуск создаёт чистое состояние. Так результат теста не зависит от того, что вчера удалил другой разработчик. Контроллер capture каждый раз поднимает новый экземпляр API. В ручном режиме npm run api держит один экземпляр на 8516, и созданные заявки сохраняются до его остановки.
Это рабочий HTTP-стенд для обучения проверкам, но не готовый backend CRM. В нём нет постоянной БД, полноценного login, JWT-подписи и настоящего лимитера. Эти ограничения важны: фиксированный 429 демонстрирует контракт ответа, а публичный токен — передачу Bearer. Не переносите учебные упрощения в production, когда заменяете сервис собственной реализацией.
# Отдельный терминал, из корня проекта:
npm run api
# API: http://127.0.0.1:8516
# Windows: npm.cmd run api
# Перезапуск очищает только in-memory данные этого процесса.
Тема 1. GET и готовность сервиса
Проверка health полезна перед запуском более длинного набора. Если приложение не поднялось, остальные двадцать ошибок будут только отвлекать. Но одного HTTP 200 недостаточно: на нужном порту может отвечать другой сервис или страница reverse proxy. Поэтому наш запрос проверяет статус, идентификатор bruno-demo и числовую версию.
В файле .bru блок meta задаёт имя и порядок, get — адрес и тип запроса. В assert находятся короткие декларативные проверки. Рядом можно разместить JavaScript-тесты с выразительными названиями. В мастерской видны обе группы: это удобный способ сравнить компактную проверку поля и более гибкую логику test/expect на одном ответе.
Названия тестов должны объяснять поломку человеку. «Статус готовности равен ok» полезнее, чем «Test 1». В большом наборе именно описание попадёт в отчёт и поможет дежурному понять, нужен ли откат, проверка адреса или исправление формата. Пример не измеряет готовность всех зависимостей реального приложения: содержимое production health определяется вашим контрактом.
meta {
  name: Готовность API
  type: http
  seq: 1
}
get {
  url: {{baseUrl}}/health
  body: none
  auth: none
}
assert {
  res.status: eq 200
  res.body.status: eq ok
}
Тема 2. Параметры: фильтры и пагинация таблицы
Представьте административную таблицу услуг. Интерфейс отправляет active=true, page=2 и limit=2, но после изменения backend фильтр активности перестаёт учитываться. Запрос остаётся успешным, JSON выглядит правдоподобно, а пользователь видит архивные строки. Проверка только статуса такую ошибку пропустит; нужны ожидания по смыслу списка.
В нашем каталоге четыре активные услуги. Вторая страница по две строки должна вернуть ID 4 и 5, а total — 4. Тест проверяет именно эти значения. Обратите внимание на смысл total: это количество найденных элементов до разбиения на страницы, а не длина текущего массива. Если frontend использует total для кнопки «Следующая», неверный подсчёт становится видимым дефектом интерфейса.
В реальном API зафиксируйте также сортировку. Без определённого порядка одна и та же страница может содержать разные записи даже при неизменном количестве. Добавьте границы: пустую выдачу, недопустимый limit, последнюю страницу. Наш стенд ограничивает limit диапазоном 1–10 и возвращает 422 на неправильный размер, чтобы ошибка параметра не превращалась в случайное поведение.
get {
  url: {{baseUrl}}/services?page=2&limit=2&active=true
  body: none
  auth: none
}
tests {
  test("Вторая страница содержит нужные ID", function () {
    expect(res.getBody().items.map(function (x) { return x.id; }))
      .to.deep.equal([4, 5]);
  });
  test("Всего четыре активные услуги", function () {
    expect(res.getBody().total).to.equal(4);
  });
}
Набор данных: три страницы одним запросом-шаблоном
Повторять один и тот же .bru ради другого номера страницы неудобно: после изменения контракта придётся править все копии. В каталоге dataset лежит один запрос, где page подставляется из строки JSON-набора. В data/pagination.json описаны первая, вторая и пустая третья страницы вместе с ожидаемыми ID.
Bruno CLI запускает запрос для каждой строки. В тесте данные текущей итерации читаются через bru.runner.iterationData.get(), затем полученный массив сравнивается с expectedIds. Это фактически выполненный пример: три HTTP-запроса и шесть успешных JS-тестов добавлены в мастерскую и отдельный отчёт dataset.json. Пустой массив третьей страницы здесь считается корректным результатом.
Такая организация полезна для диапазонов, фильтров, ролей и допустимых сочетаний полей. Начинайте с небольшого осмысленного набора, где для каждой строки понятно ожидание. Сотни случайных строк без хороших assertions создают время выполнения, но мало уверенности. Набор входов должен находиться в Git рядом с запросом, а реальные персональные данные в него переносить не нужно.
[
  {"page": 1, "expectedIds": [1, 2]},
  {"page": 2, "expectedIds": [4, 5]},
  {"page": 3, "expectedIds": []}
]

# Из collection, Linux:
../node_modules/.bin/bru run dataset --env Local --sandbox safe --json-file-path data/pagination.json
# Windows: ..\node_modules\.bin\bru.cmd с теми же аргументами.
Тема 3. POST JSON: создание заявки
Для формы важен не только факт отправки. Нужно проверить, что сервер принял значения, создал сущность и вернул данные, которые потребуются интерфейсу дальше. Наш POST /orders отправляет имя учебной компании и quantity=3. Ответ получает статус 201, новый ID, исходное количество и draft. Заголовок Location указывает путь созданной заявки.
В коллекции body:json хранит обычный JSON без лишней shell-экранизации. Это особенно удобно в Windows: сложное тело не нужно протаскивать через несколько уровней кавычек командной строки. Команда запускает файл, а содержимое запроса остаётся одинаковым для разных терминалов. Поэтому копировать готовую коллекцию обычно надёжнее, чем пересылать длинную однострочную команду.
В собственном приложении добавьте проверки значимых преобразований: обрезки пробелов, вычисленного статуса, значения валюты или обязательных полей. При этом не сравнивайте весь ответ с жёсткой копией, если часть полей закономерно меняется: время, случайный ID, техническая метка. Проверяйте их тип и нужные ограничения, а конкретные бизнес-значения сравнивайте точно.
post {
  url: {{baseUrl}}/orders
  body: json
  auth: none
}
body:json {
  {"customer":"Учебная компания","quantity":3}
}
tests {
  test("Создано", function () {
    expect(res.getStatus()).to.equal(201);
  });
  test("Количество сохранено", function () {
    expect(res.getBody().quantity).to.equal(3);
  });
}
Тема 4. Цепочка: создать и прочитать полученный ID
Жёстко прописанный /orders/100 быстро начинает мешать. На другом стенде этот ID занят, после очистки отсутствует, а повторный запуск создаёт уже следующую запись. Практический сценарий должен брать идентификатор из ответа на создание и передавать его следующему запросу. Именно так проверяется связанная пользовательская операция, а не случайная заранее подготовленная строка.
В post-response script после успешного 201 мы сохраняем createdOrderId через bru.setVar. Следующий .bru использует {{createdOrderId}} в URL, затем проверяет совпадение ID и статус draft. Переменная живёт в ходе запуска. Она не должна превращаться в постоянное значение environment-файла, иначе тест начнёт зависеть от старой сущности.
Порядок здесь является частью сценария: create стоит перед read. Не включайте –parallel для такой цепочки. Если запустить только read-created отдельно, переменная не будет определена; это ожидаемая зависимость, а не ошибка Bruno. Для собственного сервиса завершайте цепочку уборкой созданных объектов по их ID либо работайте в отдельной тестовой БД с предсказуемым сбросом.
script:post-response {
  if (res.getStatus() === 201) {
    bru.setVar("createdOrderId", res.getBody().id);
  }
}

# В следующем .bru:
get {
  url: {{baseUrl}}/orders/{{createdOrderId}}
  body: none
  auth: none
}
tests {
  test("Получили созданную заявку", function () {
    expect(res.getBody().id).to.equal(bru.getVar("createdOrderId"));
  });
}
Тема 5. Негативный тест: 422 и ошибки полей
Успешная отправка формы — только часть контракта. Пользователь может оставить имя пустым, отправить ноль, вставить строку вместо числа. Интерфейсу нужно понять, какое поле подсветить и какой текст показать. Поэтому ошибка валидации должна иметь устойчивую структуру, а не просто свободное сообщение, которое frontend вынужден разбирать по словам.
Мы отправляем пустой customer и quantity=0, ожидаем HTTP 422, error=validation и отдельные поля customer/quantity. В мастерской этот запрос зелёный: сервер корректно отклонил неправильные данные, а тест проверил ожидаемый отказ. Это важное различие между ошибкой пользовательского ввода и падением проверки API.
Отдельные node:test-проверки исходного проекта также проверяют испорченный JSON, null, массив вместо объекта и слишком большое тело. Полноценный production-валидатор может быть сложнее. Если нужен системный разбор схем, на сайте есть руководство по Ajv и JSON Schema. Bruno в этом случае проверяет внешний ответ, а валидатор отвечает за правила внутри сервера.
body:json {
  {"customer":"","quantity":0}
}
tests {
  test("Ожидаем ошибку валидации", function () {
    expect(res.getStatus()).to.equal(422);
  });
  test("Есть обе ошибки полей", function () {
    expect(res.getBody().fields).to.have.property("customer");
    expect(res.getBody().fields).to.have.property("quantity");
  });
}
Тема 6. Авторизация: без токена, сессия, Bearer
У закрытого метода нужно проверить как минимум два состояния: доступ без учётных данных запрещён, с корректными данными разрешён. Если тестировать только успешный запрос, можно пропустить случайно снятую авторизацию. В мастерской сначала вызывается /private без токена и проверяется 401. Затем /session выдаёт учебный токен, а третий запрос отправляет его в Authorization.
Токен сохраняется в runtime-переменной demoToken. Это демонстрирует реальный перенос значения между ответом и следующим запросом. Но сам login предельно упрощён: username=demo, password=workshop-only, токен фиксированный. Такие значения опубликованы намеренно и не дают доступ к внешнему сервису. В примере нет выпуска JWT, обновления refresh token и проверки пароля по БД.
Для реального API расширяйте набор по своим правилам: неверный токен, истёкшая сессия, отсутствие нужного права, доступ к чужой сущности. Не смешивайте 401 и 403 без понимания контракта. Наш успешный ответ содержит demo:read; тест подтверждает это разрешение. Заголовок Authorization в отчёте CLI замаскирован, но тело ответа login всё равно требует отдельного внимания перед публикацией.
script:post-response {
  if (res.getStatus() === 200) {
    bru.setVar("demoToken", res.getBody().accessToken);
  }
}

# В запросе к /private:
headers {
  Authorization: Bearer {{demoToken}}
}
Окружения и секреты: адрес отдельно от учётных данных
Одна коллекция обычно работает с несколькими стендами. Адрес baseUrl удобно держать в окружении Local, а для staging передать другое значение при запуске. Менять URL вручную в каждом запросе неудобно и опасно: часть файлов может остаться направленной на старый сервер. Начинайте каждый запуск с ясного понимания, куда он пойдёт и какие данные изменит.
Секреты не должны попадать в Git вместе с окружением. В Bruno можно ссылаться на переменные процесса, например {{process.env.API_TOKEN}}; детали описаны в руководстве по process environment. Локальный приватный .env исключайте из Git, а на CI используйте хранилище секретов провайдера. В архиве реальных ключей нет.
Не вставляйте настоящий токен прямо в командную строку ради удобства: он может остаться в истории или диагностике процесса. Также не считайте маску заголовка полной очисткой отчёта. Секрет способен находиться в query, теле login, cookie или тексте ошибки. Перед выдачей артефактов другим людям проверьте, что сохраняет конкретный reporter и кому доступен файл.
# Безопасный несекретный адрес стенда можно переопределить:
../node_modules/.bin/bru run scenarios --env Local \
  --env-var 'baseUrl=https://staging.example.test' \
  --sandbox safe

# В приватной коллекции значение заголовка может ссылаться на:
# Authorization: Bearer {{process.env.API_TOKEN}}
# Сам API_TOKEN задаётся секретом CI, не хранится здесь.
Тема 7. Ответ 429: проверяем инструкцию для клиента
Когда API ограничивает частоту операций, клиенту мало увидеть ошибку. Ему нужна понятная реакция: показать паузу, отложить повтор или предложить вернуться позже. Для этого контракт может включать HTTP 429, машинный код причины и Retry-After. Проверка такого ответа помогает не сломать поведение интерфейса при обновлении backend или reverse proxy.
Endpoint /rate-limited в нашей fixture намеренно всегда возвращает 429 и Retry-After: 2. Тест проверяет статус, заголовок и error=rate_limit. Это настоящий HTTP-ответ и настоящий запуск Bruno, но сервер здесь не считает квоты. Автоматический retry также не выполняется: цель опыта — увидеть и проверить договорённость между сервером и клиентом.
Для реального лимитера нужен отдельный сценарий: допустимые первые запросы, превышение, восстановление после окна, изоляция разных клиентов. А для клиентских повторов — предел попыток и правила безопасности операций. На сайте есть материал об Undici, таймаутах и повторных запросах; он помогает перейти от проверки ответа к поведению Node.js-клиента.
tests {
  test("Лимит обозначен статусом", function () {
    expect(res.getStatus()).to.equal(429);
  });
  test("Сервер указал паузу", function () {
    expect(res.getHeader("retry-after")).to.equal("2");
  });
  test("Причина машиночитаема", function () {
    expect(res.getBody().error).to.equal("rate_limit");
  });
}
Тема 8. HTTP 200 не означает, что проверка пройдена
Последний опыт показывает частую ошибку автоматизации: считать любой успешный HTTP-ответ признаком корректной работы. Наш /contract возвращает total=42. В намеренно сломанном тесте ожидается 99. Сервер отвечает 200, проверка статуса проходит, а проверка числа падает. Bruno CLI завершается кодом 1, что позволяет остановить дальнейший шаг выпуска.
В мастерской переключите второй вариант: тот же ответ сравнивается с правильным ожиданием 42, и набор проходит. Меняется тест, а не работа сервера. В реальной диагностике нельзя просто подгонять ожидание под любой фактический результат: сначала выясните, где правда — в согласованном контракте, тестовых данных или реализации. Здесь неверное 99 выбрано специально для учебного опыта.
Отрицательный запрос лежит отдельно в failure, чтобы его нельзя было случайно принять за обычную зелёную проверку. Capture ожидает падения именно этой папки и проверяет его. Поэтому общий сценарий лаборатории завершится успешно, если продемонстрировал оба поведения. Для своего CI запускайте нормальный набор и сохраняйте ненулевой код как ошибку, не подавляя её через || true.
tests {
  test("Транспорт работает", function () {
    expect(res.getStatus()).to.equal(200);
  });
  test("Намеренно неверное ожидание", function () {
    expect(res.getBody().total).to.equal(99);
  });
}

# Исправленный вариант ожидает .to.equal(42)
# CLI для папки failure: exit 1, несмотря на HTTP 200.
Как писать проверки, которые обнаруживают полезные ошибки
Хороший тест связывает ответ с действием пользователя. Для списка важны фильтр, порядок и total. Для создания — ID, сохранённые значения и статус. Для валидации — конкретные поля. Для закрытого метода — допустимое разрешение и отказ без токена. Такой набор объясняет, почему ошибка важна, и помогает быстро определить затронутый экран.
Избегайте проверок, которые всегда истинны или ничего не уточняют: «тело существует» недостаточно для сложного отчёта. С другой стороны, не фиксируйте все технические заголовки и каждую временную метку без необходимости. Слишком хрупкий тест ломается на безвредном изменении, приучает команду игнорировать красные результаты и постепенно теряет ценность.
Встроенные test/expect позволяют писать проверки на JavaScript. Их актуальная форма показана в официальном разделе Tests. Начинайте с нескольких ясных ожиданий, затем добавляйте найденные регрессии. Когда ошибка однажды произошла, полезно сохранить минимальный запрос, который воспроизводит её и защищает от возвращения.
tests {
  test("У заявки правильное состояние", function () {
    var body = res.getBody();
    expect(body.id).to.be.a("number");
    expect(body.status).to.equal("draft");
    expect(body.quantity).to.equal(3);
  });
}
Safe Mode и скрипты: оставляем понятные границы исполнения
Коллекция может содержать код, который выполняется до или после запроса. В нашем примере достаточно встроенных объектов bru/res и Chai-проверок. Внешние npm-пакеты внутри .bru, чтение файлов и запуск системных команд не используются. Поэтому Safe Mode задан явно во всех командах; ради этих опытов переходить в Developer Mode не требуется.
Это полезно и для командной работы. Перед принятием чужой коллекции просматривайте не только URL, но и scripts/tests, окружения и направление запросов. Проверка контрактов должна оставаться обозримой. Большой скрытый скрипт, который сам создаёт десятки дополнительных запросов, сложнее диагностировать и сложнее передать следующему разработчику.
Для расширенной оркестрации у Bruno есть отдельные методы цепочек, описанные в Request Chaining. В этой статье выбран более простой последовательный набор файлов с runtime-переменными. Такая структура удобна для первого рабочего проекта: любой участник видит порядок операций и может открыть конкретный запрос, который упал.
Ручной CLI в PowerShell: окружение и код завершения
Автоматический capture удобен для повторения всей лаборатории. Для изучения одного запроса запустите API отдельно в первом терминале, а во втором перейдите в collection. Этот каталог содержит bruno.json; именно из него относительные пути запросов и наборов данных имеют ожидаемый смысл. CLI берётся из локального node_modules, поэтому случайно установленная глобальная версия не вмешивается.
После команды проверьте $LASTEXITCODE сразу. Если запуск является шагом Windows CI, передайте ненулевой код наружу, а не продолжайте deploy как будто всё прошло. Не ориентируйтесь только на наличие файла отчёта: reporter может создать файл и для упавших тестов. Истиной остаётся итог процесса вместе с результатами проверок.
Одиночный GET health можно выполнить независимо. А чтение createdOrderId требует предшествующего создания в том же запуске. Это удобный способ понять границы коллекции: некоторые файлы — самостоятельные smoke-проверки, другие — звенья сценария. Дайте им понятные имена и не скрывайте зависимости, когда передаёте набор коллеге.
# API запущен через npm.cmd run api в первом терминале.
# Во втором терминале, из корня проекта:
Set-Location collection
..\node_modules\.bin\bru.cmd run scenarios --env Local --sandbox safe --reporter-json ../results.json --reporter-junit ../results.xml
$brunoExit = $LASTEXITCODE
if ($brunoExit -ne 0) { exit $brunoExit }

# Независимый одиночный запрос:
..\node_modules\.bin\bru.cmd run scenarios/01-health.bru --env Local --sandbox safe
Linux и CI: проверка после выкладки
В процессе выпуска обычно сначала поднимается тестовый сервис, затем проверяется его готовность и выполняется короткая коллекция. Если обязательный тест падает, следующий этап не продолжается. Сохраняйте JUnit/JSON даже при ошибке, чтобы разработчик мог понять причину. Конкретный синтаксис загрузки artifacts зависит от CI-провайдера; переносить команды можно без привязки к одному интерфейсу.
В Bash set -euo pipefail помогает корректно останавливать shell-скрипт, особенно если вывод идёт через pipe. Для самостоятельного bru-run сохраняйте его код завершения. Флаг –bail полезен, когда после первого существенного сбоя дальнейшие действия бессмысленны. При диагностике полного набора его можно убрать, чтобы увидеть несколько независимых нарушений за один прогон.
Пример ниже проверяет именно скачанную лабораторию: capture сам контролирует ожидаемое падение учебного failure. Для своего staging используйте отдельный запуск scenarios, адаптируйте маршруты и ожидаемые данные, предусмотрите очистку. Внешняя CI-платформа и production VPS в рамках этого материала не развёртывались; Linux-команды проверены на отдельном чистом локальном контейнере.
set -euo pipefail
npm ci --ignore-scripts --no-audit --no-fund
npm run capture
npm run build
npm test

# Для своего API после адаптации коллекции:
cd collection
../node_modules/.bin/bru run scenarios --env Local \
  --env-var 'baseUrl=https://staging.example.test' \
  --sandbox safe --bail \
  --reporter-junit ../results.xml \
  --reporter-json ../results.json
JSON и JUnit: читать отчёт и не терять смысл ошибки
JSON удобен для подробного разбора: запрос, ответ, проверка и диагностические поля остаются рядом. JUnit нужен многим системам CI, которые умеют показать список тестов, длительность и падения. Оба формата получены настоящими командами нашего CLI и доступны для скачивания. Генератор мастерской позволяет собрать команду с нужным reporter.
Не делайте вывод только по слову pass у отдельного технического поля результата. В нашем обработчике для отображения учитываются assertionResults и testResults, а также код завершения всего запуска. Это существенно в опыте HTTP 200: успешная передача запроса не отменяет упавшее бизнес-ожидание. Исходный отчёт сохранён отдельно, поэтому производное представление можно проверить.
Перед хранением отчётов реального сервиса решите, нужны ли полные тела и заголовки. CLI поддерживает их исключение; точные варианты перечислены в справке run options и разделе Reports. Наши полные ответы безопасны для публикации, потому что это специально созданные учебные фикстуры, а не выгрузка настоящих пользователей.
../node_modules/.bin/bru run scenarios --env Local --sandbox safe \
  --reporter-json ../results.json \
  --reporter-junit ../results.xml \
  --reporter-skip-body \
  --reporter-skip-all-headers
Git: полезный diff вместо коллекции на одном компьютере
Когда запросы находятся в проекте, их изменения можно обсуждать вместе с изменениями API. В pull request видно: добавился обязательный параметр, поменялся статус ошибки, исчезло поле или изменилось ожидаемое количество. Коллега получает не только описание словами, но и проверку, которую можно выполнить на своей ветке.
Держите структуру папок близко к пользовательским действиям: заявки, каталог, права, отчёты. Называйте запросы по смыслу, а не «New Request 7». Негативные проверки могут быть зелёными, если отказ ожидается; намеренно сломанные учебные варианты лучше хранить отдельно, как сделано в failure. Это снижает риск случайно включить демонстрационный FAIL в обязательный рабочий набор.
В Git должны попасть .bru, несекретные окружения, наборы данных и lock. Не коммитьте node_modules, приватный .env и сырые отчёты production. Для опубликованной лаборатории сохранённые отчёты являются частью примера; в рабочем продукте обычно удобнее хранить их как артефакты конкретного запуска, связывая с коммитом и окружением, а не бесконечно обновлять в исходниках.
# Фрагмент .gitignore
node_modules/
.runtime/
.env
collection/.env
collection/environments/Private.bru
results.json
results.xml
results.html
Как связать Bruno с документацией и клиентским кодом
Документация объясняет потребителю доступные операции, схема описывает форму данных, клиентская библиотека выполняет запросы внутри приложения, а коллекция проверяет выбранные сценарии. Эти роли хорошо дополняют друг друга. Даже подробный OpenAPI-контракт не заменяет проверку того, что после POST можно получить созданную сущность с правильным состоянием.
Полезный процесс выглядит так: согласовать контракт, реализовать endpoint, добавить запрос и тест, затем использовать тот же сценарий при изменениях. Если схема поменялась, обновляйте документацию и коллекцию в одном изменении. Если нашли баг в реальном пользовательском действии, сохраните его минимальную последовательность в отдельной папке регрессии.
На стороне Node.js выполнять рабочие интеграции можно через Undici и fetch, а проверять JSON-контракты — через Ajv. Bruno при этом остаётся независимым потребителем API: он способен заметить проблему, которую внутренний тест функции не увидит из-за маршрутизации, заголовков или преобразования ответа.
Функциональная проверка и нагрузочный тест решают разные задачи
В отчёте видно время ответа, а CLI умеет повторять коллекции. Это удобно для наблюдения, но само по себе не создаёт корректный нагрузочный эксперимент. В нашей мастерской каждый показатель времени относится к конкретному localhost-запросу в учебном запуске. Сравнивать по нему производительность разных ОС, серверов или библиотек нельзя.
Функциональная коллекция отвечает на вопрос, выполнился ли ожидаемый сценарий. Нагрузочная проверка требует модели пользователей, интенсивности, прогрева, длительности и порогов. Кроме того, повторяющиеся POST могут создавать новые записи и внешние эффекты. Перед массовым повторением убедитесь, что у вас отдельные тестовые данные и контролируемые интеграции.
Для нагрузки на сайте есть подробная мастерская k6. Практичный порядок работы: сначала убедиться коллекцией Bruno, что контракт выполняется, затем измерять поведение под выбранной нагрузкой. Красивый график быстрых ответов не помогает, если API всё время возвращает не те данные.
Диагностика: адрес, порт, зависимости и TLS
ECONNREFUSED обычно означает, что API не запущен или адрес не соответствует месту выполнения команды. localhost внутри контейнера относится к этому контейнеру, а не автоматически к Windows-хосту. В наших автоматических опытах API и CLI работают рядом; для внешнего staging нужно указать реальный адрес и проверить доступ из runner.
Если возникает 404 при чтении заявки, убедитесь, что create выполнен в том же запуске и сервер не перезапускался между запросами. Если видите 401, проверьте выбранное окружение и способ передачи токена. Если 422 пришёл там, где ожидается 201, откройте тело запроса и ошибки полей. Эти ситуации не лечатся увеличением таймаута или отключением проверки статуса.
При TLS-ошибке настройте доверие к нужному CA и имя сертификата. Не превращайте –insecure в постоянный режим рабочего набора. Если после изменения файлов тест записи сообщает о неверном SHA-256, повторите capture и build. Ручное исправление JSON-отчёта лишь скрывает рассогласование между кодом и результатом и лишает пример воспроизводимости.
Что действительно проверено в исходном проекте
На Windows и Linux выполнены одинаковые три запуска Bruno 4.3.0 в Safe Mode. Основной набор дал 10 успешных запросов, 26 успешных JS-тестов и 2 assertions. JSON-набор добавил 3 запроса и 6 успешных тестов. Отдельная папка failure дала HTTP 200, один успешный тест, один ожидаемо упавший тест и код завершения 1.
Дополнительно на обеих ОС прошли 14 проверок node:test. Они проверяют неправильные параметры, JSON, null, массив, размер тела, создание/чтение, изоляцию данных между экземплярами API, неверные учебные credentials, фиксированный 429 и целостность записи. Сверяются SHA-256 файлов коллекции, API, capture и lock, а исходники в просмотрщике сравниваются с файлами проекта.
Linux-прогон выполнялся после чистого npm ci в отдельном временном контейнере, Windows — нативным Node. Это проверка локальной воспроизводимости, не гарантия работоспособности любого чужого API. После адаптации коллекции тестируйте реальные маршруты своего стенда, правила авторизации, очистку данных и права CI. Зависимости и тестовые ожидания должны обновляться вместе с проектом.
Скачать, адаптировать и оставить работающий набор
Скачайте полный проект, повторите capture и начните с одной полезной операции своего сервиса. Замените endpoint, подготовьте отдельные тестовые данные, напишите несколько проверок, которые отражают реальное действие пользователя. Затем добавьте отказ и границу: пустой список, неверное поле, отсутствие токена. Такой набор сразу полезнее случайного десятка запросов без ожиданий.
Оставьте понятную инструкцию: чем устанавливать зависимости, как выбрать окружение, какой набор является обязательным и где смотреть отчёты. Для связанных действий явно обозначьте порядок и уборку созданных сущностей. Если результат должен блокировать выпуск, проверьте это намеренной ошибкой на тестовом стенде: CI действительно должен остановиться, а диагностический файл — сохраниться.
После работы закройте только свои серверы через Ctrl+C. Capture уже закрывает свой API автоматически; удалять общие Docker-ресурсы или чужие процессы не требуется. Для дальнейшей справки используйте Bruno CLI, запуск коллекций и наборов данных и исходный код Bruno. Все показанные коллекции и мастерская входят в архив.