Kysely в Node.js: SQL и TypeScript — мастерская и 9 практических задач
Видим SQL, параметры и результат: девять задач на Kysely и SQLite, ошибки типов до запуска, откат транзакции и миграции. Мастерская, исходники, Windows/Linux.
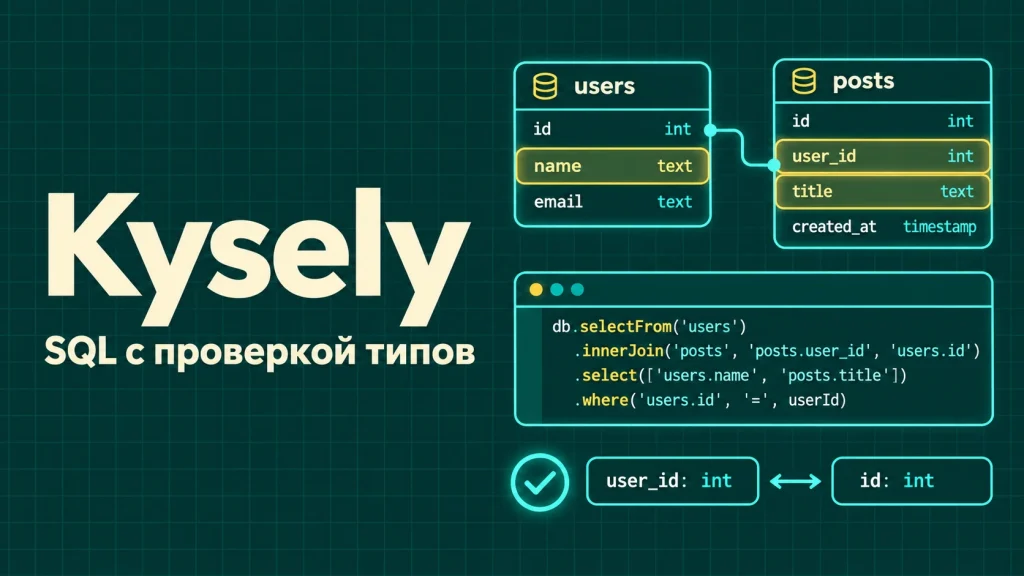
Kysely и TypeScript на практике: SQL, параметры, JOIN, суммы, транзакции, курсоры и миграции. Девять задач, восемнадцать настоящих опытов и исходники Windows/Linux.
Kysely: SQL остаётся понятным, а ошибки видны раньше
Когда Node.js-приложение получает данные из базы, ошибки возникают на разных уровнях. Можно опечататься в названии столбца, передать строку вместо суммы, забыть про null или собрать неправильную связь таблиц. Часть проблем проявляется только при выполнении запроса. Kysely помогает обнаружить некоторые из них ещё в TypeScript-коде, сохраняя привычную структуру SQL.
Это построитель запросов: вы описываете SELECT, WHERE, JOIN, INSERT и транзакции цепочкой методов, а библиотека формирует SQL и параметры для драйвера. При этом SQL не исчезает за непрозрачной моделью. Его можно посмотреть, объяснить, проверить и сопоставить с реальным результатом базы. Знание SQL остаётся полезным и необходимым.
В статье разберём девять задач на примере небольшого сервисного бизнеса. В мастерской доступны восемнадцать настоящих опытов: исходный запрос, параметры, строки, состояние до и после, ошибки SQLite и диагностика TypeScript. Архив позволяет повторить выполнение на Windows и Linux, изменить данные и применить подход в своём API, кабинете или инструменте импорта.
Где применять: кабинеты, отчёты, интеграции и фоновые задачи
Kysely пригодится проекту, где запросы должны быть явными, а код написан на TypeScript. Например, административная панель получает заявки с фильтрами, показывает имя клиента через JOIN и считает суммы по статусам. В одном месте нужны пять полей карточки, в другом — агрегированный отчёт. Для каждой операции можно описать ровно необходимую выборку.
Другой сценарий — интеграция. Внешняя система передала заявку с уникальным идентификатором, приложение проверяет вход, добавляет запись и событие аудита. Повтор ID должен давать контролируемый исход, а ошибка в середине операции не должна оставлять половину данных. Здесь полезны ограничения БД и транзакции вместе с типизированным кодом.
Библиотека не создаёт авторизацию, HTTP-маршруты и правила доступа к организации. Эти задачи остаются в приложении. Для серверного маршрута можно использовать подход из статьи про Hono, а Kysely поместить в слой доступа к данным. В текущем архиве нет публичного API, принимающего произвольный SQL.
Kysely, драйвер и SQLite: кто за что отвечает
Kysely строит запрос и передаёт его драйверу. В нашем проекте встроенный SQLite dialect использует better-sqlite3, а настоящие операции выполняет SQLite. TypeScript описывает ожидаемые таблицы и типы столбцов. Получаются три разных обязанности: построение запроса, доставка и выполнение, проверка кода при компиляции.
Такая схема отличается от ORM с сущностями, автоматической загрузкой связей и сохранением изменённых объектов. Здесь связь таблиц выражается JOIN, набор полей — SELECT, изменение — INSERT или UPDATE. Это удобно разработчику, которому важен контроль конкретного SQL. Но библиотека не исправляет неправильное условие JOIN и не выбирает индекс вместо вас.
Основы самой базы разобраны в практической статье про SQLite. Если приходите из PHP, начните также с главы нашего мануала SQL и PDO с нуля: таблицы, параметры и результаты подчиняются тем же общим принципам, хотя API языка отличается.
Версии и данные лаборатории
Проект закрепляет Kysely 0.29.9, better-sqlite3 13.1.1, TypeScript 7.0.2 и Bootstrap 5.3.9. В проверенных запусках драйвер использовал SQLite 3.54.1. Для повторения выбран Node.js 24 LTS не ниже 24.15. Версии сверены 13 ноября 2026 года; package-lock.json сохраняет конкретный набор зависимостей.
В базе четыре клиента и шесть заявок. Одна заявка не имеет клиента, а один клиент ещё не имеет заявок. Две записи получили одинаковое время создания, чтобы проверить составной курсор. Суммы хранятся в целых копейках, примечание может быть null. Эти небольшие особенности делают примеры полезнее единственного счастливого SELECT.
Каждый опыт создаёт отдельную SQLite в памяти и закрывает соединение после проверки. Существующие файлы базы не открываются. Поэтому можно изучать INSERT, rollback и DOWN без подключения своих данных. Официальное руководство по началу работы объясняет настройки dialect и обязательный strict-режим TypeScript.
npm ci --ignore-scripts
npm test
npm run capture
npm run build
Мини-мастерская: сравнивайте запрос, параметры и результат
Выберите практическую задачу и вариант. Например, сравните INNER JOIN с LEFT JOIN, успешный INSERT с повтором ID или commit с rollback. Ниже находятся реально выполненные команды. В списке можно перейти к нужному SELECT, INSERT, BEGIN или DDL, прочитать SQL отдельно от параметров и посмотреть состояние после опыта.
Механизм обозначен прямо: мастерская воспроизводит запись настоящего выполнения Node.js. SQL и TypeScript в браузере не запускаются. Поиск фильтрует уже сохранённые строки. Чтобы изменить запрос или набор данных, скачайте проект, поправьте исходник и снова выполните capture. Восьмая задача показывает результат настоящего tsc, а не ошибку, нарисованную интерфейсом.
Полный JSON содержит SQL, значения, результаты, проверки и ожидаемый отказ, если он предусмотрен сценарием. Вы можете скачать его, открыть исходный файл и сопоставить наблюдение с реализацией. Указанная длительность относится к одному локальному запуску: сравнивать её с производительностью вашего VPS без собственных измерений не следует.
Схема TypeScript: Generated, null и реальная структура таблицы
Интерфейс DB перечисляет таблицы. Каждая таблица описывает столбцы и типы, которые ожидает приложение. Generated отмечает значение, обычно создаваемое базой: например, автоматический числовой ID. Nullable-поле записывается как объединение с null. Это позволяет TypeScript заметить попытку без проверки использовать отсутствующее примечание как строку.
Описание типов само по себе не создаёт таблицу и не проверяет существующую схему. Если объявить несуществующий столбец, компилятор может довериться вашему интерфейсу, а SQLite затем выдаст ошибку. Схему создают SQL и миграции; соответствие интерфейса фактической БД поддерживается отдельно. Генерация типов из схемы возможна другими инструментами, но здесь интерфейс намеренно небольшой и явный.
Также TypeScript не меняет значения, возвращаемые драйвером. Указание sum<number> не превращает строку в число. Это важная граница, подробно разобранная в документации типов Kysely. При смене драйвера особенно проверьте даты, bigint, decimal и nullable-результаты.
import type { Generated } from 'kysely';
interface Job {
  id: Generated<number>;
  title: string;
  amount_minor: number;
  client_id: number | null;
  note: string | null;
}
interface DB { jobs: Job }
// В архиве схема полнее: external_id, status, created_at и другие таблицы.
Опыт 1. SELECT нужных полей и отсутствующая запись
Для списка заявок не обязательно загружать всю строку. В первом варианте выбираются ID, заголовок, статус и сумма, затем задаются порядок и ограничение. Результат содержит первые три заявки. Явный набор полей делает контракт экрана понятнее и уменьшает зависимость интерфейса от будущих столбцов таблицы.
Во втором варианте ищем ID 999, которого нет. Результат — пустой массив. Это нормальный исход чтения, который обработчик должен превратить в подходящее поведение: пустой список, сообщение или ответ 404 для запроса конкретного объекта. Нельзя подставлять выдуманную карточку только ради удобства шаблона.
Порядок задаётся явно. Без ORDER BY приложение не должно обещать, что строки всегда придут одинаково. Для одиночного результата Kysely предоставляет executeTakeFirst и executeTakeFirstOrThrow; выбор зависит от того, является ли отсутствие обычным состоянием или нарушением контракта конкретной операции.
const rows = await db.selectFrom('jobs')
  .select(['id', 'title', 'status', 'amount_minor'])
  .orderBy('id')
  .limit(3)
  .execute();
Опыт 2. Фильтры, связанные параметры и проверка входа
Первый вариант выбирает новые заявки от 1000 рублей: в базе это 100000 копеек. Значение проходит нашу runtime-проверку, затем становится параметром WHERE. В SQL видны placeholders, а реальные значения находятся отдельно. Это удобно для диагностики: можно понять форму запроса, не смешивая её с содержимым каждого пользовательского ввода.
Во втором варианте строка с кавычкой и OR передаётся как имя клиента. Она остаётся буквальным значением параметра, не превращается в условие, расширяющее выборку. Результат пустой, таблицы сохранены. При этом имена столбцов, направление сортировки и другие части структуры нужно выбирать из разрешённого набора, а не склеивать из запроса пользователя.
Проверка TypeScript не заменяет проверку JSON, пришедшего по сети. Значение minimum может фактически оказаться строкой, NaN, дробью или отрицательным числом. В проекте validateMinimum проверяет целое безопасное число и диапазон. Для сложных структур полезен подход из статьи Ajv и JSON Schema.
const minimum = validateMinimum(input.minimum);
const rows = await db.selectFrom('jobs')
  .select(['id', 'title', 'amount_minor'])
  .where('status', '=', 'new')
  .where('amount_minor', '>=', minimum)
  .orderBy('id').execute();
Опыт 3. INNER JOIN и LEFT JOIN для карточки клиента
Заявку обычно удобнее показывать вместе с именем клиента. INNER JOIN возвращает только связанные строки: наша гостевая заявка без client_id исчезает, остаются пять. LEFT JOIN сохраняет все шесть заявок, а у гостевой имя клиента равно null. Это разные бизнес-представления, и выбор зависит от задачи экрана.
Используйте алиасы таблиц и выходных полей. В запросе j.id однозначно относится к заявке, c.name — к клиенту, а итоговое client удобно использовать в интерфейсе. Если выбрать два столбца id без явных имён, результат будет труднее читать и легче неправильно обработать.
Условие фильтрации также влияет на смысл. WHERE по правой таблице после LEFT JOIN может исключить строки без связи, если условие не допускает null. Поэтому проверяйте не только компиляцию, но и состав результата: есть ли гостевые обращения, что происходит с удалённым клиентом и не размножаются ли строки при связи один-ко-многим.
const rows = await db.selectFrom('jobs as j')
  .leftJoin('clients as c', 'c.id', 'j.client_id')
  .select(['j.id', 'j.title', 'c.name as client'])
  .orderBy('j.id').execute();
Опыт 4. Агрегаты для панели и клиент без заявок
В первой сводке GROUP BY собирает заявки по статусам, COUNT считает количество, SUM складывает суммы. Общий результат сверяется с исходными данными. Для небольшой панели это понятнее, чем загрузить все строки и незаметно посчитать разные показатели разными JavaScript-функциями.
Во втором варианте нужны все клиенты, включая нового клиента без заявок. Используем LEFT JOIN, считаем j.id и заменяем отсутствующую сумму через COALESCE. Если вместо j.id посчитать COUNT(*), строка самого клиента даст единицу даже при отсутствии заявок. Это логическая ошибка SQL, которую корректные типы не обязаны обнаруживать.
Денежные значения примера — целые копейки в допустимом диапазоне JavaScript number. Для больших сумм и иных правил округления требуется отдельная числовая модель. Не используйте красивый generic как доказательство финансовой точности. Сначала определите единицы хранения и реальные типы драйвера, затем форматируйте значение для человека.
const rows = await db.selectFrom('clients as c')
  .leftJoin('jobs as j', 'j.client_id', 'c.id')
  .select(eb => [
    'c.id', 'c.name',
    eb.fn.count<number>('j.id').as('count'),
    eb.fn.coalesce(eb.fn.sum<number>('j.amount_minor'), eb.val(0))
      .as('totalMinor')
  ])
  .groupBy(['c.id', 'c.name']).orderBy('c.id').execute();
Опыт 5. INSERT, RETURNING и повтор внешнего ID
Первый вариант добавляет новую заявку и возвращает её ID, внешний идентификатор и сумму. RETURNING помогает получить результат самой операции без отдельного поиска по косвенным признакам. В SQLite используемой версии этот вариант проверен настоящим выполнением.
Во втором варианте отправляем уже существующий J-001. Ограничение UNIQUE отклоняет вставку, число заявок остаётся прежним. TypeScript не мог заранее знать текущее содержимое базы, поэтому такая ошибка относится к runtime. Приложение должно различать ожидаемый конфликт и неожиданную инфраструктурную проблему, сохраняя понятный ответ пользователю.
Уникальный внешний ID полезен при повторной доставке событий, но сам по себе ещё не определяет всю идемпотентность. Нужно решить, считается ли повтор успешным получением прежнего результата, конфликтом данных или запросом обновления. В мастерской выбран явный отказ: он лучше показывает, что реально сделала база, без скрытого upsert.
const created = await db.insertInto('jobs')
  .values(newJob('J-007'))
  .returning(['id', 'external_id', 'amount_minor'])
  .executeTakeFirstOrThrow();
// newJob — учебный конструктор полей в src/scenarios.ts.
// Повтор external_id='J-001' даёт SQLITE_CONSTRAINT_UNIQUE.
Опыт 6. Транзакция: заявка и аудит сохраняются вместе
Представьте операцию, которая создаёт заявку и фиксирует событие аудита. Если второй шаг не выполнен, первый не должен выглядеть полностью успешным. В положительном варианте обе записи попадают в базу. В отрицательном исключение возникает после INSERT заявки, до записи аудита: rollback возвращает обе таблицы к исходному состоянию.
Запросы внутри callback должны использовать trx. Если случайно обратиться к другому соединению или выполнить внешнее действие, оно не становится частью этой транзакции автоматически. Отправка письма, HTTP-запрос и изменение файла имеют собственные правила согласования. Для них часто требуется очередь или outbox после успешного commit.
Не проглатывайте исключение внутри callback и не возвращайте обычный успех, если ожидаете откат. В проверенном опыте исключение выходит наружу, после чего Kysely инициирует rollback. Такой контракт описан в официальном примере транзакции. Мастерская показывает настоящие команды BEGIN, INSERT и COMMIT либо ROLLBACK.
await db.transaction().execute(async trx => {
  const job = await trx.insertInto('jobs').values(newJob('TX-001'))
    .returning('id').executeTakeFirstOrThrow();
  if (failBeforeAudit) throw new Error('Учебная ошибка до записи аудита');
  await trx.insertInto('audit').values({job_id: job.id, action: 'created'})
    .execute();
});
Опыт 7. Keyset-пагинация с одинаковыми датами
Первая страница выбирает две заявки по created_at, затем по id. Даты первых двух строк совпадают, поэтому только времени для курсора недостаточно. Курсор хранит оба значения. Следующая страница получает записи с большим временем либо с тем же временем и большим ID. В нашем наборе это заявки 3 и 4.
В другом варианте между чтениями добавляется запись с более ранним временем, перед уже пройденной границей. Она не сдвигает следующую страницу и не создаёт повтор прежних строк. Но сама новая запись не появится в уже просмотренной части: пользователь должен обновить начало списка, если хочет увидеть её.
Keyset не является снимком всего меняющегося набора. Изменение поля сортировки, удаление записей и выбранное направление обхода требуют продуманного поведения. Для запроса в схеме создан индекс created_at, id. Курсор из HTTP-запроса нужно отдельно проверить по структуре и допустимым значениям, даже если внутри программы он имеет красивый интерфейс TypeScript.
const rows = await db.selectFrom('jobs')
  .select(['id', 'title', 'created_at'])
  .where(eb => eb.or([
    eb('created_at', '>', cursor.created_at),
    eb.and([
      eb('created_at', '=', cursor.created_at),
      eb('id', '>', cursor.id)
    ])
  ]))
  .orderBy('created_at').orderBy('id').limit(2).execute();
Опыт 8. Три настоящие ошибки типов и исправление
Файл type-errors.ts содержит три ошибки: неизвестный столбец, строку вместо числового условия и присвоение nullable-поля обычной строке. При записи опыта запускается настоящий TypeScript CLI. Он возвращает ненулевой код выхода и три диагностики. Файл не исполняется, запросы из него не отправляются в SQLite.
В соседнем варианте открывается исправленный исходник: название столбца существует, сумма числовая, а null обработан явно. Компилятор завершается без ошибок. Сравните оба файла в просмотрщике исходников, чтобы увидеть пользу проверки до запуска, а не только прочитать формулировку на странице.
Отсутствие ошибок компиляции означает соответствие описанному контракту типов. Оно не подтверждает правильность прав доступа, актуальность схемы, уникальность значений и успешное выполнение запроса. Поэтому в этой же лаборатории существуют отдельные runtime-тесты UNIQUE, CHECK, foreign key и проверки входного значения.
// Было: note имеет тип string | null.
const note: string = row.note;

// Стало: выбран явный текст для отсутствующего примечания.
const note: string = row.note ?? 'Нет примечания';
// Две строки показывают альтернативы; это не один готовый файл.
Опыт 9. Миграции, повторный запуск и DOWN
Первая миграция создаёт таблицу labels и учебную строку. Вторая добавляет color со значением по умолчанию. В варианте UP и повторный UP оба изменения применяются один раз, затем повторный migrateToLatest возвращает пустой набор действий. История базы позволяет отличить выполненные миграции от новых.
Другой вариант вызывает migrateDown и убирает только последний столбец. Строка с названием остаётся, но данные удалённого color больше не существуют. Это наглядная граница: наличие функции down не гарантирует безопасный откат релиза. Сначала нужны резервная копия, проверка восстановления и решение о совместимости приложения со схемой.
В Kysely 0.29 мигратор импортируется из kysely/migration. Исторические миграции не должны зависеть от сегодняшнего интерфейса DB, который изменится завтра. Они описывают собственный этап схемы. Проверяйте поле error в результате выполнения; нельзя объявлять выпуск успешным только потому, что вызов вернул объект. Подробнее — руководство миграций.
import { Migrator } from 'kysely/migration';
const migrator = new Migrator({ db, provider });
const result = await migrator.migrateToLatest();
if (result.error) throw result.error;
console.log(result.results);
SQL-фрагменты, логирование и проверка запроса
Иногда построителя недостаточно для конкретного выражения СУБД. Kysely предоставляет sql template tag: параметры внутри такого шаблона связываются как значения, а не требуют ручного экранирования строк. Используйте этот механизм осознанно, сохраняя различие между доверенной структурой запроса и внешними данными.
В лаборатории log фиксирует SQL, параметры, длительность и ошибку каждой операции. Это допустимо благодаря полностью вымышленным данным. В рабочем сервисе полный набор параметров может содержать персональную информацию, текст обращения или секрет. Для обычного наблюдения часто достаточно формы запроса, длительности, безопасного ID операции и классификации ошибки.
Сложный запрос полезно сначала скомпилировать и прочитать, затем выполнить на проверяемых данных. Наличие типизации не отменяет план запроса, индексы и предел объёма результата. Официальная страница Raw SQL объясняет использование sql-фрагментов. Для миграций PHP можно дополнительно посмотреть материал про Phinx.
import { sql } from 'kysely';
const title = 'Учебное название';
await sql`insert into labels (id,name) values (1,${title})`.execute(db);
// Значение title передаётся отдельно как параметр.
// Не заменяйте шаблон склеиванием непроверенных SQL-строк.
Windows: первый запуск и изменение своего примера
Установите подходящий Node.js LTS, распакуйте архив и откройте PowerShell в каталоге проекта. npm ci восстанавливает lock-файл, test собирает TypeScript и запускает проверки настоящей SQLite. Capture выполняет восемнадцать вариантов и сохраняет новую запись. Build подготавливает статические ресурсы и просмотрщик исходников.
После serve откройте http://127.0.0.1:8532/. Завершите сервер через Ctrl+C в его терминале. Если порт занят, настройте свой preview-порт; чужие процессы не являются частью лаборатории. Готовую public можно также раздать встроенным HTTP-сервером установленного PHP, хотя PHP для Kysely не требуется.
Не открывайте мастерскую через file://: интерфейс получает JSON обычным fetch. Для изменения поведения начинайте с seed и нужного сценария. Затем осознанно обновляйте ожидаемый результат теста. Простая замена ожидаемого значения ради зелёной проверки не объясняет, почему изменившийся SQL теперь соответствует вашей задаче.
node --version
npm ci --ignore-scripts
npm test
npm run capture
npm run build
npm run serve
# Остановка: Ctrl+C.
Linux: та же реализация и самостоятельная запись
В Linux используются те же исходники и команды. Установите Node.js для нужной архитектуры из официального источника и работайте от обычного пользователя. Не переносите node_modules из Windows: native-драйвер и TypeScript используют платформенные компоненты. npm ci устанавливает набор для текущей среды.
Capture определяет реальную ОС. Linux пишет recording-linux.json, Windows — recording.json. В архиве сохранены обе записи. Если после правки хотите показать собственный Linux-запуск в мастерской, явно скопируйте его в основной recording.json и пересоберите public. Так читатель видит выбранный фактический запуск, а не перепутанные результаты разных версий.
Команда verify сравнивает хеши реализации в обеих записях с текущими файлами. После изменения кода прежняя запись перестаёт подтверждать новую реализацию. Для полного повторения понадобятся оба запуска; для разработки одной платформы достаточно честно обозначать, какая запись соответствует текущему исходнику.
npm ci --ignore-scripts
npm test
npm run capture
# Чтобы public показывала именно новый Linux-запуск:
cp public/recording-linux.json public/recording.json
npm run build
npm run serve
Linux/VPS: где хранить файл базы и как подключать приложение
Публичная мастерская является статикой. Её можно разместить за Nginx или Caddy без постоянно работающего Node-процесса. Инструкции находятся в архиве; особенности сервера разобраны отдельно в статьях про Nginx и Caddy с HTTPS. Публикуйте содержимое public, не весь рабочий каталог.
Для собственного приложения SQLite-файл хранится вне web-root, в каталоге сервисного пользователя. Путь задаётся конфигурацией, а не URL посетителя. Режим fileMustExist помогает не получить неожиданную пустую базу из-за опечатки. Новая база и её миграции создаются отдельным этапом развёртывания, с понятным результатом проверки.
Ниже пример адаптации подключения. Лаборатория продолжает использовать только память; внешний VPS и его filesystem этим опытом не проверены. В systemd-службе рабочего приложения задайте явные User, WorkingDirectory, путь Node и разрешённый каталог данных. Локальный serve из архива предназначен для просмотра, а не является готовым production API.
import Database from 'better-sqlite3';
import { Kysely, SqliteDialect } from 'kysely';
const sqlite = new Database('/var/lib/my-service/service.sqlite', {
  fileMustExist: true, timeout: 5000
});
sqlite.pragma('foreign_keys = ON');
const db = new Kysely<DB>({
  dialect: new SqliteDialect({ database: sqlite })
});
// При завершении приложения: await db.destroy().
WAL, резервные копии и реальные ограничения SQLite
WAL может улучшить взаимодействие чтения и записи файловой базы, но не превращает SQLite в систему с неограниченным количеством одновременных writers. Он имеет собственные условия и вспомогательные файлы. Не переносите такую базу на произвольный сетевой filesystem в надежде получить общий сервер данных. Эти особенности описаны в документации SQLite WAL.
Резервное копирование также требует согласованного механизма. Простое копирование одного файла при активной записи может не соответствовать ожидаемому снимку. У better-sqlite3 есть API backup; его применение и восстановление следует проверить на вашем приложении. В архиве приведён пример, но он не объявляется проверенной системой резервирования вашего VPS.
Полезное продолжение внутри сайта — главы PHP-мануала локальный каталог и доступ к SQLite и резерв товара, снимок читателя и план выборки. Примеры написаны на PHP, но вопросы файла базы, согласованности и индексов важны и для Node.js.
Что проверено и что меняется при другой СУБД
На Windows Node 24.19.0 и Linux Node 24.22.2 прошли по двадцать тестов. При каждой записи выполнены восемнадцать вариантов и тридцать девять проверок результатов. Подтверждены строки SELECT, параметры, JOIN, суммы, UNIQUE, commit/rollback, курсор, реальная TypeScript-диагностика и миграции. Отдельные тесты проверяют runtime-вход, CHECK и foreign key.
Хеши исходников совпадают между платформами. Семантические результаты, SQL и параметры также совпали, кроме естественных временных меток истории миграций и длительностей конкретного запуска. Linux выполнялся в отдельном локальном контейнере с заново установленными зависимостями, а не через переименование Windows-результата.
При переходе на PostgreSQL или MySQL нужны соответствующий dialect, драйвер и повторные интеграционные проверки. SQLite-тест не доказывает одинаковое поведение RETURNING, блокировок, дат и числовых типов в другой базе. Синхронный better-sqlite3 также занимает поток Node: длинные операции требуют ограничения объёма, индексов и отдельной оценки worker либо очереди.
npm test
npm run capture
npm run verify
# verify требует актуальные записи обеих платформ.
npm run build
Скачать исходники и внедрить один полезный запрос
Архив содержит TypeScript-реализацию, схему и данные, миграции, оба варианта файла с ошибками типов, тесты, реальные записи и статическую мастерскую. Авторский код доступен по MIT; зависимости и их лицензии перечислены отдельно. Node_modules восстанавливается через npm ci, поэтому архив не привязан к установленным файлам конкретной машины.
Начните с одной операции своего приложения: списка заявок, карточки или отчёта. Опишите поля, входные ограничения, допустимый результат при отсутствии записи и ожидаемые ошибки. Посмотрите SQL и параметры, выполните запрос на проверяемом наборе, затем подключите его к серверному обработчику с нужными правами доступа.
Следующим шагом добавьте отрицательный случай: чужой ID, неверное поле, повтор уникального значения или исключение между двумя записями. Польза Kysely становится понятной именно в сочетании: TypeScript ловит часть ошибок раньше, SQL остаётся видимым, а реальные тесты подтверждают поведение базы.