Symfony String: Unicode и строки PHP — мастерская и 9 задач
Девять практических задач со строками PHP: длина Unicode, emoji, пробелы, нормализация NFC, выдержки, slug и сравнение. Мини-мастерская с 28 реальными опытами Windows/Linux, CLI, API и исходниками.
Symfony String: текст, который не ломается на кириллице и emoji
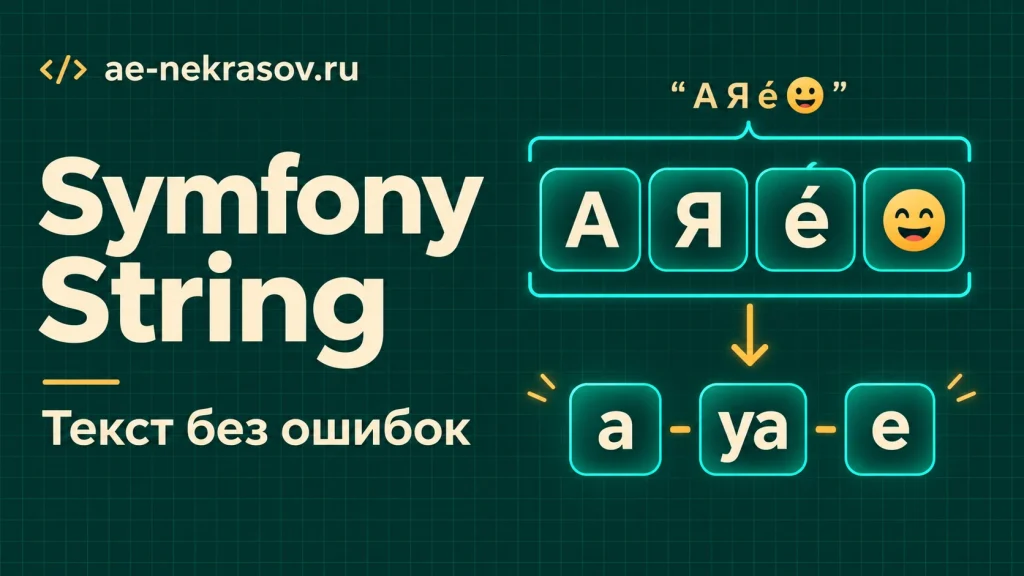
В форме написано «не больше двадцати символов», но сервер считает русский текст в байтах. В карточке обрезается половина emoji, а два одинаково выглядящих имени не совпадают при сравнении. Такие ошибки возникают, когда программа не определила, какую единицу и какое преобразование использует.
Symfony String даёт объектный интерфейс для работы со строками: длина, фрагменты, пробелы, регистр, нормализация и адреса из заголовков. Компонент устанавливается через Composer и работает без полного Symfony-фреймворка. Его можно добавить в существующий PHP-проект, импорт данных, CRM, генератор документов или административную панель.
Разберём девять практических задач с двадцатью восемью вариантами входных данных. Мастерская показывает реальные результаты PHP на Windows и Linux, а отдельная браузерная панель позволяет исследовать собственную строку через JavaScript. Полный исполняемый PHP-проект, CLI, ограниченный HTTP API, тесты и инструкции для Linux/VPS находятся в исходниках.
Где применять: формы, импорт, карточки и названия файлов
Для карточек услуг полезно сокращать описание так, чтобы последний видимый символ оставался целым. В импорте из таблицы нужно убрать случайные табуляции и переносы, сохранив исходную подпись для отчёта. Для публикации нужен человекочитаемый slug, а для списка документов — удобное название, отделённое от фактического пути хранения.
В CRM часто требуется сравнить значение без учёта регистра или показать короткую маску вместо полного имени. В этих случаях строковая библиотека уменьшает количество ручных комбинаций функций. Однако сначала нужно определить правило продукта: «одинаковая строка», «подходит для поиска» и «тот же человек» означают разные вещи. Один универсальный lower не решает все три задачи.
Начните с конкретного поля и наблюдаемой ошибки. Например, пользователь вставил имя из документа с неразрывным пробелом. Сохраните пример, посмотрите байты и графемы, определите допустимое преобразование и добавьте тест. Тогда обработка будет объяснимой, а случайный список replace не превратится в скрытую политику изменения данных.
Байты, кодовые точки и графемы: три разные длины
Байт — единица хранения. Кодовая точка — элемент Unicode, например буква или комбинирующий знак. Графема — единица сегментации текста, которая часто соответствует воспринимаемому пользователем символу и может состоять из нескольких кодовых точек. Вопрос «сколько символов» без названия единицы недостаточно точен для программного контракта.
В нашем реальном опыте слово «Привет» занимает 12 байт UTF-8, содержит 6 кодовых точек и 6 графем. Семейный emoji 👨👩👧👦 занимает 25 байт, состоит из 7 кодовых точек и считается одной графемой. Флаг 🇷🇺 имеет 8 байт, 2 кодовые точки и одну графему. Разница важна, когда нужно взять первый видимый элемент.
Графема не гарантирует одинаковую ширину на экране: шрифт, платформа и размер влияют на отображение. Для ограничения файла нужны байты; для пользовательского счётчика часто подходят графемы; для точного описания Unicode-последовательности нужны кодовые точки. Выберите единицу до написания условия.
| Строка | Байты UTF-8 | Кодовые точки | Графемы |
|---|---|---|---|
| Привет | 12 | 6 | 6 |
| 👨👩👧👦 | 25 | 7 | 1 |
| 🇷🇺 | 8 | 2 | 1 |
Мини-мастерская: девять опытов настоящего PHP
Выберите задачу, платформу и подготовленный вариант, затем нажмите «Показать результат». Рядом находятся входные данные, значение либо ожидаемая ошибка, версия PHP и время фактического запуска. Можно сравнить результаты Windows и Linux, скачать запись JSON и открыть точный исходник операции. Это связывает объяснение с конкретным входом, а не только с названием метода.
Публичная часть показывает сохранённые результаты настоящего PHP. Она не выполняет новый код на хостинге и не выдаёт JavaScript-имитацию за Symfony. Для своих PHP-строк скачайте проект и запустите CLI или API. Ниже основного просмотрщика есть отдельная панель собственного текста: она использует TextEncoder и Intl.Segmenter браузера и явно подписывает этот механизм.
Попробуйте семейный emoji, комбинированную букву, неразрывный пробел и строку из одних знаков. Затем посмотрите отказ для имени файла с ../. Эти границы полезнее одного безошибочного примера. На телефоне элементы управления располагаются в колонку, а код и JSON прокручиваются внутри собственных блоков.
Composer, PHP 8.3 и расширения intl/mbstring
Проект использует Symfony String 7.4.22 из ветки 7.4 и PHP не ниже 8.3. Точные версии находятся в composer.lock. Для стенда явно требуются intl и mbstring, чтобы поведение можно было проверять в выбранном окружении. Автоматическая загрузка классов подключается через vendor/autoload.php; устанавливать весь Symfony не нужно.
Команда composer install читает lock-файл и повторяет согласованную установку. require удобна при первом добавлении пакета в своё приложение, но не заменяет install для подготовленного проекта. Версию выбирайте с учётом PHP сервера и остальных зависимостей. Основные команды, lock и диагностика разобраны в руководстве Composer на этом сайте.
После установки выполните check-platform-reqs. Не скрывайте отсутствие расширения игнорированием требований. На рабочем сервере PHP CLI и PHP-FPM могут иметь разные ini и наборы модулей: успех команды в терминале не подтверждает наличие intl у web-процесса. Это особенно важно при нескольких версиях PHP на машине.
Фрагмент composer.json
{
  "name": "aen/symfony-string-workshop",
  "description": "Executable Unicode string workshop",
  "type": "project",
  "license": "MIT",
  "require": {
    "php": ">=8.3",
    "ext-intl": "*",
    "ext-mbstring": "*",
    "symfony/string": "7.4.*",
    "symfony/translation-contracts": "^3.6"
  },
  "autoload": {
    "psr-4": {
      "Aen\\StringLab\\": "src/"
    }
  }
}
composer require "symfony/string:7.4.*" symfony/translation-contracts
composer check-platform-reqsWindows: запуск CLI и проверка своей строки
Распакуйте исходники, откройте PowerShell и убедитесь, что PHP и Composer доступны в PATH. Команда php –ini показывает конфигурацию, а php -m — загруженные расширения. Для Windows важно, чтобы DLL соответствовала архитектуре и сборке PHP. Подключение случайного файла из другой версии часто приводит к ошибке до запуска проекта.
Готовый fixtures/request.json содержит описание с emoji и лимит выдержки. CLI прочитает его, вызовет StringLab и выведет JSON. Для своего опыта измените файл, сохраняя UTF-8. Так удобнее передавать кириллицу и кавычки, чем собирать сложную JSON-строку с экранированием в командной строке.
Результат идёт в stdout, ошибки — в stderr с ненулевым кодом. Это позволяет подключить команду к импорту или CI. Не считайте пустой файл результата успехом: проверяйте код завершения. В старом Windows PowerShell учитывайте кодировку перенаправления; она не должна незаметно превращать UTF-8 JSON в UTF-16 или системную кодовую страницу.
Фрагмент README.md
Set-Location .\symfony-string-project
php --version
php --ini
php -m
composer install --no-interaction --no-plugins --no-scripts --prefer-dist
composer check-platform-reqs
php tests/run.php
php bin/string.php fixtures/request.json
Linux: команды проекта и воспроизводимая среда
На Linux нужны совместимый PHP, intl, mbstring и Composer. Названия пакетов и доступная версия зависят от дистрибутива и репозиториев. Для установленной ветки PHP 8.3 пакеты часто называются php8.3-intl и php8.3-mbstring, но сначала проверьте свой менеджер пакетов. Не меняйте системный PHP ради одного опыта без оценки других сайтов.
После установки выполняются те же тесты и CLI, что в Windows. Реальные проверки прошли на PHP 8.3.33 в Windows и PHP 8.3.36 в Linux-контейнере, с ICU 72.1 в обеих средах. Двадцать восемь вариантов дали одинаковые смысловые результаты. Версии указаны явно, чтобы будущие отличия после обновления ICU исследовать предметно.
В проекте есть Dockerfile для отдельной Linux-среды. Он полезен, если не хочется добавлять расширения в системный PHP ради знакомства. Это не заменяет проверку конфигурации настоящего PHP-FPM при внедрении: контейнерный CLI и рабочий web-процесс остаются разными средами исполнения.
Фрагмент README.md
cd symfony-string-project
php --version
php -m
composer install --no-interaction --no-plugins --no-scripts --prefer-dist
composer check-platform-reqs
php tests/run.php
php bin/string.php fixtures/request.json
UnicodeString, CodePointString и обычные функции PHP
В проекте исходный текст сохраняется отдельно от объекта UnicodeString. Это позволяет сравнивать размеры входа и результат преобразования. strlen измеряет байты исходной строки; CodePointString считает кодовые точки; UnicodeString работает с графемами. Короткая функция u создаёт UnicodeString и делает цепочки операций компактнее.
Обычные функции PHP никуда не исчезают. strlen полезна для лимита тела или файла, mb_strlen — для работы с заданной кодировкой, а grapheme_strlen — для подсчёта графем. Выбор зависит от задачи, а не от желания заменить все функции библиотекой.
Преобразования объектов возвращают результат, с которым можно продолжить цепочку. Сохраняйте исходную переменную, если изменение должно быть обратимым или попадать в отчёт импорта. Для общего знакомства с синтаксисом, массивами, исключениями и классами можно обратиться к большому PHP-мануалу на сайте.
use Symfony\Component\String\CodePointString;
use function Symfony\Component\String\u;
$text = 'Привет';
$metrics = [
    'bytes' => strlen($text),
    'codePoints' => (new CodePointString($text))->length(),
    'graphemes' => u($text)->length(),
]; // 12, 6, 6
Пример 1. Первый видимый элемент и составной emoji
Обычный substr с длиной один берёт один байт. Для русской буквы или emoji этого недостаточно. В мастерской первый байт показан как hexadecimal, чтобы не пытаться вывести повреждённую UTF-8-последовательность в HTML. У семейного emoji такой фрагмент начинается с f0 и не представляет целый символ.
UnicodeString::slice(0, 1) в проверенном опыте возвращает весь семейный emoji. Это полезно для аватарки с первым элементом имени, короткой подписи или аккуратной нарезки текста. Однако первое воспринимаемое человеком «имя» не всегда равняется первой графеме: пробелы, титулы и составные имена требуют отдельного правила продукта.
Вариант с буквой e и комбинирующим акцентом показывает тонкость: исходный UTF-8 имеет три байта и две кодовые точки, а UnicodeString при создании нормализует представление к NFC. Первая графема выводится как é. Нельзя выдавать байтовые характеристики исхода и нормализованного результата за одну и ту же строку.
$text = '👨👩👧👦';
$first = u($text)->slice(0, 1)->toString();
$firstByteHex = bin2hex(substr($text, 0, 1));
// $first — целая графема; $firstByteHex — "f0".Пример 2. Пробелы из импорта и особый случай NBSP
После копирования из таблиц в имени могут оказаться табуляции, переводы строк и несколько обычных пробелов. Цепочка collapseWhitespace()->trim() делает подпись удобнее для отображения. В нашем опыте строка с лишними разделителями превращается в «Иван Петров», а строка из обычных пробельных символов становится пустой.
Неразрывный пробел U+00A0 — отдельный случай. В проверенной Symfony String 7.4.22 collapseWhitespace не превращает его в обычный пробел. Пример «Цена», NBSP, два обычных пробела и «товара» сохраняет NBSP, а обычную последовательность сокращает. Обещание «удаляет любые странные пробелы» было бы неверным.
Если продукту нужно заменить NBSP, задайте это явным правилом и добавьте тест. Для денежных сумм или типографики неразрывный пробел может быть полезен, поэтому бездумная замена всех разделителей не всегда правильна. Сохраняйте исходное значение и преобразованную подпись раздельно, особенно при массовом импорте из чужой системы.
$original = "  Иван\t  Петров\n";
$cleaned = u($original)->collapseWhitespace()->trim()->toString();
// Дополнительная политика, только если она нужна продукту:
$ordinarySpaces = u($original)->replace("\u{00A0}", ' ')
    ->collapseWhitespace()->trim()->toString();
Пример 3. NFC: одинаковый вид не означает одинаковые байты
Букву é можно представить одной кодовой точкой или последовательностью e и комбинирующего акцента. Внешне строки часто выглядят одинаково, но строгое сравнение исходных байтов даёт false. В нашем опыте NFC приводит записи к канонически эквивалентной форме: сравнение успешно, а размер первой строки меняется с трёх байт на два.
Похожий пример есть для кириллической й. Но латинская A и кириллическая А после NFC остаются разными: нормализация не исправляет смешение алфавитов и не определяет, что автор «имел в виду». Визуальное сходство само по себе не основание объединять аккаунты или записи.
Выбирайте нормализацию на определённой границе приложения и документируйте её. Если данные подписаны или их исходные байты участвуют в хеше, преобразование после вычисления подписи меняет проверяемое содержимое. Для текстового поля политика может быть полезной, но применять её ко всем байтовым значениям нельзя. Нативный механизм описан в Normalizer::normalize.
use Symfony\Component\String\UnicodeString;
$raw = "e\u{0301}";
$other = 'é';
$rawEqual = $raw === $other; // false
$normalizedEqual = u($raw)->normalize(UnicodeString::NFC)
    ->equalsTo(u($other)->normalize(UnicodeString::NFC)); // true
Пример 4. Выдержка для карточки: строгий лимит и целое слово
Карточке не всегда нужен полный текст. Обычный truncate с суффиксом «…» ограничивает результат в графемах, включая суффикс. Для «Доставка оборудования сегодня» и лимита 16 наш опыт получает «Доставка оборуд…». Если строка короткая, как «Готово» при лимите 10, она остаётся без многоточия.
Третий параметр false меняет поведение на границе слова. Результат «Доставка оборудования…» длиннее шестнадцати графем: библиотека заканчивает слово, а не гарантирует строгий максимум. Это удобно для читабельной выдержки, но не подходит как доказательство соблюдения жёсткого ограничения внешнего API или поля базы.
Выбирайте режим по задаче. Для фиксированного контракта нужен строгий предел; для карточки иногда важнее целое слово. Визуальное ограничение по двум строкам CSS — отдельная задача, зависящая от ширины контейнера. Ни число графем, ни окончание слова не гарантируют одинаковое количество строк на телефоне и десктопе.
$text = u('Доставка оборудования сегодня');
$strict = $text->truncate(16, '…')->toString();
$wholeWord = $text->truncate(16, '…', false)->toString();
// Доставка оборуд…
// Доставка оборудования…
Сокращение текста: храните полный источник и проверяйте интерфейс
Вариант с «Семья 👨👩👧👦 и поездка на выходные» показывает, что составной emoji сохраняется целиком. Это полезно в уведомлениях, ленте событий и мобильных карточках. Но отправлять сокращённую строку обратно в основное поле базы не нужно: выдержка является отдельным представлением полного содержимого.
Храните исходный текст, а короткую версию вычисляйте при выдаче либо сохраняйте как производное поле с понятным правилом обновления. При изменении лимита или алгоритма вы сможете пересобрать представление. Если оставить только обрезанный текст, восстановить потерянное окончание библиотека уже не поможет.
Для интерфейса полезно добавить ссылку «Подробнее» или раскрытие полного текста. Тестируйте реальную ширину карточки на телефоне, увеличение шрифта и длинные слова. Серверная обработка отвечает за корректную строку; расположение блока, переносы и доступ к полной информации остаются задачами дизайна и HTML/CSS.
$original = 'Семья 👨👩👧👦 и поездка на выходные';
$view = [
'full' => $original,
'summary' => u($original)->truncate(12, '…')->toString(),
];Пример 5. Slug из русского заголовка
Slug — читаемый фрагмент адреса или ключ для отображения. AsciiSlugger транслитерирует строку, а lower приводит результат к нижнему регистру. В мастерской явно указан русский язык: «Новый отчёт за ноябрь» становится novyi-otchet-za-noyabr. Локаль — часть правила, поэтому её лучше задавать, а не получать случайно из окружения.
Второй вариант демонстрирует латиницу с диакритикой: Café déjà vu превращается в cafe-deja-vu. Третий важнее для надёжности: строка *** даёт пустой slug. Перед сохранением нужно решить, отклонить ли такое название или сформировать запасное значение с отдельным идентификатором.
Не используйте slug как подтверждение существования записи или права доступа. Его можно угадать и изменить. При переименовании опубликованной страницы заранее определите политику адресов: оставить старый slug, изменить его с перенаправлением или хранить историю. Библиотека преобразует текст, но маршрутизация и жизненный цикл URL принадлежат вашему приложению.
use Symfony\Component\String\Slugger\AsciiSlugger;
$slugger = new AsciiSlugger('ru');
$slug = $slugger->slug('Новый отчёт за ноябрь', '-')->lower()->toString();
if ($slug === '') {
    throw new InvalidArgumentException('Укажите содержательный заголовок.');
}
// novyi-otchet-za-noyabr
Уникальность slug: почему нужен отдельный ID
Два разных заголовка могут дать одинаковый slug. Даже полностью одинаковые названия иногда допустимы: две заявки «Замена оборудования» относятся к разным клиентам. Поэтому уникальность нельзя доказать одной транслитерацией. В базе нужен отдельный идентификатор, а для уникального адреса — ограничение и обработка конфликта.
Практичный вариант — стабильный ID в маршруте и читаемый slug рядом. Другой вариант — уникальный slug с суффиксом, который приложение выбирает при сохранении. Проверка «сначала SELECT, затем INSERT» без ограничения базы не исключает гонку двух одновременных запросов. Финальную защиту даёт уникальный индекс и обработка отказа.
Для UUID и ULID есть отдельная мастерская Symfony Uid. String помогает с человеческой подписью, Uid — с идентификатором. Это разные свойства записи; разделение упрощает переименования, импорт и ссылки из других систем.
// ID уже сформирован приложением и хранится отдельно.
$path = '/articles/'.rawurlencode($articleId).'/'.rawurlencode($slug);
// Запись находят по ID; slug остаётся читаемой частью адреса.
Пример 6. Регистр: ignoreCase и folded дают разные результаты
Для пары «МОСКВА» и «москва» строгое сравнение в опыте возвращает false, а сравнение без учёта регистра — true. Это ожидаемый сценарий для простого фильтра. Но международный текст показывает, почему нельзя считать все способы приведения регистра взаимозаменяемыми.
Пара Straße и STRASSE в проверенной Symfony String 7.4.22 не совпадает через ignoreCase()->equalsTo(). После folded() с обеих сторон результат совпадает: обе строки дают strasse. В мастерской показаны сами преобразованные значения, чтобы отличие было видно, а не скрывалось за единственным true.
Выберите правило под конкретное поле и сохраните тесты на реальные языки. Для поиска можно хранить отдельное нормализованное представление, а для отображения — исходную подпись. Не переносите это правило автоматически на пароли, токены и другие значения, где изменение регистра меняет смысл. Документация методов находится в руководстве компонента String.
$left = u('Straße');
$right = u('STRASSE');
$simple = $left->ignoreCase()->equalsTo($right); // false в 7.4.22
$folded = $left->folded()->equalsTo($right->folded()); // true
$searchKey = $left->folded()->toString(); // strasse
Поиск, сортировка и похожие буквы — отдельные правила
Case folding помогает сопоставить некоторые варианты регистра, но не превращает библиотеку в поисковый движок. Опечатки, морфология, ранжирование, префиксы и поиск по нескольким полям требуют дополнительных механизмов. Даже после нормализации латинская A и кириллическая А остаются разными символами.
Для небольшого списка можно подготовить ключ поиска и явно определить сравнение. Для большого каталога полезны индекс и выбранная collation базы либо специализированный поиск. В отдельной мастерской Meilisearch разобраны фильтры и поиск по документам. Не обещайте пользователю одинаковое поведение этих инструментов.
Сортировка для языка тоже не сводится к побайтовому сравнению. Если важен алфавитный порядок имён, изучите Collator из intl и проверьте локаль. На уровне требований разделите «найти похожее», «считать равным» и «отсортировать для чтения»: один подготовленный lower-ключ редко подходит для всех трёх случаев.
Пример 7. Буквальная замена и границы слова
В примере replace меняет фрагмент «кот» на «пёс». При обычном сравнении строка «Кот и кот» превращается в «Кот и пёс»: регистр первого слова отличается. Через ignoreCase заменяются оба вхождения. Это удобно для фиксированных маркеров в текстовой заготовке.
Но replace работает с подстрокой, а не с лингвистическим словом. Поэтому «котёнок» превращается в «пёсёнок». Мастерская специально показывает этот результат. Если задача — заменить только самостоятельное слово, потребуется другое явное правило границ, которое нужно проверить для выбранных языков и знаков препинания.
Не собирайте из случайных замен полноценный шаблонизатор писем. Для повторяющейся разметки, условий и вложенных данных лучше использовать предназначенный для этого инструмент. А для буквального маркера выберите достаточно отличимый формат, например {{client_name}}, и отдельно экранируйте значение в контексте итогового HTML.
$text = u('Кот и кот');
$sensitive = $text->replace('кот', 'пёс')->toString(); // Кот и пёс
$insensitive = $text->ignoreCase()->replace('кот', 'пёс')->toString();
$substring = u('котёнок')->replace('кот', 'пёс')->toString(); // пёсёнок
Пример 8. Маска подписи: скрыть середину в интерфейсе
Маска нужна, когда оператору достаточно узнаваемой подсказки, а полную подпись не требуется постоянно показывать. В проекте строка до двух графем полностью заменяется точками. Для более длинной сохраняются первый и последний элементы, а середина скрывается. Число точек ограничено двенадцатью, чтобы длинный ввод не растягивал карточку.
Для имени «Александр» результат — «А•••••••р». Составной emoji 👩💻 считается одной графемой и превращается в одну точку. Пустая строка остаётся пустой. Это небольшие, но полезные проверки: алгоритм не должен случайно раскрывать всю короткую подпись или резать emoji на байты.
Маска не является анонимизацией, шифрованием или контролем доступа. Если полное значение уже отправлено в HTML либо JSON браузера, скрытие части на экране не убирает его из ответа. Решайте на сервере, какие данные имеет право получить конкретный пользователь; визуальная маска дополняет это решение, но не заменяет его.
$value = u($text);
$length = $value->length();
$masked = $length <= 2
    ? str_repeat('•', $length)
    : $value->slice(0, 1)->toString()
        .str_repeat('•', min(12, $length - 2))
        .$value->slice(-1)->toString();
Пример 9. Подпись файла и реальный путь хранения
Загруженному документу полезно дать удобное название, но пользовательская подпись не должна становиться произвольным путём. В нашем сценарии слеши и управляющие символы запрещены. Вариант ../secret завершается ожидаемой ошибкой, а не попыткой открыть файл. Операция вообще не читает и не записывает файловую систему.
После очистки пробелов формируется основа имени из slug и ограничивается пятьюдесятью графемами. Строка из одних знаков получает основу document. В записи отдельно остаётся исходная человекочитаемая подпись: пользователю не обязательно показывать техническое имя объекта в хранилище.
Для настоящей загрузки сервер сам выбирает идентификатор, каталог и расширение после проверки содержимого. Один slug не подтверждает MIME, не проверяет вредоносное содержимое и не устраняет коллизии. При скачивании также корректно формируйте Content-Disposition. String решает только текстовую часть этой цепочки; остальные решения должны быть явными.
$label = u($text)->collapseWhitespace()->trim()->toString();
$baseName = (new AsciiSlugger('ru'))->slug($label)->lower()
    ->truncate(50, '')->toString();
if ($baseName === '') {
    $baseName = 'document';
}
// Это подпись. Каталог, реальный ID и проверенное расширение
// определяет серверный обработчик загрузки.
Контракт входных данных и понятные ошибки
Мастерская не принимает произвольное имя PHP-метода. StringLab разрешает девять известных операций, четыре поля и ограниченные типы. text и other должны быть корректными UTF-8-строками до 4096 байт; limit — целым числом от 2 до 120. Неизвестные поля тоже отклоняются, чтобы опечатка не исчезала незаметно.
Лимит байтов проверяется до дальнейших преобразований. Это отдельное ограничение ресурсов, а не обещание пользователю определённого количества графем. После него можно применить содержательное правило длины поля. Не преобразуйте массив или объект в строку автоматически: так ошибка вызывающей стороны маскируется неожиданным результатом.
В полном приложении полезно отделить структурную проверку от бизнес-правил: допустимый размер тела, правильный JSON, известная операция и затем правила конкретного поля. Для форм, DTO и JSON на сайте есть материал Symfony Validator. String выполняет преобразования, а Validator помогает описать допустимость данных.
if (!is_string($text) || !mb_check_encoding($text, 'UTF-8')) {
    throw new InvalidArgumentException('Ожидается строка UTF-8.');
}
if (strlen($text) > 4096) {
    throw new InvalidArgumentException('Строка слишком большая.');
}
if (!is_int($limit) || $limit < 2 || $limit > 120) {
    throw new InvalidArgumentException('limit должен быть целым от 2 до 120.');
}
Локальный HTTP API: POST, JSON и диагностируемый ответ
Для интеграции с интерфейсом в архиве есть небольшой PHP endpoint. Он принимает POST с application/json, ограничивает тело десятью тысячами байт и передаёт данные в то же ядро, которое использует CLI. Сервер слушает 127.0.0.1:8595, поэтому пример предназначен для локального запуска.
Корректный запрос получает 200. Неверный метод возвращает 405 с Allow: POST, неправильный MIME — 415, слишком большое тело — 413, ошибка JSON или контракта — 422. Неожиданная внутренняя ошибка не раскрывает стек и пути пользователю. Такие ответы удобнее обрабатывать в форме, чем одинаковый 200 с непредсказуемым текстом.
Запустите сервер в отдельном терминале, затем передайте готовый файл fixtures/request.json. В Windows указано curl.exe: это исключает путаницу со старым PowerShell alias. Встроенный php -S нужен для разработки. Для публичного сервиса используйте PHP-FPM, HTTPS и авторизацию вашего приложения; в статической мастерской статьи этот endpoint не публикуется.
Фрагмент README.md
php -S 127.0.0.1:8595 -t apicurl.exe -i -X POST http://127.0.0.1:8595/ -H "Content-Type: application/json" --data-binary "@fixtures/request.json"curl -i -X POST http://127.0.0.1:8595/ -H 'Content-Type: application/json' --data-binary @fixtures/request.jsonПрактика импорта: исходное значение, результат и отчёт об отказах
При импорте CSV легко потерять объяснимость: все строки очищены, но непонятно, почему значение изменилось. Сохраняйте исходный текст рядом с нормализованной подписью и признаком изменения. Для отказов записывайте номер строки и понятную причину, не останавливая всю обработку без отчёта.
В примере ниже вход проверяется, затем сворачиваются обычные пробелы. Если нужны правила для NBSP или пустого результата, добавьте их явно. Не изменяйте исходный массив задним числом, если он нужен для сверки с поставщиком. Для больших файлов обрабатывайте строки последовательно и ограничивайте размер каждой записи.
Чтение таблицы и кодировка файла — отдельный этап. Его можно связать с League CSV, а преобразование JSON в DTO — с Symfony Serializer. Такая цепочка даёт понятные границы: прочитать, проверить, преобразовать, сохранить и сформировать отчёт.
foreach ($rows as $number => $row) {
    try {
        $result = StringLab::execute([
            'operation' => 'whitespace', 'text' => $row['name'],
        ]);
        $report[] = ['row' => $number, 'original' => $row['name'],
            'result' => $result['result']];
    } catch (InvalidArgumentException $error) {
        $errors[] = ['row' => $number, 'reason' => $error->getMessage()];
    }
}
HTML-экранирование: преобразованный текст всё ещё остаётся данными
После NFC, обрезания или замены строка не становится доверенным HTML. Пользователь мог передать теги, кавычки или специальные символы. При выводе в обычный текстовый узел HTML применяйте htmlspecialchars с явной кодировкой и подходящими флагами. В JavaScript используйте textContent для текстового результата.
Экранирование зависит от контекста: текст HTML, URL и данные JavaScript имеют разные правила. Нельзя один раз «почистить строку» и затем безопасно вставлять её куда угодно. Для JSON используйте JSON-кодировщик; для параметра URL — соответствующее кодирование; для SQL — параметры запроса.
В нашем PHP-примере содержимое карточки экранируется непосредственно при выводе. Это сохраняет понятное разделение между нормализацией данных и формированием представления. Описание флагов и поведения при некорректной последовательности есть в мануале htmlspecialchars. Сам компонент String не должен подменять эти механизмы.
$summary = u($input)->truncate(40, '…')->toString();
echo htmlspecialchars(
    $summary,
    ENT_QUOTES | ENT_SUBSTITUTE,
    'UTF-8'
);
Linux/VPS: подключение к приложению и PHP-FPM
Обычно компонент не требует отдельного сетевого сервиса: добавьте его через Composer в существующее приложение и вызывайте PHP-код напрямую. Проект размещайте вне публичного web-root; пользователю PHP-FPM достаточно чтения src и vendor. Права записи во весь каталог ради строковых операций не нужны.
Если отдельный endpoint всё-таки необходим, в исходниках есть фрагмент Nginx для существующего HTTPS server. Путь /internal/string-lab сам по себе не ограничивает доступ. Перед публикацией подключите авторизацию, права и ограничения вашего приложения. Имя сокета PHP-FPM должно соответствовать установленной ветке и конкретному серверу.
После изменения проверьте nginx -t и только затем примените конфигурацию. Убедитесь, что intl и mbstring доступны именно FPM, а не только php в терминале. Не оставляйте публичный phpinfo. Общие настройки прокси и диагностика разобраны в мастерской Nginx; вариант с HTTPS и PHP можно посмотреть в материале Caddy.
Фрагмент deploy/nginx.conf
# Include in an existing HTTPS server. Add your application's authentication first.
location = /internal/string-lab {
    client_max_body_size 10k;
    include fastcgi_params;
    fastcgi_param SCRIPT_FILENAME /opt/string-lab/api/index.php;
    fastcgi_pass unix:/run/php/php8.3-fpm.sock;
}
# Keep /opt/string-lab outside the web document root.
sudo nginx -t
sudo systemctl reload nginx
sudo systemctl status php8.3-fpm
sudo journalctl -u php8.3-fpm -n 50 --no-pagerDocker и проверки: повторяемые результаты вместо предположений
Dockerfile собирает Linux-среду с PHP 8.3.36, расширениями intl/mbstring и Composer 2.11.1. Установка зависимостей требует сеть, а сами строковые проверки запускаются без неё. Команда с –rm удаляет только завершившийся контейнер этого запуска и не затрагивает другие стенды.
В подготовленном проекте прошли тридцать проверок PHP и семь HTTP-проверок на каждой платформе. Отдельно выполнены двадцать восемь вариантов для публичных записей; их смысловые результаты совпали на Windows и Linux. Среди границ проверяются emoji, NBSP, различие ignoreCase/folded, пустой slug и отказ имени с путём.
Это проверка зафиксированного окружения, а не обещание одинакового поведения всех будущих версий Unicode, ICU и PHP. При обновлении зависимостей повторите тесты и сравните записи. В отчёте оставляйте версии и источник выполнения, чтобы изменение можно было объяснить. Сгенерированную на одной платформе запись не следует подписывать как результат другой.
Фрагмент README.md
docker build -t aen-string-lab:1.0.0 .
docker run --rm --network none --read-only --tmpfs /tmp aen-string-lab:1.0.0
php tests/run.php
# В другом терминале должен быть запущен локальный API:
node tests/http.mjs
# Запись фактического запуска:
php tools/record.php > string-record-linux.jsonСвой текст прямо на странице: отдельная JavaScript-панель
Под просмотрщиком PHP-опытов находится поле собственного текста. В нём можно вставить имя, emoji или комбинированную букву и сразу увидеть байты UTF-8, кодовые точки и графемы браузера. Это помогает почувствовать разницу между единицами без установки PHP.
Механизм подписан явно: TextEncoder и Intl.Segmenter JavaScript. Он не выполняет Symfony String, не обращается к PHP endpoint и не является доказательством совпадения ICU браузера с сервером. Для подтверждения собственного PHP-входа используйте CLI или локальный API из архива.
Попробуйте обычную букву, семейный emoji и букву с комбинирующим знаком. Сравните число элементов, затем откройте соответствующий PHP-вариант. Если различие связано с версией сегментации, сохраните точную строку и окружение в отчёт. Разделение механизмов делает мастерскую полезной и не создаёт ложного впечатления серверного выполнения.
const bytes = new TextEncoder().encode(text).length;
const codePoints = Array.from(text).length;
const segmenter = new Intl.Segmenter('ru', { granularity: 'grapheme' });
const graphemes = Array.from(segmenter.segment(text)).length;
// Это результат браузера, а не Symfony String.
Исходники и следующий шаг: внедрите одно понятное правило
Архив содержит PHP-ядро, сценарии, Composer lock, CLI, HTTP endpoint, Dockerfile, конфигурацию Nginx, тесты и статическую мастерскую с точными исходниками. Готовую public можно открыть через локальный сервер; для повторной сборки интерфейса используются npm ci и npm run build. Сборка не подменяет записи PHP.
Для первого внедрения выберите одну задачу: исправить счётчик длины, сократить подпись карточки, обработать пробелы импорта или сформировать slug. Зафиксируйте вход, ожидаемый результат и границы. Затем подключите правило там, где оно действительно нужно, сохранив исходные данные и проверив отображение на телефоне.
Основные источники: Symfony String 7.4, UnicodeString версии 7.4.22, AbstractUnicodeString и расширение intl. Собственные результаты мастерской привязаны к указанным версиям; при обновлении повторяйте проверки, особенно для международного текста.
Фрагмент README.md
npm ci --ignore-scripts
npm run build
npm start