Grafana Loki и Alloy: поиск логов — мастерская и 8 практических задач
Восемь задач диагностики: поиск ошибок, request ID, медленные операции, p95, очистка и хранение логов. Мастерская с настоящими ответами Loki и исходниками.
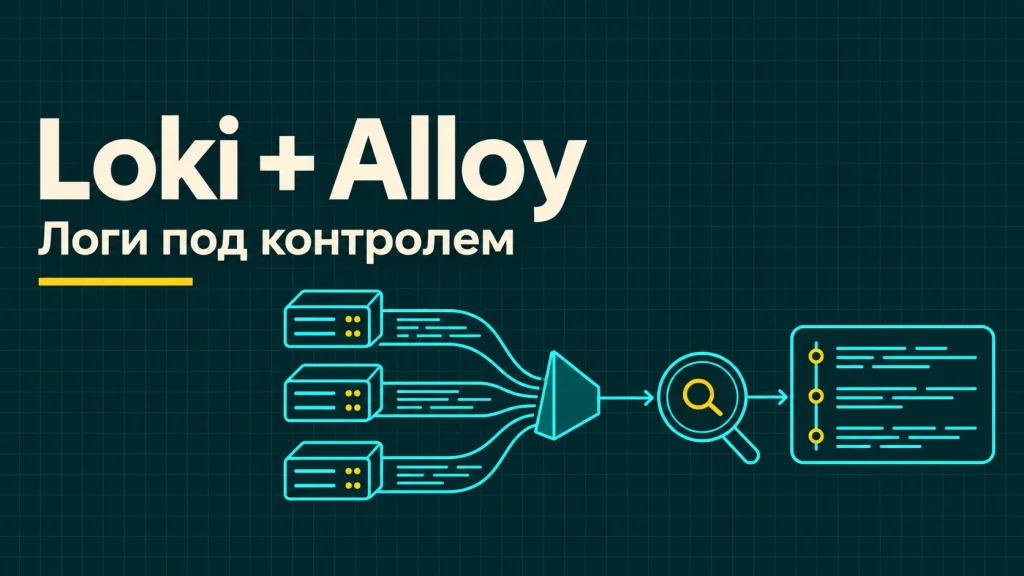
Loki и Alloy на практике: централизованные журналы, LogQL, request ID, p95 и Grafana. Восемь задач, пятнадцать настоящих запросов и готовый стенд Windows/Linux.
Loki и Alloy: найти причину ошибки среди журналов
Пользователь оформил заявку, увидел ошибку и написал в поддержку. Запрос прошёл через reverse proxy, Node.js API и PHP-сервис документов. У каждого приложения свой журнал, а интересующее событие произошло несколько минут назад. Чтобы понять причину, нужно собрать связанные записи, увидеть код ответа, время выполнения и сообщение, не открывая по очереди десятки файлов.
Grafana Loki хранит и позволяет искать журналы, Grafana Alloy доставляет и обрабатывает записи, а Grafana даёт интерфейс поиска и панели. В этой статье соберём настоящий стенд, отправим в него подготовленные JSON-строки и разберём восемь задач: от поиска ошибок до request ID, p95, неправильного JSON и очистки потока. Готовую мастерскую можно изучать прямо здесь, а исходники — запустить самостоятельно.
Практический результат — воспроизводимая основа для централизованной диагностики небольшого сервиса. Вы увидите, какие поля стоит писать в приложении, как искать по ним, почему не каждый идентификатор должен становиться меткой и что потребуется при переносе на Linux/VPS. Отдельно разберём ограничения учебного хранения, доступ к серверу и обслуживание.
Где это применяется и какую задачу решает
Централизованные журналы полезны, когда одна операция проходит через несколько компонентов. Интернет-магазин связывает оформление заказа, оплату и отправку письма; CRM — сохранение обращения и фоновую обработку вложений; внутренний сервис — API, очередь и формирование отчёта. Сотруднику поддержки нужен ответ по конкретному обращению, разработчику — техническая причина, администратору — масштаб проблемы за выбранный период.
Другой распространённый случай — несколько экземпляров приложения. Ошибка могла возникнуть только на одном сервере после обновления. Поиск по общим меткам позволяет сравнить окружение и сервис, а дополнительное поле версии помогает связать изменение поведения с релизом. При этом данные остаются журналами конкретных событий: можно прочитать сообщение и контекст, а не только увидеть красную точку на графике.
Для одного маленького скрипта иногда достаточно локального файла и понятной ротации. Loki становится интереснее по мере роста числа источников, объёма ручного поиска и требований к доступности истории. Решение следует выбирать по реальной задаче диагностики: кто ищет записи, как долго они нужны, сколько поступает данных и кто обслуживает хранилище.
Роли Loki, Alloy и Grafana
Приложение формирует событие. Alloy читает источник, добавляет стабильные метки, при необходимости разбирает или изменяет строку и отправляет её дальше. Loki принимает поток и выполняет запросы LogQL. Grafana обращается к Loki как к datasource и показывает результаты в Explore или на панели. Каждая часть отвечает за свою операцию, поэтому можно отдельно проверять путь доставки и путь поиска.
Alloy не заменяет библиотеку логирования приложения. Именно PHP или Node.js знают, какой заказ обрабатывается, завершилась ли операция и сколько она заняла. Сборщик не должен угадывать бизнес-смысл по случайной строке stack trace. Хорошо организованный JSON-журнал сокращает сложность последующей обработки и делает запросы понятнее.
В нашей лаборатории JSONL создаёт авторский генератор фикстур. Это вымышленные события в форматах трёх сервисов, а не посещения реальных пользователей и не нагрузочный тест PHP. Доставка через Alloy, хранение в Loki, пятнадцать запросов и ответы Grafana datasource выполняются настоящими процессами. Такая граница позволяет безопасно повторять опыт и понимать, что именно подтверждено запуском.
Почему здесь Alloy, а не Promtail
В старых руководствах по Loki часто встречается Promtail. На момент подготовки материала его поддержка уже завершена: официальная документация указывает EOL 2 марта 2026 года. Для нового учебного стенда используем Alloy. Если у вас есть действующий Promtail, переносите настройки по документации миграции и проверяйте фактические метки, позиции чтения и доставку, а не только успешный старт процесса.
Замена агента особенно чувствительна к состоянию чтения файлов. Повторное чтение может породить дубли, а неправильное положение — пропустить часть истории. Сначала выполните перенос на ограниченном источнике, сопоставьте количество и временные границы событий, затем расширяйте область. Сохраните исходную конфигурацию и понятный способ возврата на время перехода.
Официальные сведения: статус Promtail и документация Alloy. Версии в архиве закреплены; при последующем обновлении повторяйте проверки обработки и запросов, потому что успешное скачивание нового образа ещё не доказывает эквивалентность результата.
Что входит в готовый стенд
Compose поднимает Loki 3.7.10, Alloy 1.21.3 и Grafana 13.3.1. Внутренняя сеть соединяет компоненты, а наружу опубликованы только loopback-порты: 8530 для Loki, 8531 для служебного интерфейса Alloy и 8532 для Grafana. Скачиваемый проект содержит конфигурацию, генератор данных, драйвер запросов, тесты и самостоятельный интерфейс мастерской.
Скрипт подготовки создаёт каталог временных журналов и случайный локальный пароль Grafana. Файлы .runtime не входят в архив с исходниками и не должны попадать в репозиторий. Именованные тома сохраняют состояние Loki, Grafana и Alloy между перезапусками. Обычная остановка проекта не удаляет накопленную историю и настройки пользователей.
Кроме фиксированных тегов, файл stack-check.json содержит digest фактически проверенных образов, версию Grafana и успешную проверку datasource. Это помогает отличить заявленную конфигурацию от конкретного запуска. Для изучения интерфейса Docker не нужен: готовая запись включена в public, а небольшой Node-сервер умеет раздать её локально.
Мини-мастерская: восемь задач и пятнадцать запросов
Начните с выбора всех сервисов, затем оставьте только PHP. Во втором опыте сравните HTTP 500 и 404. В третьем найдите один checkout по request ID, в четвёртом — медленные события и p95. Дальше доступны количество и скорость ошибок, разбор повреждённого JSON, очистка потока в Alloy и диагностика пустого результата.
Каждый вариант показывает LogQL, объяснение, метки и настоящий ответ Loki. Текстовый поиск под результатом ищет только внутри уже полученной записи. Конструктор ниже составляет ограниченные запросы по сервису, уровню и HTTP-коду; он не отправляет произвольный запрос на наш сервер. Можно скачать JSON результата или текст запроса, открыть исходники и сверить их хеши.
Механизм обозначен прямо: мастерская воспроизводит результаты настоящих запросов Loki к учебным журналам, доставленным Alloy. Выбор опыта меняет показываемую запись, а не запускает Docker у посетителя. Для исполнения собственного LogQL скачайте архив и откройте Explore в локальной Grafana. Учебные длительности выполнения запросов не являются сравнением производительности серверов.
Как устроены учебные данные
Генератор создаёт 24 HTTP-события для каждого из трёх сервисов: reverse-proxy, node-api и php-billing. Дополнительно появляются предупреждение с явно учебным токеном, debug-строка и одна строка неправильного JSON. Всего получается 75 исходных строк. После удаления debug в Loki остаются 74 записи, что проверяется до выполнения основных запросов.
У каждого запуска есть собственный run. Драйвер добавляет этот фильтр к демонстрационным запросам, чтобы предыдущие запуски не влияли на подсчёт. Интерфейс показывает и понятный основной запрос, и данные выполнения. Временной интервал сохранён вместе с записью: повторное сравнение использует то же окно, а не постоянно сдвигающиеся последние пять минут.
В данных специально есть 12 серверных ошибок, четыре медленных Node-события и три записи одного checkout. Благодаря этому тест проверяет конкретные значения, а не только HTTP 200 от Loki. При адаптации к собственному проекту изменяйте генератор или подключайте настоящий источник; не выдавайте синтетические числа за показатели рабочего сервиса.
JSON-журнал в Node.js
Одна строка — одно событие. Для повседневного HTTP-журнала полезны время, уровень, request_id, маршрут, код ответа и длительность в явно обозначенной единице. В примере duration_ms означает миллисекунды. Если разные приложения используют секунды и миллисекунды в одинаково названном поле, общий p95 будет технически рассчитан, но практически бессмысленен.
Node-пример из архива пишет JSON через process.stdout.write. Для приложения с полноценными уровнями и настройкой вывода есть отдельная мастерская Pino. В приложении такой вызов обычно находится в middleware завершения запроса, а длительность измеряется монотонными часами. Не ограничивайтесь примером с фиксированным 42: он демонстрирует контракт строки, а не измерение времени реального обработчика. Ошибки записывайте структурированно, сохраняя полезную причину без случайного содержимого cookies и заголовков авторизации.
Поток stdout может читать контейнерный сборщик или направлять процесс-менеджер. В данной лаборатории Alloy читает конкретные JSONL-файлы, поэтому простой вывод в терминал сам по себе ещё не попадает в Loki. Это разные этапы: сформировать запись, доставить её в согласованный источник и проверить получение на стороне хранилища.
// Application logging example. Avoid Authorization, cookies and request bodies.
const record={ts:new Date().toISOString(),level:'info',request_id:'demo-request-001',status:200,duration_ms:42,path:'/orders',message:'request completed'};
process.stdout.write(JSON.stringify(record)+'\n');
JSON-журнал в PHP и настройка источника
PHP-пример использует json_encode и выводит событие отдельной строкой. В реальном приложении можно применять принятую библиотеку логирования, например Monolog с JSON-форматтером. Важно сохранить одинаковые имена полей между приложениями и договориться о временной зоне. UTC в ISO-формате упрощает сравнение событий на нескольких машинах.
Вывод PHP CLI и журнал PHP-FPM — разные режимы эксплуатации. Если приложение работает за FPM, заранее настройте, куда попадает выбранный канал: файл с ротацией, stdout контейнера или системный сборщик. Проверьте права на каталог и то, что сборщик читает именно нужный файл. Не открывайте каталог журналов через публичный document root ради удобства просмотра.
Ошибка самой подсистемы журналирования не должна незаметно уничтожать бизнес-операцию или полностью забивать диск. Для рабочего проекта определите допустимый объём, ротацию, реакцию на недоступность назначения и наблюдение за доставкой. Наш пример показывает формат события; полноценная политика хранения и обработки ошибок зависит от приложения и среды.
<?php
declare(strict_types=1);
$record = ['ts' => gmdate('Y-m-d\TH:i:s\Z'), 'level' => 'info', 'request_id' => 'demo-request-001', 'status' => 200, 'duration_ms' => 42, 'path' => '/orders', 'message' => 'request completed'];
// CLI example: forward stdout to a file read by Alloy. Do not log secrets.
echo json_encode($record, JSON_THROW_ON_ERROR | JSON_UNESCAPED_SLASHES), PHP_EOL;
Метки: что индексировать, а что оставить внутри строки
В стенде индексные labels — env, service_name и level. Их набор значений небольшой и понятный: окружение, сервис и уровень. Такой selector быстро ограничивает область поиска, после чего LogQL разбирает содержимое подходящих записей. Метки полезно проектировать как стабильную систему навигации по источникам.
request_id, адрес электронной почты, произвольный URL с параметрами и идентификатор заказа обычно имеют очень много разных значений. Если делать их индексными метками без оценки последствий, число потоков резко растёт. В нашей мастерской request_id хранится в JSON и используется для поиска по содержимому. Тест отдельно проверяет, что в исходных метках потока его нет.
После оператора json в результате могут появиться извлечённые поля. Это не означает, что они были индексными метками при приёме данных. Различайте labels хранения и поля, разобранные во время запроса. Для больших систем существуют дополнительные подходы, включая structured metadata; выбирайте их по документации и профилю запросов, а не переносите все поля в индекс автоматически.
Alloy: прочитать файл, обработать и отправить
Компонент loki.source.file получает три конкретных пути внутри контейнера. Bind mount подключает каталог журналов read-only. В targets задаются service_name и env, а forward_to направляет события в loki.process. Последний передаёт очищенный поток в loki.write с адресом внутреннего сервиса Loki.
Пути внутри контейнера отличаются от путей Windows или Linux-хоста. Если вы смонтировали /var/log/myapp в /logs, __path__ должен указывать на файл внутри /logs. Начинайте диагностику отсутствующих записей с этого соответствия, прав чтения и реального появления новых строк. Запущенный контейнер без ошибок ещё не доказывает, что он нашёл нужный источник.
Состояние Alloy вынесено в отдельный том: позиции чтения должны переживать обычный перезапуск. При замене источников учитывайте ротацию, переименование файлов и ограничения доступа. Для масок нескольких файлов изучите актуальный file_match в документации loki.source.file. В нашем стенде используются явные пути, чтобы первый опыт был воспроизводимым.
loki.source.file "apps" {
  targets = [
    {__path__ = "/logs/node.jsonl", service_name = "node-api", env = "workshop"},
    {__path__ = "/logs/php.jsonl", service_name = "php-billing", env = "workshop"},
  ]
  forward_to = [loki.process.clean.receiver]
}
Опыт 1. Найти сервис и временной интервал
Первый запрос выбирает все записи окружения workshop. Второй добавляет service_name и оставляет только PHP. Это удобная последовательность диагностики: сначала убедиться, что данные вообще есть, затем сузить источник. При поиске конкретного инцидента выставляйте интервал вокруг времени обращения, учитывая временную зону интерфейса.
Пустой результат не равен отсутствию ошибки. Возможно, выбрано другое окружение, имя сервиса изменилось после deploy или нужная запись находится за пределами окна. Сравните список доступных labels, время последних событий и состояние доставки. Такой подход полезнее случайного усложнения регулярного выражения, когда исходный selector уже ничего не находит.
В мастерской общий запрос возвращает 74 строки, PHP — 24. Это контрольные значения учебного набора. В реальном проекте не ожидайте постоянного числа: на него влияют трафик, окно, retention и фильтрация сборщика. Используйте первый опыт для понимания границы выборки, а не как шаблон производственного норматива.
{env="workshop"}
{env="workshop", service_name="php-billing"}
Опыт 2. HTTP-ошибки как числовое условие
Поиск слова error зависит от того, как разработчик сформулировал сообщение. Структурированный status позволяет явно выбрать ответы 500 и выше. Оператор json разбирает строку, фильтр __error__ исключает ошибки разбора, а числовое сравнение оставляет нужные события. Во втором варианте выбираем 404, чтобы увидеть другую категорию проблем.
Не объединяйте все неуспешные ответы в одну причину. 404 может быть нормальным результатом поиска удалённого объекта, 401 — отсутствием авторизации, 429 — действующим ограничением. Даже HTTP 500 требует контекста: какой маршрут, какая версия и какие связанные сообщения появились. Журнал помогает сформулировать гипотезу и найти исходное событие.
В учебной выборке status >= 500 возвращает 12 строк: по четыре события на сервис. Если считать их как число уникальных клиентских инцидентов, получится завышение, потому что один запрос может записываться на нескольких уровнях. Для бизнес-показателя определите единственный источник или правило дедупликации. Техническое число записей и число пользовательских проблем — разные величины.
{env="workshop"} | json | __error__="" | status >= 500
{env="workshop"} | json | __error__="" | status = 404
Опыт 3. Request ID связывает несколько сервисов
Один и тот же request_id проходит через proxy, Node.js и PHP. Запрос выбирает req-checkout-007 и форматирует результат в короткую строку с маршрутом и кодом ответа. В записи видно три события, которые относятся к одной учебной операции. Это помогает восстановить последовательность и понять, на каком уровне возникло расхождение.
В рабочей системе идентификатор нужно создать на доверенной границе и передавать дальше. Внешний клиентский заголовок нельзя бездумно принимать как доказательство идентичности пользователя или операции. Ограничивайте формат и длину, а при необходимости создавайте собственный серверный ID. Возвращать его в ответе удобно для поддержки: пользователь может сообщить номер без передачи содержимого запроса.
Request ID связывает события, но не содержит всей модели распределённой трассы. Для parent/child операций, длительности отдельных шагов и связей между вызовами пригодится tracing. Логи и трассы дополняют друг друга: первое даёт сообщения, второе — структуру выполнения. Начните с согласованного идентификатора, затем развивайте наблюдаемость по потребностям приложения.
{env="workshop"} |= "req-checkout-007"
  | json
  | line_format "{{.request_id}} {{.path}} status={{.status}}"
Опыт 4. Медленные операции и p95
Первый вариант показывает конкретные Node-события с duration_ms больше 700. Такой список удобен для расследования: видны время, маршрут и request ID. Второй вариант извлекает duration_ms через unwrap и вычисляет квантиль 0.95 по каждому сервису за пятиминутное окно. Результат становится числовым рядом, который можно поместить на панель.
Порядок обработки важен: после unwrap фильтруем __error__, чтобы некорректное значение не испортило метрический запрос. Поле должно быть числом в одной единице измерения. В лаборатории это подтверждается фикстурами и проверкой трёх результатов — по числу сервисов. Произвольные строки вроде «около секунды» не являются пригодным измерением.
На маленькой выборке p95 заметно меняется от одного события. Не интерпретируйте учебное значение как SLA или свойство библиотеки. Для мониторинга оцените полноту журналов, sampling, потери доставки, объём окна и распределение нагрузки. Квантили разных групп нельзя просто усреднить, чтобы получить общий p95: агрегирование должно соответствовать исходным наблюдениям.
{env="workshop",service_name="node-api"}
  | json | __error__="" | duration_ms > 700

quantile_over_time(0.95,
  {env="workshop"} | json
  | unwrap duration_ms | __error__="" [5m]
) by (service_name)
Опыт 5. Количество ошибок и скорость потока
count_over_time считает записи в окне, а rate выражает скорость в событиях в секунду. Мы группируем результат по service_name, чтобы сравнивать сервисы. Для нашего набора количество ошибок за пять минут равно четырём на сервис; скорость делит соответствующее количество на длительность окна. Это два разных представления одного потока, а не два независимых измерения.
На панели скорость удобна для поиска всплесков и изменения поведения, количество — для отчёта за фиксированное окно. Если нужен процент ошибок, согласуйте числитель и знаменатель: одинаковый сервис, маршрут, окно и набор учитываемых ответов. Нельзя делить ошибки одного источника на общее число записей всех компонентов и считать результат долей неудачных запросов.
Для предупреждения также понадобятся порог, длительность превышения и политика отсутствия данных. Не создавайте рабочий alert по произвольному числу из лаборатории. Сначала выясните нормальное поведение сервиса, минимальный объём трафика и действие дежурного при срабатывании. Полезное уведомление должно вести к понятной проверке, например к связанному запросу журналов.
sum by (service_name) (
  count_over_time({env="workshop"}
    | json | __error__="" | status >= 500 [5m])
)
sum by (service_name) (
  rate({env="workshop"}
    | json | __error__="" | status >= 500 [5m])
)
Опыт 6. Невалидный JSON и поле __error__
Одна строка в наборе намеренно не является JSON. Loki сохраняет её как текст, а ошибка возникает на этапе разбора оператором json. Запрос с __error__ != “” показывает проблемную запись. Это помогает обнаруживать изменение формата, неожиданное сообщение сторонней библиотеки или смешивание нескольких типов журналов в одном источнике.
В другом варианте выбираем корректные записи Node.js. Фильтр ошибки ставится после операции, которая могла её создать. Для unwrap это особенно заметно: до извлечения числа ещё не возникла соответствующая ошибка преобразования. В метрических запросах не игнорируйте эту деталь, иначе вместо графика можно получить ошибку запроса.
Не удаляйте все непонятные строки автоматически только ради красивой панели. Иногда именно stack trace или аварийное сообщение содержит причину сбоя. Сначала выделите такой поток и решите, как нормализовать формат в источнике. В архиве повреждённая строка остаётся доступной для расследования и не смешивается с числовой статистикой.
{env="workshop"} | json | __error__!=""
{env="workshop",service_name="node-api"} | json | __error__=""
Опыт 7. Очистка строки и удаление debug
Alloy сначала извлекает время и уровень, затем отбрасывает учебный debug и заменяет значение после token=. Правило replace использует захватывающую группу: заменяется именно содержимое группы, а префикс token= остаётся. Проверка ищет очищенную строку и убеждается, что исходного учебного значения в результатах больше нет.
Это узкое правило для конкретного синтетического формата. Оно не найдёт любой пароль, заголовок Authorization, email или вложенный объект. Основная защита — не формировать чувствительные данные в журнале. Очистка в сборщике полезна как дополнительный контролируемый этап, для которого нужны тесты допустимых форматов и понимание того, где остаётся исходный файл.
Удаление debug тоже влияет на полноту истории. Если вы отбрасываете события или используете sampling, числовые показатели из журналов меняются. Зафиксируйте это в договорённости команды, наблюдайте за количеством отброшенных строк и не используйте урезанный поток как единственный источник критического аудита. В нашей лаборатории отброшена ровно одна заранее известная строка.
stage.replace {
  expression = "token=([A-Za-z0-9_]+)"
  replace = "[REDACTED]"
}
stage.drop {
  source = "level"
  value = "debug"
  drop_counter_reason = "workshop_debug"
}
Опыт 8. Пустой результат — начало диагностики
Запрос env=”production” возвращает ноль строк, потому что все учебные события принадлежат workshop. Переключение на существующий reverse-proxy сразу показывает записи. Этот простой опыт учит проверять исходную область поиска прежде, чем подозревать сломанную базу или усложнять выражение.
Если строки отсутствуют и в широком запросе, проверьте источник, Alloy и время. Убедитесь, что файл растёт, доступен сборщику и не был уже прочитан с другой позиции. Затем смотрите ошибки отправки и состояние Loki. При ошибке часов событие может оказаться далеко за видимым окном или быть отвергнуто как слишком старое.
В интерфейсе пустое состояние имеет собственное объяснение и сохраняет запрос. Пользователь должен отличать «ничего не найдено» от «не удалось выполнить запрос» и «идёт загрузка». Этот принцип полезен и для ваших административных панелей: одинаковая пустая таблица для всех трёх случаев мешает человеку понять следующий шаг.
Windows: запуск без догадок
Для настоящего стенда установите Node.js 24 LTS и Docker Desktop с Linux containers. Распакуйте архив в отдельный каталог и выполняйте команды из его корня. npm ci восстанавливает зафиксированные зависимости, prepare создаёт необходимые файлы, Compose запускает три сервиса, capture дожидается готовности и выполняет запросы.
Проверка verify подтверждает количество записей, HTTP-ошибки, корреляцию, очистку и хеши исходников. Если вы изменили config или генератор, пересоздайте запись. Не исправляйте ожидаемые числа только ради зелёной проверки: сначала убедитесь, что изменение действительно соответствует новой задаче и не скрывает потерю событий.
Grafana открывается на http://127.0.0.1:8532, пользователь admin. Локальный пароль создан в .runtime/admin_password. Не публикуйте его и не включайте runtime-каталог в общий архив. Если именованный том Grafana уже содержит пользователя, изменение файла пароля не является автоматическим сбросом его учётной записи.
npm ci
npm run prepare:lab
docker compose config --quiet
docker compose up -d
npm run capture
npm run verify
npm test
node tools/check-stack.mjs
node tools/serve.mjs

# Только локально, не в общий отчёт:
Get-Content .runtime/admin_password
Linux и VPS: отдельный каталог и проверка сервиса
На сервере используются Docker Engine, Compose v2 и Node.js 24 LTS. Установку Docker выполняйте по инструкции для своего дистрибутива; для Ubuntu есть официальный порядок установки. Подготовьте отдельный каталог проекта, проверьте свободные порты и не смешивайте учебные тома с данными рабочего приложения.
После распаковки команды запуска почти те же. Дополнительно ограничьте права каталога runtime и файла пароля. Проверьте docker compose ps, готовность datasource и реальные результаты capture. Наличие контейнера в статусе running не означает готовность всего пути: запись должна пройти источник, обработку, доставку и запрос.
В README есть вариант подготовки через официальный Node-контейнер, если Node не установлен на VPS. Для повторной Linux-проверки предусмотрен профиль tools. Он использует тот же сохранённый временной интервал и run; новые данные создаются обычным capture. Не запускайте генератор бесконечно как фоновой демон: он предназначен для контролируемого опыта.
mkdir -p ~/labs/loki
cd ~/labs/loki
# Распакуйте сюда проект
npm ci
npm run prepare:lab
chmod 700 .runtime
chmod 600 .runtime/admin_password
docker compose up -d
node tools/capture.mjs
node tools/verify.mjs
node tools/check-stack.mjs
docker compose ps

# Повтор тех же запросов из Linux-контейнера:
docker compose --profile tools run --rm linux-capture
docker compose --profile tools run --rm linux-capture node tools/verify.mjs
Как открыть Grafana на VPS и сохранить закрытые порты
В нашей конфигурации Grafana доступна только через loopback сервера. Для личной работы создайте SSH-туннель со своего компьютера и откройте локальный адрес в браузере. Так можно изучать удалённый стенд, не публикуя порт 3000 или 8532 в Интернет. Если локальный порт занят, выберите другой левый порт в параметре -L.
Для команды потребуется осознанная схема доступа: HTTPS reverse proxy, индивидуальные пользователи и роли Grafana, ограничения на доступ к datasource и административным настройкам. Не считайте одно включение TLS полноценной авторизацией. Закрывайте прямой обход proxy и проверяйте доступ снаружи после изменения правил сети.
У Loki нет встроенного механизма аутентификации пользователей. Параметр auth_enabled относится к модели tenant, а не включает форму входа или пароль. Поэтому не выставляйте его HTTP API в публичную сеть с ожиданием, что название параметра защитит данные. Архитектура доступа описана в официальной документации Loki.
# На вашем компьютере:
ssh -L 8532:127.0.0.1:8532 user@server
# Затем откройте http://127.0.0.1:8532
Grafana Explore и готовая панель
Datasource Loki создаётся автоматически через provisioning. В Grafana Explore выберите его, установите нужный интервал и вставьте один из запросов статьи. После переключения с логового запроса на метрический меняется форма результата: вместо строк появляются числовые ряды. Начните с малого интервала, чтобы понимать объём поиска и границу данных.
В архиве есть JSON панели с тремя виджетами: журналы сервисов, скорость ошибок и p95 длительности. Она нужна как отправная точка наблюдения за одним набором данных. Изменяйте сервис, окно, подписи единиц и назначение панели под конкретную роль: разработчик расследует событие, дежурный следит за отклонением, руководитель обычно нуждается в других показателях.
Provisioning делает настройку воспроизводимой, но требует договорённости об источнике изменений. Если dashboard генерируется из файла, ручное редактирование в браузере может разойтись с версией в репозитории. Сохраняйте согласованную конфигурацию и проверяйте её после deploy. Скрипт check-stack в проекте подтверждает наличие трёх панелей и работоспособность datasource.
Хранение, retention и границы одного сервера
Учебный Loki работает одним процессом с filesystem storage и replication_factor=1. Это удобно для первого запуска и небольшого стенда, но не является отказоустойчивым кластером. Сбой диска или сервера влияет на доступность истории. Для рабочего объёма заранее оцените поступление данных, длительность хранения и требования к восстановлению.
Retention 168 часов включён через compactor. Удаление выполняется асинхронно; само наличие числа в конфигурации не гарантирует, что диск никогда не заполнится. Нужны наблюдение за свободным местом, проверка работы compactor и резерв по росту потока. Не добавляйте бездумное ручное удаление внутренних файлов Loki как способ освободить место.
Для больших объёмов изучите поддерживаемое объектное хранилище, модель развёртывания и резервное копирование. Снимки должны быть согласованы с процессом записи и выбранным backend. Полезные официальные разделы: filesystem storage и retention. Учебный Compose не обещает production HA.
Повседневная диагностика и аккуратная остановка
Если Alloy не доставляет данные, начните с его журнала и доступа к файлам. Если Loki отклоняет запись, проверьте временную метку, размер и ответ сервера. Если Grafana не видит datasource, проверьте внутренний адрес http://loki:3100 и общую сеть. Адрес localhost внутри контейнера обозначает сам контейнер, а не соседний сервис.
На машине с несколькими Docker-проектами может возникнуть пересечение подсетей. В архиве предусмотрена переменная LAB_SUBNET. Выберите свободную частную подсеть после проверки существующих маршрутов и сетей; не удаляйте чужие сети для запуска мастерской. Аналогично обрабатывайте занятые порты: изменяйте публикацию своего стенда, сохраняя другие приложения.
Команда down останавливает только текущий Compose-проект и сохраняет тома. Флаг -v удаляет их содержимое, поэтому в обычной инструкции остановки он не используется. Перед обновлением сохраните конфигурацию, зафиксируйте используемые версии и выберите способ восстановления. Проверяйте результат реальным запросом, а не только отсутствием сообщения об ошибке в консоли.
docker compose logs --tail 80 alloy
docker compose logs --tail 80 loki
docker compose logs --tail 80 grafana
docker compose ps
docker compose down

# При подтверждённом пересечении подсети, Bash:
export LAB_SUBNET=10.203.219.0/24
# В PowerShell: $env:LAB_SUBNET='10.203.219.0/24'
# Выбранная сеть должна быть свободна в вашей среде.
Логи, метрики и трассы: как сочетать
Логи отвечают на вопрос, что произошло в конкретном событии и какой контекст доступен. Метрики показывают изменение показателя во времени. Трассы помогают увидеть путь операции через компоненты и длительность отдельных шагов. На сайте есть практические материалы про Prometheus и OpenTelemetry с Jaeger. Один инструмент не обязан заменить все остальные: полезнее согласовать имена сервисов, окружения, время и идентификаторы.
Из журналов можно вычислять показатели, как мы сделали с rate и p95. Но полнота таких чисел зависит от политики записи, фильтрации и доставки. Если критический показатель должен учитывать каждый запрос, предусмотрите соответствующее измерение и контроль потерь. Не делайте вывод об отсутствии ошибок только потому, что сборщик перестал присылать строки.
При внедрении начните с одной полезной цепочки: обращение пользователя → request ID → связанные журналы → причина и действие. Затем добавьте панель и осмысленное предупреждение. Так наблюдаемость будет помогать реальной работе команды, а не сводиться к коллекции красивых графиков без понятного способа расследования.
Как проверены примеры и что лежит в архиве
Драйвер действительно запускает пятнадцать запросов к Loki. До этого он ждёт доставки всех 74 строк через Alloy. Проверки подтверждают двенадцать HTTP 500, три события одного request ID, четыре медленных Node-события, повреждённую строку, очищенный токен и отсутствие debug. Отдельно проверяются три p95-результата и хеши файлов, использованных при выполнении.
Проверены Windows-драйвер и Linux-контейнерный повтор. Сервисы Loki, Alloy и Grafana работают в Linux-контейнерах в обоих случаях; это не означает нативный Windows-исполняемый файл Loki. Grafana datasource отвечает успешно, готовая панель содержит три виджета. Node.js и PHP-примеры формируют валидные JSON-строки. Физический сервер читателя и его права на журналы потребуют собственной проверки.
Архив содержит Compose, все конфигурации, исходники интерфейса, тесты, фикстуры, реальные записи, README с Windows/Linux и примеры логирования. Авторский код доступен по MIT; лицензия Bootstrap приложена. Контейнеры и node_modules не вложены. Секрет Grafana создаётся при подготовке на вашей машине, а текущие runtime-файлы не распространяются.
Официальные источники и следующий практический шаг
Для продолжения используйте начало работы с Loki, LogQL, метрические запросы, этапы обработки Alloy и provisioning Grafana. Сверяйте примеры с выбранной версией, особенно при обновлении конфигурации хранения и сборщика.
Первое полезное изменение проекта — подключить журнал одного собственного тестового приложения. Согласуйте четыре поля: время, service_name, request_id и duration_ms. Получите одну успешную запись и одну ошибку, найдите их в Explore и свяжите с ответом HTTP. После этого добавляйте второй сервис и панель, сохраняя возможность объяснить каждый шаг доставки.
Так у вас появится проверяемая основа: известный источник, контролируемая обработка, понятный поиск и готовые команды обслуживания. Дальнейшие решения — объём хранения, доступ сотрудников, алерты и масштабирование — можно принимать по измеренным потребностям, используя архив как рабочую лабораторию.