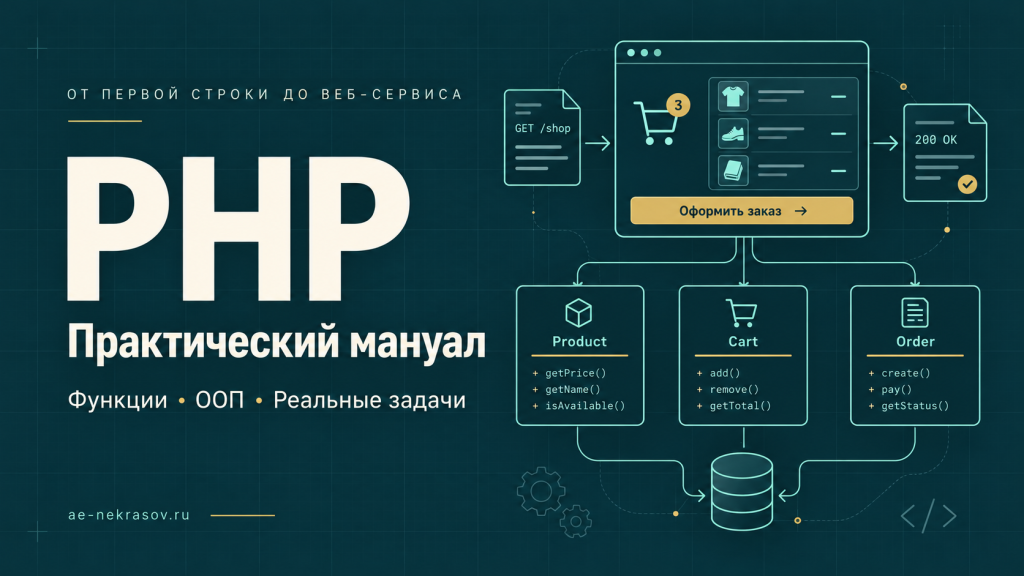
PHP: полный мануал с примерами, функциями и ООП
Практический мануал PHP: от переменных и читаемого кода до безопасных форм, интеграций, базы данных и ООП на примере магазина. Учебный маршрут, поиск функций, подробные примеры, разбор ошибок и исходники для скачивания.
Дерево руководства
Глава 62 · Практика
Производительность: измерения, память и медленные подходы
Ищем узкое место по данным: SQL, сеть, алгоритмы, буферы и кеширование.
Сначала понимаем объём работы, затем измеряем время
Страница может тормозить из-за повторного поиска, сотни SQL-запросов или ожидания сети. Короткая запись функции не означает, что внутри мало работы. Начнём с подсчёта действий без ненадёжных обещаний миллисекунд.
Что уже пригодится. ключи массива, foreach
- Воспроизводим задачу на заданном объёме
- Находим число операций и внешних запросов
- Измеряем узкое место
- Меняем один подход
- Проверяем корректность и измеряем снова
Вложенный перебор сравнивает каждую нужную позицию со всем каталогом. Индекс по ключу позволяет сначала подготовить данные, затем обращаться к ним напрямую. Подготовка тоже стоит времени и памяти.
<?php
declare(strict_types=1);

$products = [
    ['sku' => 'A', 'stock' => 7],
    ['sku' => 'B', 'stock' => 0],
];
$bySku = [];
foreach ($products as $product) {
    $bySku[$product['sku']] = $product;
}
echo $bySku['B']['stock'], "\n";
Ожидаемый результат
0
В учебном наборе ключи уникальны и B существует. Это условия примера, не гарантия внешнего API: реальные дубликаты и отсутствующие ключи проверяют. Выигрыш зависит от количества последующих обращений; для одного чтения подготовка индекса может не окупиться.
Следующая ступень. Теперь измеряем hrtime и память, разбираем SQL N+1, кеш и потоковую обработку. Сначала сохраняем правильный результат, затем оцениваем ускорение.
Быстро для одного запроса и быстро под нагрузкой — разные вещи
Почему индекс по ID убирает повторный поиск
Нужно найти товары для 100 позиций заказа в каталоге из 1000 товаров. Сравним число обходов, а не выдуманные миллисекунды.
- Заново искать в списке
Для каждой позиции повторяется проход по каталогу.
- Взять одну позицию
Заказ просит товар с заданным ID.
- Перебирать каталог
Проверять ID до совпадения или конца: до 1000 сравнений на одну позицию.
- Повторить 100 раз
В худшем случае получится до 100000 сравнений. Повторная работа растёт с обоими списками.
- Один раз построить индекс
Каталог с уникальными ID превращается в таблицу быстрых обращений.
- Пройти 1000 товаров один раз
Сохранить каждый товар под его ID. Договориться, что делать при дубле ID.
- Обратиться по ID
Для каждой из 100 позиций найти запись по ключу; отсутствующий товар обработать отдельно.
- Измерить цену решения
Меньше повторных обходов, но больше памяти под индекс. Проверить итог и время на своих данных.
Эта схема объясняет рост работы. Она не обещает одинаковую скорость на любой машине и не отменяет измерения SQL, сети и памяти.
Страница каталога может отвечать за 200 мс одному посетителю и за пять секунд сотне посетителей. Причина не обязательно в медленной функции PHP: заканчиваются воркеры, база ждёт блокировки, внешний API отвечает дольше или каждый запрос повторяет одинаковую работу. Начинайте с измерения полного пути и числа операций. Среднее значение скрывает хвосты, поэтому смотрите p95/p99 и долю ошибок вместе с нагрузкой.
Для длительности внутри процесса используйте hrtime(true), для памяти — memory_get_usage и memory_get_peak_usage. Сравнивайте одинаковые входы, прогретое окружение, несколько повторов и отдельно холодный запуск. Не публикуйте вывод «array_map всегда быстрее foreach» на основании одного микротеста: размер данных, callback, версия PHP и остальной код меняют результат.
Стоимость алгоритма объясняет рост лучше, чем случайные миллисекунды. Вложенный поиск товара в списке для каждой позиции заказа даёт порядка n×m сравнений. Индекс по ID требует дополнительной памяти, но позволяет один раз пройти справочник и затем делать прямые обращения. Для десятка элементов обе версии могут быть достаточны; для тысяч разница становится архитектурной.
Убираем повторный линейный поиск
<?php
declare(strict_types=1);

$products = [['id'=>10,'name'=>'Tea'],['id'=>20,'name'=>'Coffee']];
$lines = [['productId'=>20,'quantity'=>2],['productId'=>10,'quantity'=>1]];
$byId = [];
foreach ($products as $product) $byId[$product['id']] = $product;
foreach ($lines as $line) {
    $product = $byId[$line['productId']] ?? null;
    if ($product === null) throw new DomainException('Unknown product');
    echo $product['name'].':'.$line['quantity']."
";
}
Ожидаемый результат
Coffee:2
Tea:1
Построение индекса — один проход по справочнику, затем обращения по ключу. При дубликатах ID последнее значение перезапишет предыдущее: если дубликаты запрещены, выявляйте их при построении индекса. Дополнительный массив потребляет память.
Не материализуем всё, если нужен один проход
<?php
declare(strict_types=1);

function quantities(int $count): Generator {
    for ($i=0;$i<$count;$i++) yield ($i % 3)+1;
}
$sum = 0;
foreach (quantities(100000) as $quantity) $sum += $quantity;
echo $sum."
";
Ожидаемый результат
199999
Генератор выдаёт элементы по одному. Выигрыш касается хранения последовательности, а не магического ускорения CPU. Если затем вызвать iterator_to_array, весь результат снова окажется в памяти. В реальном импорте источник тоже должен читаться потоково.
fetchAll, file_get_contents и ob_start удобны для ограниченного объёма, но материализуют данные целиком. Большой CSV обрабатывают строками, экспорт — страницами по ключу, JSON огромного размера требует подходящего потокового парсера либо изменения API. json_decode не становится потоковым от того, что результат потом обходится генератором: исходная строка и структура уже загружены.
Повторная конкатенация и копирование больших массивов могут увеличить пиковую память. PHP использует copy-on-write, поэтому присваивание массива не всегда немедленно копирует всё, но изменение общей структуры может потребовать копию. Не делайте вывод о памяти только из числа переменных. Измеряйте пик на реальном размере данных и учитывайте буферы расширений, которые не всегда полностью видны счётчикам PHP.
Подходы, которые особенно часто становятся дорогими
| Подход | Почему дорого | Что проверить / альтернатива |
|---|---|---|
| SQL в цикле N+1 | Много сетевых обменов и планов | JOIN, пакетная выборка, число запросов |
| LIKE с ведущим % | Обычный индекс может не помочь | План запроса, полнотекстовый поиск |
| password_hash при входе для фиктивного пользователя | Намеренно дорогой расчёт повторяется | Заранее подготовленный фиктивный хеш и rate limit |
| sleep в HTTP | Занятый воркер не обслуживает другого клиента | Очередь и available_at |
| Неограниченный regex на внешнем тексте | Возможен дорогой backtracking | Лимит длины, простой парсер, проверка PCRE-ошибки |
| Сборка большого HTML/CSV в строку | Пиковая память и задержка первого байта | Потоковая обработка при подходящей инфраструктуре |
| Сериализация всего объекта в каждом логе | CPU, память и утечка данных | Структурированные безопасные поля |
Кеш сокращает повторную работу, но добавляет вопросы актуальности, ключа и сброса. Кеш цены должен учитывать валюту, сегмент покупателя и версию прайс-листа. Ошибка ключа может показать чужую скидку. При одновременном истечении популярного ключа множество запросов начнут один дорогой расчёт; нужны координация обновления, случайное распределение TTL или выдача допустимого устаревшего значения.
OPcache хранит скомпилированный код и обычно полезен для веб-приложений. Он не кеширует результат SQL и не исправляет N+1. JIT не является универсальным ускорителем веб-сайта, где значительная часть времени уходит в I/O. Настройки выбирают измерением на целевой нагрузке, а не копированием максимальных чисел из статьи.
Время и память ограничивают намеренно
У каждого внешнего вызова должен быть timeout, у выборки — разумная граница, у загрузки — предел байтов, у рекурсии — ограничение глубины. Это одновременно надёжность и производительность. Больший memory_limit может временно скрыть утечку, но уменьшит число параллельных воркеров в доступной RAM. Рассчитывайте вместимость сервера по фактической памяти процессов с запасом, а не только по лимиту PHP.
Оптимизация завершена, когда измерения подтверждают улучшение без изменения результата и ухудшения важных сценариев. Сохраните вход, окружение и метод измерения. Сравнивайте не только скорость успешного ответа, но и поведение при ошибке API, конкуренции базы и пустом кеше. Именно эти режимы часто определяют устойчивость сайта в реальной работе.
Скорость не должна разрушать корректность
Быстрый кешированный ответ с чужими данными хуже медленного правильного. Перед оптимизацией зафиксируйте инварианты: права пользователя, актуальность цены, допустимую давность остатков и порядок операций. Кеш публичного описания товара и кеш доступного пользователю заказа имеют разные ключи и правила инвалидирования. Нельзя переносить одну стратегию на всё приложение.
Измеряйте стоимость промаха и одновременного обновления кеша, а не только идеальный hit. Проверяйте, что отказ кеша не превращается в лавину запросов к базе. Ограничение параллельности обновления и постепенное распределение TTL часто важнее ещё одной микросекунды сериализации. Любые числа скорости в документации без размера данных и окружения рассматривайте как пример методики, а не обещание результата.
Практика: проверьте решение, а не только успешный путь
Импорт 50 000 товаров использует foreach и на каждом шаге SELECT поставщика. С чего начать оптимизацию?
Разбор решения
Измерить количество и длительность запросов. Собрать нужные supplier_id и получить справочник пакетно либо использовать подходящий JOIN. Построить индекс по ID. Затем проверить память и размер пакета. Замена foreach на array_map не устраняет 50 000 сетевых обращений.
Функции и методы этой темы
Откройте карточку, чтобы увидеть договор функции, примеры, ограничения и связанные инструменты.
hrtimeПолучить монотонную отметку для измерения длительности, а не календарную дату.
PHP 7.3+; macOS implementation changed in PHP 8.5 · standard
hrtime(bool $as_number = false): array|int|float|falseПолучить монотонную отметку для измерения длительности, а не календарную дату.
Скобки после имени запускают вызов; значения внутри — аргументы. Знак = сохраняет возвращённый результат в переменную со знаком $. Функция может вернуть число, строку, массив, true/false либо завершить текущий сценарий. Сначала смотрите минимальный вызов и ожидаемый результат, затем переходите к условиям, функциям и обработке ошибок. Как устроен вызов, параметр и return.
Что произойдёт при вызове
- Снять start перед работой
- Выполнить ровно измеряемую работу
- Снять finish
- finish − start → длительность
Первый запуск и развитие задачи
Число записано в наносекундах, но это не обещание точности в одну наносекунду. Для тайм-аута используйте монотонный deadline; для даты события — DateTime/time.
Полный договор вызова
| Часть вызова | Полный договор |
|---|---|
| as_number=false | Массив [секунды, наносекунды] из двух целых. |
| as_number=true | Наносекунды как int на 64-bit или float на 32-bit платформе. |
| Возврат false | Платформа не предоставила отметку. Проверяйте строго === false. |
| Эпоха | Произвольная и монотонная: значение годится для разности отметок, не для даты, ID или сравнения разных машин. |
Ошибки и границы. Абсолютную отметку не сохраняют как деловую дату и не вычитают из microtime.
Версии и платформа. В PHP 8.5 macOS использует CLOCK_UPTIME_RAW; смысл остаётся монотонной длительностью.
Рядом: sleep, time_nanosleep.
Без аргумента возвращает секунды/наносекунды, с true — числовое значение наносекунд. Часы предназначены для интервалов, а не календарной даты.
<?php
declare(strict_types=1);

$start=hrtime(true);
$sum=array_sum(range(1,1000));
$elapsed=hrtime(true)-$start;
echo $sum===500500 && $elapsed>=0 ? "measured\n" : "failed\n";
Ожидаемый результат
measured
Не печатаем нестабильное число; в профилировании сохраняйте elapsed/1e6 в миллисекундах.
<?php
declare(strict_types=1);

$deadline=hrtime(true)+5_000_000_000;
echo hrtime(true)<$deadline ? "budget remains\n" : "expired\n";
Ожидаемый результат
budget remains
Дедлайн включает время реальной работы, в отличие от счётчика только запрошенных пауз.
Рядом по задаче. microtime(true) даёт wall clock; time/DateTime нужны для даты события.
memory_get_peak_usageПолучить максимум памяти с начала запроса или последнего сброса пика.
Есть в проверенном PHP 8.5.11 · standard
memory_get_peak_usage(bool $real_usage = false): intПолучить максимум памяти с начала запроса или последнего сброса пика.
Пиковая величина отвечает на вопрос «до какого уровня поднималась память», поэтому подходит для импорта, генерации отчёта и обработки больших изображений. После освобождения временного массива текущая память падает, а пик сохраняется. real_usage имеет тот же смысл режимов, что у memory_get_usage.
Первый запуск и развитие задачи
<?php
declare(strict_types=1);

$chunk = str_repeat('catalog;', 20000);
$current = memory_get_usage();
$peak = memory_get_peak_usage();
echo $peak >= $current ? "пик не ниже текущего\n" : "неожиданный счётчик\n";
unset($chunk);
Ожидаемый результат
пик не ниже текущего
Пик сохраняет максимум с начала запроса, даже если временный буфер позже освобождён. Сравнивайте одинаковый режим real_usage.
<?php
declare(strict_types=1);

$temporary = str_repeat('a', 200000);
unset($temporary);
memory_reset_peak_usage();
$current = memory_get_usage();
$peak = memory_get_peak_usage();
echo $peak >= $current ? "новый пик отсчитывается\n" : "ошибка\n";
Ожидаемый результат
новый пик отсчитывается
Сброс меняет только счётчик пика; уже выделенная память не освобождается. Для очистки сначала убирают владельцев данных и закрывают ресурсы.
Полный договор вызова
| Параметр | Что передаём и зачем |
|---|---|
| real_usage | false — пик используемой памяти; true — пик выделенных движку блоков. |
| Часть договора | Что получает программа |
|---|---|
| Сигнатура | memory_get_peak_usage(bool $real_usage = false): int |
| Результат | int байтов. |
| Ошибки и особые значения | Пик процесса не показывает, какой объект был причиной. Сравнение разных real_usage или разных конфигураций вводит в заблуждение. |
| Версии | Есть в проверенном PHP 8.5.11 Официальный диапазон узла: (PHP 5 >= 5.2.0, PHP 7, PHP 8). |
| Среда | Все SAPI, если ниже не указано иное. |
Рядом: memory_get_usage, memory_reset_peak_usage.
Вернуться к карте задач или полному дереву функций.
Возвращает байты пикового потребления. true учитывает выделенные системные блоки, false — используемую память в учёте PHP.
<?php
declare(strict_types=1);

$items=range(1,10000);
$peak=memory_get_peak_usage();
echo $peak>0 ? "peak recorded\n" : "missing\n";
Ожидаемый результат
peak recorded
Точное число зависит от сборки и окружения; сравнение выполняют на одинаковых данных.
<?php
declare(strict_types=1);

$items=range(1,10000);
$before=memory_get_peak_usage();
unset($items);
echo memory_get_peak_usage()>=$before ? "peak retained\n" : "unexpected\n";
Ожидаемый результат
peak retained
Для текущего потребления используют другую функцию; peak хранит максимум.
Рядом по задаче. memory_get_usage показывает текущее значение; системный RSS дополняет измерение.
Код и руководство с собой
Скачайте самостоятельные примеры с исходными данными, инструкциями и ожидаемыми результатами. Примеры HTTP и фрагменты для проекта помечены отдельно: им нужно указанное окружение.
Код не исполняется на сайте. Скачайте нужный пример и запускайте его в своём локальном окружении.
Материалы сверены 2026-10-12. Примеры и объяснения написаны для этого руководства; источники и обсуждения доступны в каждой главе.