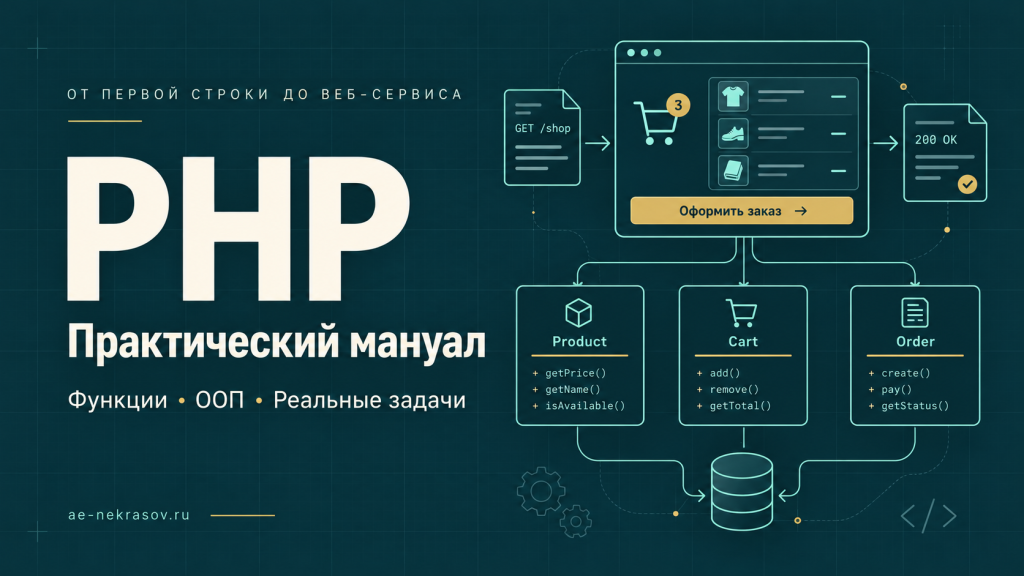
PHP: полный мануал с примерами, функциями и ООП
Практический мануал PHP: от переменных и читаемого кода до безопасных форм, интеграций, базы данных и ООП на примере магазина. Учебный маршрут, поиск функций, подробные примеры, разбор ошибок и исходники для скачивания.
Дерево руководства
Глава 21 · С нуля → практика
Строки, Unicode и безопасное отображение
Разделяем байты, символы, нормализацию и экранирование на примерах карточки товара и импорта.
Подготовить подпись карточки из текста
Название пришло с пробелами по краям. Нужно убрать именно эти пробелы, сохранить слова внутри и добавить подпись. Строку записывают в кавычках; . склеивает, готовая функция trim возвращает обработанный текст. Она не изменяет исходную переменную без присваивания результата.
<?php
$rawTitle = '  Чай с жасмином  ';
$title = trim($rawTitle);
$label = 'Товар: ' . $title;
echo $label, "\n";
Ожидаемый результат
Товар: Чай с жасмином
У trim есть свой определённый набор удаляемых крайних символов; это не универсальная очистка от любых Unicode-пробелов. Внутренний пробел в названии сохраняется.
<?php
function productLabel($rawTitle, $priceRubles)
{
    $title = trim($rawTitle);
    return $title . ': ' . $priceRubles . ' руб.';
}
echo productLabel(' Чай ', 150), "\n";
echo productLabel(' Кофе ', 200), "\n";
Ожидаемый результат
Чай: 150 руб.
Кофе: 200 руб.
Функция возвращает обычный текст для терминала. При вставке такой строки в HTML потребуется контекстное экранирование: красивый текст ещё не означает безопасный HTML.
Попробуйте сами. Замените первый rawTitle на пустую строку из пробелов. Какой случай потребуется обработать?
Разбор решения
После trim получится пустая строка. Это отдельная проверка обязательного названия; trim сам не решает, допустимо ли оно.
Байты и буквы — разные единицы: strlen русской строки не равен числу её букв. Ниже сравниваются strlen, mb_strlen и Unicode, разбираются замены и безопасный HTML. Дополнительное расширение mbstring отмечено у соответствующих примеров.
Одинарные и двойные кавычки: что именно станет текстом
Название магазина, подпись кнопки, письмо покупателю и ответ JSON передаются строками. Начнём со строки, записанной прямо в PHP: кавычки обозначают её границы. Кавычки PHP не являются частью результата. Не путайте их с кавычками HTML-атрибута или JSON: это отдельные форматы со своими правилами.
<?php
$name = 'Анна';
echo 'Здравствуйте, $name', "\n";
echo "Здравствуйте, $name", "\n";
Ожидаемый результат
Здравствуйте, $name
Здравствуйте, Анна
В одинарных кавычках $name остался буквальным текстом. В двойных PHP подставил значение. Такая подстановка называется интерполяцией. В обоих случаях мы получили строку, которую echo вывел. Имя здесь задано нами; внешние данные перед выводом в HTML обрабатывают отдельно.
- В переменной $name хранится «Анна»
- PHP читает "Здравствуйте, $name"
- Получается строка «Здравствуйте, Анна»
- echo отправляет полученную строку в вывод
<?php
echo 'Книга: PHP для O\'Reilly', "\n";
echo "Товар: \"Чай\"", "\n";
echo 'Путь: C:\\reports', "\n";
Ожидаемый результат
Книга: PHP для O'Reilly
Товар: "Чай"
Путь: C:\reports
Обратная косая черта помогает записать кавычку своего вида внутри литерала. Для сложного текста выбирайте удобный вид кавычек, а не множество лишних слешей. Экранирование синтаксиса PHP не является защитой HTML или SQL.
Перевод строки, табуляция, знак доллара и байтовые записи
<?php
echo 'Первая\nВторая', "\n";
echo "Первая\nВторая\n";
echo "Цена: \$25\n";
Ожидаемый результат
Первая\nВторая
Первая
Вторая
Цена: $25
В одинарной строке \n остался обратной чертой и буквой n. В двойной он стал переводом строки. \$ оставляет доллар текстом. В браузерном HTML перенос в исходном ответе обычно не создаёт новую видимую строку: разметка и CSS обрабатывают пробелы по своим правилам.
| Последовательность в двойной строке | Назначение | Где встретится |
|---|---|---|
\n / \r | LF / CR | Текстовые файлы, протоколы с согласованным окончанием строк |
\t | Горизонтальная табуляция | Простой TSV; формат со сложными данными требует настоящего сериализатора |
\v, \f, \e | Вертикальная табуляция, перевод страницы, ESC | Управляющие символы и терминальные протоколы |
\\, \$, \" | Буквальная косая черта, доллар, двойная кавычка | Текст документации и шаблонов |
\101, \x41 | Байт, записанный восьмерично или шестнадцатерично | Разбор двоичного протокола |
\u{0416} | Кодовая точка в UTF-8 | Наглядная запись конкретного Unicode-символа |
<?php
echo "\101", ' ', "\x41", ' ', "\u{0416}", "\n";
Ожидаемый результат
A A Ж
Восьмеричная и шестнадцатеричная записи создают байт. Unicode-запись создаёт UTF-8-последовательность кодовой точки. Обычно русскую букву удобнее написать прямо в исходнике UTF-8. Эти записи полезны, когда нужно явно показать невидимый символ или известный байт протокола.
Склеивание строк: подпись, адрес отчёта и список
<?php
$city = 'Москва';
$street = 'Лесная';
$address = $city . ', ' . $street;
echo $address, "\n";
$address .= ', дом 7';
echo $address, "\n";
Ожидаемый результат
Москва, Лесная
Москва, Лесная, дом 7
Точка соединяет строки, .= сохраняет дописанную строку обратно. Пробелы и запятая не появляются сами — мы передали их отдельной строкой. Оператор + нужен для арифметики или объединения массивов, поэтому не используйте его для склеивания адреса.
<?php
declare(strict_types=1);

function addressLabel(string $city, string $street): string
{
    return $city . ', ' . $street;
}
echo addressLabel('Москва', 'Лесная'), "\n";
echo addressLabel('Тула', 'Садовая'), "\n";
Ожидаемый результат
Москва, Лесная
Тула, Садовая
Сама операция осталась прежней; функция позволяет применять её с другими входами. Здесь параметры уже должны быть нормальными названиями. Проверка полей формы и безопасный HTML-вывод находятся снаружи этой сборки. Если function и return пока незнакомы, начните с базового устройства функции.
<?php
declare(strict_types=1);

$parts = ['Москва', 'Лесная', 'дом 7'];
echo implode(', ', $parts), "\n";
$codes = explode('|', 'A17|B20|C31');
echo $codes[1], "\n";
Ожидаемый результат
Москва, Лесная, дом 7
B20
Implode ставит разделитель между элементами массива. Explode делит по точному разделителю. Они удобны для простого внутреннего договора, но не заменяют разбор CSV с кавычками или JSON со структурой. Если сам разделитель допустим внутри данных, формат требует правил экранирования или другого сериализатора.
Фигурные скобки у переменной: показываем границу имени
<?php
$sku = 'A17';
echo "{$sku}_photo.jpg\n";
echo $sku . '_photo.jpg', "\n";
Ожидаемый результат
A17_photo.jpg
A17_photo.jpg
Скобки отделяют имя sku от следующего _photo. Без них PHP попытался бы прочитать другую переменную $sku_photo. Для отдельного имени, окружённого пробелами, обычно хватает простого $sku. Запись ${sku} устарела с PHP 8.2; используйте {$sku}.
<?php
declare(strict_types=1);

$product = ['name' => 'Чай', 'stock' => 12];
echo "{$product['name']}: {$product['stock']} шт.\n";
$label = $product['name'] . ': ' . $product['stock'] . ' шт.';
echo $label, "\n";
Ожидаемый результат
Чай: 12 шт.
Чай: 12 шт.
Обе записи дают одинаковую подпись. Сложную обработку, вызовы и проверки лучше вынести из интерполяции в отдельные шаги. Ключи и значения объясняются в начале главы массивов. Интерполяция не делает данные безопасными для любого места вставки.
Heredoc и nowdoc: многострочный текст без леса кавычек
Нужно подготовить длинное текстовое уведомление. Можно склеивать строки по одной, но иногда проще видеть текст целиком. Heredoc разрешает подстановки, nowdoc сохраняет содержимое буквально. Выбирайте вариант по тому, должен ли PHP интерпретировать переменные внутри.
<?php
$orderNumber = 17;
$message = <<<NOTICE
Заказ №{$orderNumber}
Готов к выдаче.
NOTICE;
echo $message, "\n";
Ожидаемый результат
Заказ №17
Готов к выдаче.
После <<< записан выбранный нами маркер NOTICE. Такой же маркер завершает литерал. Между ними обычный многострочный текст. Здесь мы только вывели сообщение; отправка письма или Telegram — отдельное действие с собственными настройками и ошибками.
<?php
$instruction = <<<'CODE_SAMPLE'
$price = 150;
echo $price;
CODE_SAMPLE;
echo $instruction, "\n";
Ожидаемый результат
$price = 150;
echo $price;
Кавычки у открывающего маркера включают nowdoc. Поэтому $price не берётся из текущей программы. Это удобно для учебных исходников и текстовых заготовок. При показе такого исходника в HTML всё равно нужно экранирование разметки.
В современном PHP закрывающий маркер может иметь отступ: этот отступ снимается с содержимого. Все строки должны поддерживать согласованную глубину; смешение табуляции и пробелов создаёт ошибки. Маркер выбирайте так, чтобы строка текста случайно не завершила литерал. Для сложных HTML-страниц используйте отдельные шаблоны, а не бесконечный heredoc.
Строка хранит байты: почему strlen("Чай") не равно трём
Русская буква в UTF-8 занимает несколько байтов. Поэтому размер передаваемого тела и количество символов в подписи — разные задачи. Перед выбором функции назовите, что вы ограничиваете: байты запроса, кодовые точки текста или видимые пользователю символы.
- Ч → D0 A7: байты 0 и 1
- а → D0 B0: байты 2 и 3
- й → D0 B9: байты 4 и 5
Две пары знаков внутри каждого блока — шестнадцатеричная запись двух байтов одной буквы. Движение по $text[0], $text[1] проходит по этим байтам, а не по буквам. Поэтому разрез между первым и вторым байтом испортил бы кодировку. Для других букв и символов количество байтов может отличаться.
<?php
declare(strict_types=1);

$text = 'Чай';
echo strlen($text), "\n";
echo mb_strlen($text, 'UTF-8'), "\n";
Ожидаемый результат
6
3
Strlen считает байты. Mb_strlen с явно указанной UTF-8 считает символы этой кодировки; требуется расширение mbstring. Видимая буква с комбинируемым знаком или составной emoji может состоять из нескольких кодовых точек: для таких границ смотрите grapheme_* из intl.
<?php
$code = 'A17';
echo $code[0], ' ', $code[-1], "\n";
$code[0] = 'B';
echo $code, "\n";
Ожидаемый результат
A 7
B17
Индекс 0 — первый байт, -1 — последний. Замена одного ASCII-байта подходит для этого известного формата, но попытка так менять кириллицу может повредить UTF-8. Для текста используйте mb_substr и другие средства нужной кодировки. Доступ через фигурные скобки, встречающийся в старом PHP, удалён в PHP 8; пишите квадратные.
<?php
$packet = "A\0B";
echo strlen($packet), "\n";
echo bin2hex($packet), "\n";
Ожидаемый результат
3
410042
String может хранить двоичные данные, а не только текст. Здесь bin2hex делает байты видимыми:41,00,42. Однако конкретная функция может запрещать нулевые байты, например при работе с путями. Тип string не обещает, что любое его значение допустимо для любого API.
Превратить в строку — не значит подготовить правильный формат
<?php
echo '[' . (string) true . ']', "\n";
echo '[' . (string) false . ']', "\n";
echo '[' . (string) null . ']', "\n";
echo '[' . (string) 25 . ']', "\n";
Ожидаемый результат
[1]
[]
[]
[25]
False и null дадут пустую строку, а true — "1". Это редко подходящие человеческие подписи. Для отчёта задайте явно «Да», «Нет», «Не указано». Для даты, денег и внешнего JSON есть собственные правила форматирования.
<?php
declare(strict_types=1);

$order = ['id' => 17, 'paid' => false];
$status = $order['paid'] ? 'Оплачен' : 'Ожидает оплаты';
echo 'Заказ ' . $order['id'] . ': ' . $status, "\n";
echo json_encode($order, JSON_THROW_ON_ERROR), "\n";
Ожидаемый результат
Заказ 17: Ожидает оплаты
{"id":17,"paid":false}
В первом случае мы оформляем сообщение, во втором сохраняем структуру и тип bool по правилам JSON. Приведение массива к string не сериализует данные полезным образом; объект требует собственного договора преобразования. JSON и многомерные массивы показывают обратный путь из ответа API в данные.
Одна подготовленная строка не становится автоматически безопасной в HTML, SQL, URL и командной оболочке. В HTML нужен соответствующий контексту вывод; в SQL — параметры запроса; в URL — кодирование компонента; для внешней программы — отдельные аргументы. Выбор связан с местом назначения, а не только с типом string.
Строка PHP хранит байты
Строка проходит подготовку перед витриной
Поставщик прислал название с пробелами, а карточке товара нужна короткая безопасно выведенная подпись.
- 1Исходное название↓
« Чай с жасмином » содержит пробелы по краям.
- 2Подготовить текст↓
trim убирает края; mb_substr помогает ограничить длину по выбранному правилу.
- 3Вывести в HTML
htmlspecialchars экранирует специальные символы именно для HTML-контекста.
Очистка формата, сокращение и экранирование решают разные задачи. Перед сокращением решите, считать байты, кодовые точки или видимые символы. Экранирование выбирается по месту вывода, а не применяется «вообще для безопасности».
Вы импортируете каталог поставщика. В названии товара есть пробелы по краям, несколько тегов пришли одной строкой, а на витрине требуется короткий заголовок. Нужно привести данные к правилам своего сайта и показать их без повреждения русского текста. Здесь строковые функции превращаются в этапы одной работы: trim убирает оговорённые краевые символы, explode разделяет простой список, implode собирает подпись, mb_substr сокращает текст по кодовым точкам, htmlspecialchars готовит его для HTML.
Сначала решите, какое именно изменение нужно. Удалить префикс SKU- в начале артикула — не то же самое, что убрать все вхождения SKU- через str_replace. Собрать список тегов через запятую — не то же самое, что сформировать CSV с кавычками и переносами. В примерах ниже каждый выбор связан с тем местом, куда попадёт результат.
Артикул ASCII, русское название и эмодзи — все это string, но длина в байтах различается. strlen считает байты; mb_strlen с UTF-8 — кодовые точки; пользовательский «один символ» иногда состоит из нескольких кодовых точек, и для него нужны grapheme_* из intl. Ограничение поля в 30 символов интерфейса нельзя автоматически проверять strlen <= 30. Зато лимит размера HTTP-тела или бинарного ключа как раз относится к байтам.
<?php
declare(strict_types=1);

$title = 'Кофе';
echo strlen($title), "\n";
echo mb_strlen($title, 'UTF-8'), "\n";
echo mb_substr($title, 0, 2, 'UTF-8'), "\n";
Ожидаемый результат
8
4
Ко
mbstring нужен для этих операций. Для комбинированного эмодзи или буквы с отдельным ударением mb_strlen не равен числу визуальных знаков; это вопрос интерфейсного контракта, а не ошибка UTF-8.
Нормализовать только по договоренному правилу
trim удаляет определенный набор краевых байтов, но не производит универсальную Unicode-очистку. strtolower в актуальной PHP 8.2+ ориентирован на ASCII, для кириллицы нужен mb_strtolower. Не меняйте регистр пароля. Для email учитывайте выбранную политику и особенности локальной части; слепая Unicode-нормализация любых идентификаторов может склеить разные значения. Сырой ввод полезно держать отдельно от канонического, если он нужен пользователю в форме.
<?php
declare(strict_types=1);

$raw = ' php, массивы, ,0 ';
$parts = explode(',', $raw);
$tags = [];
foreach ($parts as $part) {
    $tag = trim($part);
    if ($tag !== '') {
        $tags[] = $tag;
    }
}
echo implode(' | ', $tags), "\n";
Ожидаемый результат
php | массивы | 0
explode подходит для простого разделителя. CSV с кавычками, запятыми внутри названия и переносами требует fgetcsv. Пустую строку мы определили явно, поэтому "0" не потерян.
Экранирование зависит от места вывода
<?php
declare(strict_types=1);

$title = 'Кабель "Pro" <2м>';
$safeTitle = htmlspecialchars($title, ENT_QUOTES | ENT_SUBSTITUTE, 'UTF-8');
echo '<span title="', $safeTitle, '">', $safeTitle, "</span>\n";
Ожидаемый результат
<span title="Кабель "Pro" <2м>">Кабель "Pro" <2м></span>
Это безопасная обработка текстового HTML-контекста и заключенного в кавычки обычного атрибута. Для URL дополнительно проверяют схему и назначение; для JavaScript/SQL нужны другие правила. Не храните в базе только HTML-экранированный текст: одна запись может затем использоваться в JSON или письме.
strip_tags не является универсальной защитой XSS, а регулярное удаление угловых скобок портит текст и оставляет другие опасные контексты. Сначала решите, разрешен ли HTML вообще. Если нужен редактор форматирования, используйте специализированный санитайзер с разрешенным набором тегов и атрибутов. Если нужен текст, экранируйте при выводе. Пользователь не обязан писать без кавычек, чтобы сайт оставался безопасным.
Поиск и преобразование без лишней сложности
Для проверки наличия подстроки используйте str_contains, для префикса str_starts_with, для позиции strpos со строгой проверкой false. Для фиксированной замены str_replace понятнее регулярного выражения. Повторная сборка огромного отчета одной строкой требует памяти; записывайте в поток или отдавайте файл подходящим способом. Размер и количество обработок важнее лозунга «одинарные кавычки быстрее». Не нормализуйте одну и ту же коллекцию на каждом запросе, если можно хранить проверенный канонический ключ.
Попробуйте сами. Нужно показать первые 20 видимых символов отзыва с эмодзи. Достаточно ли substr?
Разбор решения
Нет. substr режет байты и может повредить UTF-8. mb_substr сохраняет кодовые точки, но может разрезать составной знак. Для интерфейсного «видимого символа» изучите grapheme_substr, затем HTML-экранируйте результат.
Функции и методы этой темы
Откройте карточку, чтобы увидеть договор функции, примеры, ограничения и связанные инструменты.
trimПокупатель вставил название товара с пробелами по краям. Нужно получить аккуратную подпись, сохранив пробел между словами. trim возвращает очищенную копию строки; исходную переменную он не переписывает.
PHP 4+ · Core
trim(string $string, string $characters = " \n\r\t\v\x00"): stringВ записи trim($text) одна строка передаётся в функцию. Второй аргумент необязателен; запятая отделяет его от текста.
| Часть договора | Что передать и что получить |
|---|---|
| string | Исходный текст; значение переменной само не меняется. |
| characters | Набор отдельных байтов для удаления. По умолчанию: пробел, TAB, LF, CR, вертикальная табуляция и NUL; form feed сюда не входит. Диапазон записывается как a..z. Это не подстрока и не регулярное выражение. |
| Результат | Новая строка без подходящих крайних байтов с обеих сторон. Строка только из удаляемых байтов превращается в "". |
| Ошибки и границы | Неподходящий тип в строгом вызове даёт TypeError; нормальный результат, включая "", не является признаком ошибки. |
| Версия / расширение | PHP 4+; standard |
- $name = " Кисть широкая " — исходный текст с двумя пробелами по краям.
- trim($name) снимает крайние пробелы; между Кисть и широкая пробел остаётся.
- $clean получает "Кисть широкая"; её можно сохранить или вывести.
<?php
$name = '  Кисть широкая  ';
$clean = trim($name);
echo 'До: [', $name, "]\n";
echo 'После: [', $clean, "]\n";
Ожидаемый результат
До: [  Кисть широкая  ]
После: [Кисть широкая]
Скобки [] в выводе — видимые границы. $name хранит исходную строку, $clean — ответ функции. В вызове trim($name) $name является аргументом. Чтобы заменить исходное значение, присвойте ответ обратно: $name = trim($name).
<?php
$enteredCodes = ['  0  ', '   ', '  TOOL-7  '];
foreach ($enteredCodes as $enteredCode) {
    $code = trim($enteredCode);
    if ($code === '') {
        echo "Укажите код товара\n";
    } else {
        echo 'Ищем товар: ', $code, "\n";
    }
}
Ожидаемый результат
Ищем товар: 0
Укажите код товара
Ищем товар: TOOL-7
Три строки изображают три отдельных ввода. foreach берёт их по очереди. Проверка === '' означает именно пустую строку. empty($code) признала бы строку "0" пустой, хотя для нашего каталога это допустимый код. Если данные пришли из формы, перед trim отдельно проверяют is_string: злоумышленник может отправить code[]=... вместо строки.
<?php
$file = 'music.csv';
echo trim($file, '.csv'), "\n";
if (str_ends_with($file, '.csv')) {
    echo substr($file, 0, -4), "\n";
}
Ожидаемый результат
musi
music
Во втором аргументе trim каждая из букв c, s, v и точка — отдельный удаляемый байт. После .csv исчезает и последняя c из music. Проверка точного суффикса и substr снимают ровно четыре байта .csv. Это задача извлечения части строки, а не очистки пробелов.
<?php
$name = "\u{00A0}Кисть\u{00A0}";
echo 'После trim осталось байтов: ', strlen(trim($name)), "\n";
echo 'После mb_trim: [', mb_trim($name, encoding: 'UTF-8'), "]\n";
Ожидаемый результат
После trim осталось байтов: 14
После mb_trim: [Кисть]
Здесь \u{00A0} в двойных кавычках задаёт неразрывный пробел: визуально он похож на обычный. "Кисть" занимает 10 байтов UTF-8, ещё четыре дают два таких пробела. mb_trim доступна с PHP 8.4 при включённом mbstring. Не удаляйте все невидимые символы из любого текста без правила: переносы и некоторые символы могут быть значимыми.
После очистки строка ещё не становится доверенной: наличие товара проверяют в каталоге, а перед HTML применяют htmlspecialchars. Не обрезайте пароли автоматически: пробел может быть частью пароля.
Маска не означает слово: после удаления крайнего байта следующий становится крайним и тоже проверяется. Не задавайте UTF-8-букву как байтовую маску: можно оборвать другой символ. По умолчанию NBSP U+00A0 не удаляется; в PHP 8.4+ для Unicode-пробелов есть mb_trim/mb_ltrim/mb_rtrim. HTML-сущность сначала требует осознанного разбора HTML. Снятие пробелов не проверяет допустимость значения, не экранирует HTML и не делает путь безопасным.
Проверьте себя. Почему код "0" нельзя считать пустым через empty? В примере после обработки это непустая строка: сравнивайте с "" строго.
Сопоставьте: ltrim, rtrim. Байты, символы и выбор операции.
explodeИз простой записи или списка нужно получить отдельные значения: например теги товара, перечисленные через запятую. explode разрезает строку по точному разделителю и возвращает массив. Он не распознаёт кавычки CSV и не превращает текстовые числа в числа.
PHP 4+ · Core
explode(string $separator, string $string, int $limit = PHP_INT_MAX): array| Часть договора | Что передать и что получить |
|---|---|
| separator | Непустая полная строка-разделитель; она удаляется из результата. Порядок аргументов: сначала разделитель. |
| string | Исходный текст, включая возможные разделители по краям. |
| limit | Положительный: не больше стольких частей, остаток входит в последнюю. 0 означает 1. Отрицательный: отбросить столько последних частей. По умолчанию PHP_INT_MAX. |
| Результат | Массив строк с целыми ключами от 0. Без совпадения обычно один элемент — вся строка; при отрицательном limit без совпадения получается []. Пустой исходник при обычном limit даёт [""]. |
| Ошибки и границы | Пустой separator с PHP 8 вызывает ValueError; раньше возвращался false. |
| Версия / расширение | PHP 4+; standard |
- "инструменты,малярные" — одна строка; запятая разделяет два тега.
- explode(",", $text) создаёт массив с ключами 0 и 1.
- $tags[0] содержит "инструменты", $tags[1] — "малярные".
<?php
$text = 'инструменты,малярные';
$tags = explode(',', $text);
echo 'Первый тег: ', $tags[0], "\n";
echo 'Второй тег: ', $tags[1], "\n";
Ожидаемый результат
Первый тег: инструменты
Второй тег: малярные
Первым передаётся разделитель, вторым исходный текст. Переменная $tags уже содержит массив, а запись [0] берёт первый его элемент. Запятая в результат не входит. Здесь два поля гарантированы нашей строкой; для внешних данных число полей проверяют.
<?php
$text = ' инструменты, ,малярные,0 ';
$tags = [];
foreach (explode(',', $text) as $part) {
    $tag = trim($part);
    if ($tag !== '') {
        $tags[] = $tag;
    }
}
echo 'Теги: ', implode(' / ', $tags), "\n";
Ожидаемый результат
Теги: инструменты / малярные / 0
explode только разделяет, trim обрабатывает каждый фрагмент, if пропускает пустые фрагменты, [] добавляет оставшийся тег в новый массив. Строка "0" сохранена намеренно. implode собирает результат для подписи. Уникальность тегов и ограничение их количества — отдельные требования.
<?php
$record = 'note=ширина=50 мм';
$parts = explode('=', $record, 2);
if (count($parts) === 2) {
    echo 'Поле: ', $parts[0], "\n";
    echo 'Значение: ', $parts[1], "\n";
}
echo '[', implode('|', explode(';', 'A;;')), "]\n";
echo implode('|', explode('/', 'exports/2026/stock.csv', -1)), "\n";
Ожидаемый результат
Поле: note
Значение: ширина=50 мм
[A||]
exports|2026
limit=2 разрешает не более двух частей: всё после первого = остаётся во второй. В A;; два пустых хвостовых поля сохраняются. Отрицательный limit=-1 исключает последнюю часть; если частей недостаточно, результатом будет пустой массив. Пустой разделитель вызывает ValueError — для разбиения на символы предназначены другие функции.
У CSV бывают поля вроде "Кисть, широкая", где запятая находится внутри названия. Такую запись разбирают str_getcsv, файл — fgetcsv. Строить собственный CSV-парсер поверх explode не нужно.
Разделитель — точная последовательность байтов. CSV допускает разделители внутри кавычек: его разбирают str_getcsv/fgetcsv. Для нескольких видов границ подходят preg_split или strtok, но strtok пропускает пустые поля. Ограничивайте размер входного текста до разбиения большого внешнего пакета.
Проверьте себя. Разберите "stock=0" с limit=2. Решение: ["stock", "0"]; значение "0" сохраняют строкой до отдельной проверки числа.
Сопоставьте: implode, str_split, strtok, str_getcsv. Байты, символы и выбор операции.
implodeЕсть несколько отдельных названий, а для письма или подписи нужна одна строка. implode ставит разделитель между значениями массива. Он не решает, какие данные выбрать: сначала подготовьте нужные строки, затем соедините их.
PHP 4+ · Core
implode(string $separator, array $array): string; implode(array $array): string| Часть договора | Что передать и что получить |
|---|---|
| separator | Строка между соседними элементами; в одноаргументной форме это "". |
| array | Массив строк в нужном порядке. Ключи не печатаются. Одноаргументная форма не поддерживает именованные аргументы. |
| Результат | Одна строка; пустой массив даёт "", один элемент — его текст без добавленного разделителя по краям. |
| Ошибки и границы | Неподходящий тип аргумента вызывает TypeError. Вложенные массивы не являются строками для такого объединения. Историческая форма (array, separator) устарела в 7.4 и удалена в PHP 8. |
| Версия / расширение | PHP 4+; standard |
- Массив содержит "Кисть", "Валик", "Лента" — три самостоятельных значения.
- implode(", ", $names) ставит запятую с пробелом между соседями.
- Получается одна строка "Кисть, Валик, Лента" без лишней запятой в конце.
<?php
$names = ['Кисть', 'Валик', 'Лента'];
$caption = implode(', ', $names);
echo 'В заказе: ', $caption, "\n";
echo '[', implode(', ', []), "]\n";
echo implode(['TOOL-', '42']), "\n";
Ожидаемый результат
В заказе: Кисть, Валик, Лента
[]
TOOL-42
[] задаёт массив. Разделитель относится к промежутку между значениями, поэтому после последнего товара запятая не появляется. Пустой массив даёт пустую строку. Одноаргументный вызов соединяет без разделителя.
<?php
$stock = ['Кисть' => 8, 'Валик' => 0];
$lines = ['Остатки на складе:'];
foreach ($stock as $name => $quantity) {
    $lines[] = $name . ': ' . $quantity . ' шт.';
}
$message = implode("\n", $lines);
echo $message, "\n";
Ожидаемый результат
Остатки на складе:
Кисть: 8 шт.
Валик: 0 шт.
На каждой итерации создаётся готовая строка отчёта. Точка . соединяет её части, [] добавляет строку в массив. В конце implode соединяет строки переводами строк. Так получают тело обычного текстового письма или уведомления; отправки в сеть в примере нет. Для HTML, Telegram HTML/Markdown и CSV требуются правила соответствующего формата.
implode/join не экранируют данные. Для SQL IN формируйте placeholders и привязки, для URL используйте http_build_query, для CSV — fputcsv. Не передавайте сюда многомерный массив в надежде получить сериализацию. Новый код обычно выбирает основное имя implode.
Сопоставьте: join, explode, str_getcsv. Байты, символы и выбор операции.
strlenНужно узнать размер строки, например уложится ли текстовый пакет в ограничение устройства. strlen считает байты. Для длины подписи в буквах нужна другая единица — ниже видно, почему одинаковые на вид задачи решаются по-разному.
PHP 4+ · Core
strlen(string $string): intstrlen($text) вычисляет число; $bytes = strlen($text) сохраняет его. Скобки не печатают ответ сами.
| Часть договора | Что передать и что получить |
|---|---|
| string | Строка любых байтов, включая NUL. |
| Результат | Неотрицательное число байтов; для "" — 0. Это не число видимых букв. |
| Ошибки и границы | Неподходящий тип при строгом вызове — TypeError; размер не проверяет кодировку. |
| Версия / расширение | PHP 4+; standard |
- Строка "Кисть" записана в UTF-8: каждая из пяти букв занимает два байта.
- strlen($title) возвращает 10 — размер строки в байтах.
- mb_strlen($title, "UTF-8") возвращает 5 — число кодовых точек, а не ширину надписи.
<?php
$title = 'Кисть';
echo 'Текст: ', $title, "\n";
echo 'Байтов: ', strlen($title), "\n";
echo 'Букв в этом слове: ', mb_strlen($title, 'UTF-8'), "\n";
Ожидаемый результат
Текст: Кисть
Байтов: 10
Букв в этом слове: 5
strlen получает строку и возвращает целое число, а echo показывает это число вместе с подписью. Для mb_strlen нужно расширение mbstring. Кодовая точка не всегда равна видимому знаку: буква с отдельным комбинируемым ударением может состоять из двух точек; для таких задач есть grapheme_strlen.
<?php
$commands = ['TEMP=21.5', 'DISPLAY=Кисть', "A\0B"];
$maxBytes = 12;
foreach ($commands as $command) {
    $bytes = strlen($command);
    if ($bytes > $maxBytes) {
        echo 'Не отправляем: ', $bytes, ' байтов при лимите ', $maxBytes, "\n";
    } else {
        echo 'Пакет помещается: ', $bytes, " байтов\n";
    }
}
Ожидаемый результат
Пакет помещается: 9 байтов
Не отправляем: 18 байтов при лимите 12
Пакет помещается: 3 байтов
Мы проверяем уже сформированную команду, включая DISPLAY=. NUL в A\0B — полноценный байт PHP-строки: размер равен трём. Пример принимает решение до отправки, сам сеть не использует. Проверка strlen после чтения огромного файла не отменяет уже потраченную память: размер входа ограничивают ещё при чтении.
<?php
echo 'Пустой текст: ', strlen(''), "\n";
echo 'Текст 0: ', strlen('0'), "\n";
echo 'Один пробел: ', strlen(' '), "\n";
Ожидаемый результат
Пустой текст: 0
Текст 0: 1
Один пробел: 1
Функция не решает, заполнено ли поле по правилам вашей формы. Пробел имеет размер, но имя только из пробелов обычно отклоняют после trim. Нулевой размер — обычный ответ, а не ошибка. Не делите длину UTF-8 на два: латинские буквы, русские буквы и emoji занимают разное число байтов.
Для количества кодовых точек UTF-8 нужен mb_strlen($text, "UTF-8"); для воспринимаемых символов — grapheme_strlen и корректный UTF-8. Лимит базы данных или протокола может, наоборот, быть байтовым. Не подменяйте единицы; внешний массив сначала отвергают, а не приводят к string.
Сопоставьте: substr, str_split, bin2hex. Байты, символы и выбор операции.
mb_strlenФорма разрешает название длиной до десяти символов. Для русского UTF-8-текста strlen посчитает байты, и короткое слово ошибочно покажется слишком длинным. mb_strlen считает кодовые точки: для обычного слова «Кисть» это пять букв. Составные видимые знаки требуют отдельного понятия графемы.
PHP 4.0.6+ · mbstring
mb_strlen(string $string, ?string $encoding = null): int- $title хранит Кисть: пять букв, десять байтов UTF-8.
- mb_strlen($title, "UTF-8") возвращает 5.
- Число можно показать возле поля или сравнить с разрешённым пределом.
| Аргумент / результат | Что передать и получить |
|---|---|
| string | Текст, чью длину нужно измерить. |
| encoding = null | Имя кодировки исходных байтов. null или пропуск использует текущее mb_internal_encoding(); явное UTF-8 делает локальный пример независимым от чужих настроек. Это не преобразование входа. |
| return | Число символов в смысле декодера: для UTF-8 — кодовых точек, включая отдельные комбинирующие знаки. |
<?php
$title = 'Кисть';
echo 'Название: ', $title, "\n";
echo 'Кодовых точек: ', mb_strlen($title, 'UTF-8'), "\n";
echo 'Байтов: ', strlen($title), "\n";
Ожидаемый результат
Название: Кисть
Кодовых точек: 5
Байтов: 10
Второй аргумент сообщает, как прочитать байты; он не перекодирует строку. Возвращённое число не изменяет $title. Здесь каждая русская буква — одна кодовая точка и два байта, но это не правило для любого текста: emoji и сочетания знаков устроены иначе.
<?php
$limit = 10;
foreach (['Кисть', 'Кисть широкая'] as $title) {
    $length = mb_strlen($title, 'UTF-8');
    if ($length > $limit) {
        echo $title, ': сократите на ', $length - $limit, " кодовые точки\n";
    } else {
        echo $title, ': подходит, осталось ', $limit - $length, " до лимита\n";
    }
}
Ожидаемый результат
Кисть: подходит, осталось 5 до лимита
Кисть широкая: сократите на 3 кодовые точки
Пробел между словами тоже считается. Условие не обрезает данные незаметно: пользователь получает причину отказа. В настоящей форме сначала проверяют, что поле является строкой корректного UTF-8, а размер запроса ограничивают до этой операции. Для лимита именно видимых знаков нужна графемная функция.
<?php
$single = 'é';
$combined = "e\u{0301}";
echo 'Одна кодовая точка: ', mb_strlen($single, 'UTF-8'), "\n";
echo 'Буква и отдельное ударение: ', mb_strlen($combined, 'UTF-8'), "\n";
echo 'Видимых графем во втором варианте: ', grapheme_strlen($combined), "\n";
Ожидаемый результат
Одна кодовая точка: 1
Буква и отдельное ударение: 2
Видимых графем во втором варианте: 1
\u{0301} задаёт отдельный комбинируемый знак. mb_strlen правильно видит две кодовые точки, хотя человек воспринимает одну букву с акцентом. grapheme_strlen принадлежит intl. Требование «20 символов» сначала уточняют: байтов, кодовых точек или графем.
Ошибки и границы. Неизвестная кодировка — ValueError с PHP 8 (раньше warning/false), nullable encoding с 8.0. Не определяет графемы или пиксели. Для большого текста не пересчитывайте длину в каждой итерации без необходимости.
Рядом: mb_substr, mb_strwidth, mb_str_split. Байты, кодовые точки и графемы; общие правила вызова.
substrИз кода заказа нужно вынуть номер, из имени выгрузки — убрать расширение, из ASCII-строки — взять небольшой фрагмент. substr возвращает участок по байтовым позициям. Сначала разберём эти позиции, затем покажем безопасную замену для русского превью.
PHP 4+ · Core
substr(string $string, int $offset, ?int $length = null): stringДва аргумента выбирают начало; третий ограничивает срез. Отрицательная length относится к исходному концу, а не к началу выбранного куска.
| Часть договора | Что передать и что получить |
|---|---|
| string | Исходная строка. |
| offset | Позиция с нуля; отрицательная отсчитывается от конца. |
| length | Положительное — максимум байтов; 0 — пустая строка; отрицательное исключает столько байтов с конца; null/пропуск — до конца. |
| Результат | Извлечённая строка; выход за границы даёт "". В PHP 8+ это не false. |
| Ошибки и границы | Несовместимый тип — TypeError. Разрез внутри UTF-8 может создать неверную строку без отдельной ошибки. |
| Версия / расширение | PHP 4+; standard |
- ORDER-0042: O имеет позицию 0; цифры 0042 начинаются с позиции 6.
- substr($code, 6) берёт всё от позиции 6 до конца.
- В $number оказывается строка "0042": ведущие нули сохранены.
<?php
$code = 'ORDER-0042';
$number = substr($code, 6);
echo 'Номер: ', $number, "\n";
echo 'Префикс: ', substr($code, 0, 5), "\n";
echo 'Последние две цифры: ', substr($code, -2), "\n";
Ожидаемый результат
Номер: 0042
Префикс: ORDER
Последние две цифры: 42
Второй аргумент — откуда начать, третий — сколько байтов взять. Нумерация начинается с нуля. Отрицательное начало -2 означает два байта от конца. substr ничего не преобразует в число и не удаляет нули.
<?php
$name = 'stock.csv';
echo '[', substr($name, 0, 0), "]\n";
echo '[', substr($name, 50), "]\n";
echo '[', substr($name, 0, -4), "]\n";
Ожидаемый результат
[]
[]
[stock]
Нулевая длина и начало за концом дают пустую строку в PHP 8. Отрицательная длина -4 оставляет четыре последних байта вне результата. В реальной обработке сначала проверяют str_ends_with($name, ".csv"), иначе у имени без расширения тоже отрежутся четыре полезных байта.
<?php
$title = 'Кисть широкая';
$maxLetters = 5;
if (mb_strlen($title, 'UTF-8') > $maxLetters) {
    $preview = mb_substr($title, 0, $maxLetters, 'UTF-8') . '…';
} else {
    $preview = $title;
}
echo $preview, "\n";
Ожидаемый результат
Кисть…
Здесь нужен именно mb_substr: substr($title, 0, 5) остановился бы посередине UTF-8-буквы. Многоточие добавляется только при сокращении. Для сочетаний emoji и комбинируемых знаков переходят к grapheme_substr. Эта функция готовит обычный текст; перед выводом в HTML его экранируют.
Для русского превью используйте mb_substr с явной кодировкой; для целой графемы — grapheme_substr. Проверка расширения не определяет тип файла и не разрешает доступ к произвольному пути. PHP 8.0 сделал length nullable и заменил прежние false пустой строкой.
Сопоставьте: strlen, substr_replace, str_ends_with. Байты, символы и выбор операции.
mb_substrНужно получить короткое превью русского названия, не обрывая UTF-8-букву посередине. mb_substr выбирает часть по позициям кодовых точек. Сначала возьмём слово из известной строки, затем добавим многоточие только там, где название действительно сокращено.
PHP 4.0.6+ · mbstring
mb_substr(string $string, int $start, ?int $length = null, ?string $encoding = null): string- Кисть широкая: К стоит на позиции 0, пробел — на 5.
- mb_substr($title, 0, 5, "UTF-8") берёт первые пять кодовых точек.
- Результат Кисть — новая строка; полное название сохранено отдельно.
| Аргумент / результат | Что передать и получить |
|---|---|
| string | Исходный текст. |
| start | Индекс с нуля; отрицательный отсчитывается от конца. За границей начала берётся доступный диапазон, за концом результат пустой. |
| length | Максимум кодовых точек; null/пропуск — до конца. Отрицательный length оставляет указанное количество точек в конце за пределами результата. Ноль даёт пустую строку. |
| encoding = null | Имя кодировки исходных байтов. null или пропуск использует текущее mb_internal_encoding(); явное UTF-8 делает локальный пример независимым от чужих настроек. Это не преобразование входа. |
| return | Новая строка; исходная не меняется. |
<?php
$title = 'Кисть широкая';
echo 'Первое слово: ', mb_substr($title, 0, 5, 'UTF-8'), "\n";
echo 'Окончание: ', mb_substr($title, -7, null, 'UTF-8'), "\n";
echo 'Полное имя: ', $title, "\n";
Ожидаемый результат
Первое слово: Кисть
Окончание: широкая
Полное имя: Кисть широкая
Позиции начинаются с нуля. -7 отсчитывает начало от конца, null в длине означает взять остаток. Для произвольного первого слова лучше искать пробел; здесь длина известна из учебной строки. Возвращаемый фрагмент не меняет исходник.
<?php
$limit = 8;
foreach (['Кисть', 'Кисть широкая'] as $title) {
    if (mb_strlen($title, 'UTF-8') > $limit) {
        $preview = mb_substr($title, 0, $limit - 1, 'UTF-8') . '…';
    } else {
        $preview = $title;
    }
    echo 'Превью: ', $preview, "\n";
}
Ожидаемый результат
Превью: Кисть
Превью: Кисть ш…
Одну кодовую точку бюджета оставили для многоточия. Короткое название не изменилось. Это текстовое превью, а не обрезание HTML: теги и составные графемы требуют иного подхода. Если требуется целое слово, сначала выбирают границу слова; функция сама её не ищет.
<?php
echo '[', mb_substr('Кисть', 0, 0, 'UTF-8'), "]\n";
echo '[', mb_substr('Кисть', 1, -1, 'UTF-8'), "]\n";
echo '[', mb_substr('Кисть', 99, null, 'UTF-8'), "]\n";
Ожидаемый результат
[]
[ист]
[]
Ноль выбирает пустой фрагмент. Начало 1 пропускает К, отрицательная длина -1 оставляет последнюю ь вне результата. Начало за концом также даёт пустую строку. Скобки позволяют увидеть пустой ответ.
Ошибки и границы. С 8.3.2 индексы повреждённых строк согласованы с прочими mb-функциями; SJIS-mac индексируется по результирующим Unicode-кодовым точкам. Для предсказуемой бизнес-логики сначала проверяйте корректность входа. Неизвестная кодировка — ValueError; null encoding с 8.0.
Рядом: mb_strcut, mb_strlen, mb_strimwidth. Байты, кодовые точки и графемы; общие правила вызова.
str_containsНайти товары, в названии которых встречается искомое слово. str_contains возвращает true или false. Ниже ответ сразу управляет действием, поэтому видно, зачем он нужен.
PHP 8.0+ · Core
str_contains(string $haystack, string $needle): boolВ str_contains($text, $rule) сначала передают проверяемый текст, затем критерий. bool в справочной сигнатуре означает логический ответ; двоеточие и тип не пишут в месте вызова.
| Часть договора | Что передать и что получить |
|---|---|
| haystack | Строка, в которой проверяют условие. Название означает «стог сена». |
| needle | Искомая строка — «иголка»; регистр и каждый байт значимы. Пустая строка всегда подходит. |
| Результат | true при выполнении условия, иначе false. Позиция и найденный текст не возвращаются. |
| Ошибки и границы | Типы проверяются по правилам вызова; неверный тип в строгом вызове — TypeError. Пустой needle допустим, поэтому обязательный пользовательский фильтр проверяют отдельно. |
| Версия / расширение | PHP 8.0+; standard |
- 'Кисть широкая' — строка, 'Кисть' — искомая часть.
- str_contains проверяет условие и возвращает true.
- if получает true и выполняет действие внутри фигурных скобок.
<?php
$text = 'Кисть широкая';
$query = 'Кисть';
if (str_contains($text, $query)) {
    echo "Товар подходит\n";
} else {
    echo "Не подходит\n";
}
Ожидаемый результат
Товар подходит
Первым аргументом передаётся проверяемая строка, вторым критерий. if выполняет первую ветку при true, else — при false. Подстрока может находиться в любом месте; функция не проверяет границы слова. Функция сама не выводит текст и не изменяет переменные.
<?php
$items = ['Кисть широкая', 'Валик малярный', 'Кисть узкая'];
$query = 'Кисть';
foreach ($items as $item) {
    if (str_contains($item, $query)) {
        echo $item, "\n";
    }
}
Ожидаемый результат
Кисть широкая
Кисть узкая
foreach берёт каждую строку; if оставляет для вывода только подходящие. Получившийся список — результат работы всей комбинации, а не одной строковой функции. Исходный массив остаётся полным. На большом каталоге отбор выполняют запросом к хранилищу/поисковому индексу вместо загрузки всех записей в PHP.
<?php
$query = '';
var_dump(str_contains('Кисть широкая', $query));
if ($query === '') {
    echo "Введите непустой критерий\n";
}
var_dump(str_contains('PAINT-42', 'paint'));
Ожидаемый результат
bool(true)
Введите непустой критерий
bool(false)
По правилам этих функций пустая строка подходит любой строке. Интерфейс поиска может выбрать иное поведение, например показать подсказку. Регистр значим: PAINT и paint разные. Проверка имени .csv не доказывает формат содержимого и не делает произвольный путь безопасным.
<?php
$title = 'КИСТЬ широкая';
$query = 'кисть';
$searchTitle = mb_strtolower($title, 'UTF-8');
$searchQuery = mb_strtolower($query, 'UTF-8');
if ($searchQuery !== '' && str_contains($searchTitle, $searchQuery)) {
    echo 'Найдено: ', $title, "\n";
}
Ожидаемый результат
Найдено: КИСТЬ широкая
Преобразуются обе поисковые копии, а пользователю показывается исходное название. && означает «оба условия». Нужен mbstring; strtolower умеет только ASCII-регистр в современном PHP. Это простой поиск подстроки, а не морфология, исправление опечаток или учёт всех правил языкового сравнения.
Поиск чувствителен к регистру и безопасен для бинарных строк, но не выполняет Unicode-нормализацию. Проверка .csv не удостоверяет содержимое файла и не защищает путь. Для позиции используйте strpos, для ASCII без учёта регистра — stripos с !== false. Строка "0" является непустым критерием.
Проверьте себя. Замените критерий на другой регистр. Ожидается false: эти три функции не выполняют приведение регистра.
Сопоставьте: str_starts_with, str_ends_with, strpos. Байты, символы и выбор операции.
str_starts_withВыбрать коды товаров с согласованным префиксом категории. str_starts_with возвращает true или false. Ниже ответ сразу управляет действием, поэтому видно, зачем он нужен.
PHP 8.0+ · Core
str_starts_with(string $haystack, string $needle): boolВ str_starts_with($text, $rule) сначала передают проверяемый текст, затем критерий. bool в справочной сигнатуре означает логический ответ; двоеточие и тип не пишут в месте вызова.
| Часть договора | Что передать и что получить |
|---|---|
| haystack | Строка, в которой проверяют условие. Название означает «стог сена». |
| needle | Искомая строка — «иголка»; регистр и каждый байт значимы. Пустая строка всегда подходит. |
| Результат | true при выполнении условия, иначе false. Позиция и найденный текст не возвращаются. |
| Ошибки и границы | Типы проверяются по правилам вызова; неверный тип в строгом вызове — TypeError. Пустой needle допустим, поэтому обязательный пользовательский фильтр проверяют отдельно. |
| Версия / расширение | PHP 8.0+; standard |
- 'PAINT-42' — строка, 'PAINT-' — искомая часть.
- str_starts_with проверяет условие и возвращает true.
- if получает true и выполняет действие внутри фигурных скобок.
<?php
$text = 'PAINT-42';
$query = 'PAINT-';
if (str_starts_with($text, $query)) {
    echo "Это малярный товар\n";
} else {
    echo "Не подходит\n";
}
Ожидаемый результат
Это малярный товар
Первым аргументом передаётся проверяемая строка, вторым критерий. if выполняет первую ветку при true, else — при false. Нужно совпадение строго с начала; X-PAINT-42 под это правило не подходит. Функция сама не выводит текст и не изменяет переменные.
<?php
$items = ['PAINT-42', 'X-PAINT-42', 'PAINT-58'];
$query = 'PAINT-';
foreach ($items as $item) {
    if (str_starts_with($item, $query)) {
        echo $item, "\n";
    }
}
Ожидаемый результат
PAINT-42
PAINT-58
foreach берёт каждую строку; if оставляет для вывода только подходящие. Получившийся список — результат работы всей комбинации, а не одной строковой функции. Исходный массив остаётся полным. На большом каталоге отбор выполняют запросом к хранилищу/поисковому индексу вместо загрузки всех записей в PHP.
<?php
$query = '';
var_dump(str_starts_with('PAINT-42', $query));
if ($query === '') {
    echo "Введите непустой критерий\n";
}
var_dump(str_starts_with('PAINT-42', 'paint'));
Ожидаемый результат
bool(true)
Введите непустой критерий
bool(false)
По правилам этих функций пустая строка подходит любой строке. Интерфейс поиска может выбрать иное поведение, например показать подсказку. Регистр значим: PAINT и paint разные. Проверка имени .csv не доказывает формат содержимого и не делает произвольный путь безопасным.
Поиск чувствителен к регистру и безопасен для бинарных строк, но не выполняет Unicode-нормализацию. Проверка .csv не удостоверяет содержимое файла и не защищает путь. Для позиции используйте strpos, для ASCII без учёта регистра — stripos с !== false. Строка "0" является непустым критерием.
Проверьте себя. Замените критерий на другой регистр. Ожидается false: эти три функции не выполняют приведение регистра.
Сопоставьте: str_contains, str_ends_with, strpos. Байты, символы и выбор операции.
str_ends_withИз списка имён выбрать выгрузки, оканчивающиеся на .csv. str_ends_with возвращает true или false. Ниже ответ сразу управляет действием, поэтому видно, зачем он нужен.
PHP 8.0+ · Core
str_ends_with(string $haystack, string $needle): boolВ str_ends_with($text, $rule) сначала передают проверяемый текст, затем критерий. bool в справочной сигнатуре означает логический ответ; двоеточие и тип не пишут в месте вызова.
| Часть договора | Что передать и что получить |
|---|---|
| haystack | Строка, в которой проверяют условие. Название означает «стог сена». |
| needle | Искомая строка — «иголка»; регистр и каждый байт значимы. Пустая строка всегда подходит. |
| Результат | true при выполнении условия, иначе false. Позиция и найденный текст не возвращаются. |
| Ошибки и границы | Типы проверяются по правилам вызова; неверный тип в строгом вызове — TypeError. Пустой needle допустим, поэтому обязательный пользовательский фильтр проверяют отдельно. |
| Версия / расширение | PHP 8.0+; standard |
- 'stock.csv' — строка, '.csv' — искомая часть.
- str_ends_with проверяет условие и возвращает true.
- if получает true и выполняет действие внутри фигурных скобок.
<?php
$text = 'stock.csv';
$query = '.csv';
if (str_ends_with($text, $query)) {
    echo "Имя подходит для CSV-импорта\n";
} else {
    echo "Не подходит\n";
}
Ожидаемый результат
Имя подходит для CSV-импорта
Первым аргументом передаётся проверяемая строка, вторым критерий. if выполняет первую ветку при true, else — при false. Суффикс должен находиться в самом конце; stock.csv.bak не подходит. Функция сама не выводит текст и не изменяет переменные.
<?php
$items = ['stock.csv', 'stock.csv.bak', 'prices.csv'];
$query = '.csv';
foreach ($items as $item) {
    if (str_ends_with($item, $query)) {
        echo $item, "\n";
    }
}
Ожидаемый результат
stock.csv
prices.csv
foreach берёт каждую строку; if оставляет для вывода только подходящие. Получившийся список — результат работы всей комбинации, а не одной строковой функции. Исходный массив остаётся полным. На большом каталоге отбор выполняют запросом к хранилищу/поисковому индексу вместо загрузки всех записей в PHP.
<?php
$query = '';
var_dump(str_ends_with('stock.csv', $query));
if ($query === '') {
    echo "Введите непустой критерий\n";
}
var_dump(str_ends_with('PAINT-42', 'paint'));
Ожидаемый результат
bool(true)
Введите непустой критерий
bool(false)
По правилам этих функций пустая строка подходит любой строке. Интерфейс поиска может выбрать иное поведение, например показать подсказку. Регистр значим: PAINT и paint разные. Проверка имени .csv не доказывает формат содержимого и не делает произвольный путь безопасным.
Поиск чувствителен к регистру и безопасен для бинарных строк, но не выполняет Unicode-нормализацию. Проверка .csv не удостоверяет содержимое файла и не защищает путь. Для позиции используйте strpos, для ASCII без учёта регистра — stripos с !== false. Строка "0" является непустым критерием.
Проверьте себя. Замените критерий на другой регистр. Ожидается false: эти три функции не выполняют приведение регистра.
Сопоставьте: str_contains, str_starts_with, strpos. Байты, символы и выбор операции.
strposНужно найти, где в строке заканчивается имя поля и начинается значение. strpos возвращает позицию первого совпадения, а затем substr может извлечь нужную часть. Особенно важно отличить позицию 0 от отсутствия совпадения.
PHP 4+ · Core
strpos(string $haystack, string $needle, int $offset = 0): int|falseВ $position = strpos($text, "=") результат сохраняется в переменную. Запись int|false в описании означает два разных вида результата; === проверяет значение вместе с типом.
| Часть договора | Что передать и что получить |
|---|---|
| haystack | Исходные байты; возвращаемая позиция всегда отсчитывается от начала этой строки. |
| needle | Полная искомая подстрока. В PHP 8+ может быть пустой; целое число больше не означает код символа. |
| offset | Неотрицательное значение задаёт старт поиска; отрицательное отсчитывает старт от конца. Это байтовое смещение, не номер буквы. |
| Результат | Позиция первого подходящего вхождения или false; 0 — корректный результат. Позиции нумеруются с нуля. |
| Ошибки и границы | Смещение вне диапазона от -strlen(haystack) до strlen(haystack) даёт ValueError в PHP 8. Пустая иголка разрешена с PHP 8.0. |
| Версия / расширение | PHP 4+; standard |
- В "stock=8" знак = расположен в позиции 5: счёт начинается с нуля.
- strpos($record, "=") возвращает 5.
- substr($record, 6) берёт текст после разделителя: "8".
<?php
$record = 'stock=8';
$position = strpos($record, '=');
echo 'Позиция разделителя: ', $position, "\n";
echo 'Поле: ', substr($record, 0, $position), "\n";
echo 'Значение: ', substr($record, $position + 1), "\n";
Ожидаемый результат
Позиция разделителя: 5
Поле: stock
Значение: 8
Для этой заданной строки разделитель заведомо есть. $position + 1 пропускает сам знак =. Полученное значение "8" пока строка: проверка количества и превращение в число — следующий шаг. Для произвольного внешнего текста нужен следующий пример с проверками.
<?php
$records = ['stock=0', '=8', 'stock'];
foreach ($records as $record) {
    $position = strpos($record, '=');
    if ($position === false) {
        echo "Ошибка: нет разделителя =\n";
    } elseif ($position === 0) {
        echo "Ошибка: нет имени поля\n";
    } else {
        echo 'Принято значение: ', substr($record, $position + 1), "\n";
    }
}
Ожидаемый результат
Принято значение: 0
Ошибка: нет имени поля
Ошибка: нет разделителя =
=== сравнивает значение вместе с типом. false означает «не найдено», целое 0 — «найдено в начале». Проверка if (!$position) смешала бы эти случаи. Значение "0" после разделителя допустимо: оно не потеряно.
<?php
$record = 'A|B|C';
$first = strpos($record, '|');
$second = strpos($record, '|', $first + 1);
echo 'Первая граница: ', $first, "\n";
echo 'Следующая граница: ', $second, "\n";
echo 'Граница в русском тексте: ', strpos('Я=8', '='), "\n";
echo 'Поиск с конца: ', strpos('A|B|C', '|', -2), "\n";
Ожидаемый результат
Первая граница: 1
Следующая граница: 3
Граница в русском тексте: 2
Поиск с конца: 3
Третий аргумент задаёт, откуда искать, но ответ всё равно отсчитывается от начала строки. Я занимает два байта UTF-8, поэтому = имеет позицию 2. Пустая искомая строка допускается с PHP 8; смещение за допустимыми границами вызывает ValueError. Для простого «есть/нет» удобнее str_contains.
Проверка if ($position) теряет найденную позицию 0: используйте !== false. Нельзя считать полученный индекс номером Unicode-буквы. Отрицательное смещение поддерживается с PHP 7.1. Если нужен только логический ответ, str_contains проще; для Unicode-позиций выбирайте согласованное семейство mb_*.
Сопоставьте: stripos, strrpos, strripos, substr, str_contains. Байты, символы и выбор операции.
str_replaceВ подготовленном тексте нужно заменить точную подпись или привести переносы строк к одному виду. str_replace выполняет все совпадающие замены и возвращает новый текст. Для шаблона с несколькими независимыми метками сравните его поведение со strtr.
PHP 4+ · Core
str_replace(array|string $search, array|string $replace, string|array $subject, int &$count = null): string|array| Часть договора | Что передать и что получить |
|---|---|
| search | Одна подстрока или список подстрок. Пустая подстрока не вставляет текст между символами. |
| replace | Одна замена для всех search либо список замен по порядку. Если список короче search, недостающие замены — пустые строки. |
| subject | Строка либо массив строк; форма результата соответствует форме этого аргумента. |
| count | Необязательная переменная для числа замен во всём вызове. & в сигнатуре означает запись по ссылке; в месте вызова & не пишут. |
| Результат | Новая строка/массив с заменами. Исходный subject не изменяется; count получает общее число замен. |
| Ошибки и границы | В строгом вызове неверные типы — TypeError. Массив replace не сочетают с одиночной строкой search: задайте согласованные списки или одну строковую замену. |
| Версия / расширение | PHP 4+; standard |
- "Доставка: курьером" содержит точную подстроку "курьером".
- str_replace("курьером", "в пункт выдачи", $text) создаёт новую строку.
- Исходный текст остаётся прежним; результат можно сохранить в $updated.
<?php
$text = 'Доставка: курьером';
$updated = str_replace('курьером', 'в пункт выдачи', $text);
echo $updated, "\n";
echo 'Исходная подпись: ', $text, "\n";
Ожидаемый результат
Доставка: в пункт выдачи
Исходная подпись: Доставка: курьером
Аргументы идут в порядке «что найти, на что заменить, где искать». Результат возвращается, а не выводится сам. В настоящем заказе способ доставки хранят отдельным значением; этот пример показывает изменение текста, а не замену данных в базе.
<?php
$imported = "Кисть\r\nВалик\rЛента\n";
$changes = 0;
$normalized = str_replace(["\r\n", "\r"], "\n", $imported, $changes);
echo $normalized;
echo 'Нормализовано переносов: ', $changes, "\n";
Ожидаемый результат
Кисть
Валик
Лента
Нормализовано переносов: 2
Массив первого аргумента перечисляет два вида переноса. Сначала CRLF заменяется на LF, затем одиночный CR — тоже на LF. Если поменять порядок, CRLF превратится в два перевода строки. $changes получает число замен: функция записывает в эту переменную, хотя & в месте вызова не пишется.
<?php
$template = 'Покупатель: {name}. Заказ: {order}';
$name = 'Мастерская {order}';
echo str_replace(['{name}', '{order}'], [$name, '42'], $template), "\n";
echo strtr($template, ['{name}' => $name, '{order}' => '42']), "\n";
Ожидаемый результат
Покупатель: Мастерская 42. Заказ: 42
Покупатель: Мастерская {order}. Заказ: 42
str_replace проходит поисковые строки последовательно и меняет {order}, появившуюся из имени покупателя. strtr с картой не ищет повторно внутри вставленного текста и сохраняет исходное имя. Это реальная причина выбрать иной инструмент, а не писать более сложный цикл.
<?php
$labels = ['old-photo', 'old-price', 'unused-note'];
$count = 0;
$updated = str_replace(['old-', 'unused-'], ['new-'], $labels, $count);
echo implode(', ', $updated), "\n";
echo 'Замен: ', $count, "\n";
Ожидаемый результат
new-photo, new-price, note
Замен: 3
Строки внутри массива обрабатываются отдельно, результат тоже массив. Список замен короче списка поиска: для unused- недостающая замена равна пустой строке. Не используйте эту особенность случайно — согласуйте таблицу замен заранее.
Регистр важен; для ASCII без учёта регистра есть str_ireplace. Это замена фиксированных байтов, не разбор языка шаблонов и не проверка HTML/SQL. Вставленные пользовательские значения экранируют для конечного контекста отдельно. Большие списки замен могут многократно проходить по тексту; для независимой карты рассмотрите strtr.
Сопоставьте: str_ireplace, strtr, substr_replace. Байты, символы и выбор операции.
strtrНужно собрать сообщение из шаблона: номер заказа, имя покупателя и состояние. strtr с картой заменяет именованные метки целиком и не превращает уже вставленные значения в новые команды шаблона. У этой функции есть и другая, побайтовая форма — не смешивайте их.
PHP 4+ · Core
strtr(string $string, string $from, string $to): string; strtr(string $string, array $replace_pairs): string| Часть договора | Что передать и что получить |
|---|---|
| string | Исходный текст. |
| from / to | Трёхаргументная форма: каждый байт from заменяется байтом to на той же позиции; лишние байты более длинного аргумента игнорируются. Длина результата сохраняется. |
| replace_pairs | Двухаргументная форма: карта полная_подстрока => замена. Более длинные ключи проверяются первыми; вставленный текст повторно не ищется. Эта альтернативная форма не поддерживает именованные аргументы. |
| Результат | Строка после преобразования. Карта может менять длину; побайтовая форма — нет. |
| Ошибки и границы | Пустой ключ карты игнорируется и с PHP 8 вызывает E_WARNING. Используйте непустые ключи. В трёхаргументной форме UTF-8-буквы распадаются на байты. |
| Версия / расширение | PHP 4+; standard |
- Шаблон: "Заказ {order}: {state}". В карте {order} соответствует "42", {state} — "готов к выдаче".
- strtr ищет ключи карты в исходном шаблоне и вставляет значения.
- Результат: "Заказ 42: готов к выдаче" — готовый текст уведомления.
<?php
$template = 'Заказ {order}: {state}';
$values = ['{order}' => '42', '{state}' => 'готов к выдаче'];
$message = strtr($template, $values);
echo $message, "\n";
Ожидаемый результат
Заказ 42: готов к выдаче
Карта — массив пар «что найти => на что заменить». Фигурные скобки здесь обычные символы выбранного нами шаблона, у strtr нет специального языка шаблонов. Скобки помогают не заменить случайное слово order в остальном тексте.
<?php
$template = '{name}: ваш заказ {order} готов.';
$message = strtr($template, [
    '{name}' => 'Мастерская {order}',
    '{order}' => '42',
]);
echo $message, "\n";
echo strtr('{known} / {missing}', ['{known}' => 'Есть']), "\n";
Ожидаемый результат
Мастерская {order}: ваш заказ 42 готов.
Есть / {missing}
Вставленное имя остаётся буквальным. Неизвестная {missing} сохраняется: функция не проверяет полноту заполнения шаблона. В приложении список обязательных меток известен заранее; отсутствие значения обрабатывают до отправки. В HTML значения экранируют для места вывода, а в обычном тексте HTML-сущности не нужны.
<?php
echo strtr('AB A', ['A' => 'короткий', 'AB' => 'длинный']), "\n";
echo strtr('TOOL_42/BLUE', '_/', '--'), "\n";
Ожидаемый результат
длинный короткий
TOOL-42-BLUE
В карте более длинный ключ проверяется раньше короткого: AB не превращается в «короткийB». В трёхаргументной форме _ сопоставлен первому -, / — второму -. Здесь меняются отдельные байты, поэтому она подходит для выбранных ASCII-разделителей, но не для транслитерации русских букв.
Карта подходит для полных UTF-8-подстрок при корректных исходных данных, но не для Unicode-нормализации или перевода языка. Не используйте байтовую форму для русских букв. Подстановка сама не защищает HTML: подготовьте текст для выбранного контекста. Неизвестные метки остаются в шаблоне, если приложение явно не проверит их.
Сопоставьте: str_replace, str_ireplace, htmlspecialchars. Байты, символы и выбор операции.
strtolowerИмена HTTP-заголовков не чувствительны к регистру. Чтобы внутренний словарь не содержал одновременно X-Request-Id и x-request-id, можно привести именно имя к одному ASCII-регистру. Значение заголовка при этом менять нельзя.
PHP 4+ · Core
strtolower(string $string): string| Часть договора | Что передать и что получить |
|---|---|
| string | Исходный текст; изменяются все ASCII-буквы нужного регистра. |
| Результат | Новая строка; остальные байты и исходная переменная не меняются. Пустая строка остаётся пустой. |
| Ошибки и границы | Неподходящий тип в строгом вызове — TypeError. С PHP 8.2 преобразование не зависит от setlocale и касается только ASCII. |
| Версия / расширение | PHP 4+; standard |
- X-Request-Id — имя служебного заголовка.
- strtolower возвращает x-request-id.
- Под этим единым ключом код находит исходное значение, не меняя его регистр.
<?php
$name = 'X-Request-Id';
$key = strtolower($name);
echo 'Ключ: ', $key, "\n";
echo 'Исходное имя: ', $name, "\n";
Ожидаемый результат
Ключ: x-request-id
Исходное имя: X-Request-Id
Меняются ASCII-буквы, исходная строка остаётся прежней. Функция не убирает пробелы и не проверяет, разрешён ли такой заголовок.
<?php
$headers = ['Content-Type' => 'application/json', 'X-Request-ID' => 'AbC42'];
$normalized = [];
foreach ($headers as $name => $value) {
    $normalized[strtolower($name)] = $value;
}
echo 'Идентификатор: ', $normalized['x-request-id'], "\n";
echo 'Русская строка: ', strtolower('КИСТЬ'), "\n";
Ожидаемый результат
Идентификатор: AbC42
Русская строка: КИСТЬ
Преобразуются ключи, а не значения: AbC42 сохранён. Это небольшой словарь без повторных заголовков, не полноценный HTTP-парсер. Если одно имя встречается многократно, требуется отдельное правило объединения. Для русского регистра есть mb_strtolower; обычный strtolower в PHP 8.2+ от локали не зависит.
Для русских и других Unicode-букв нужны mb_strtolower/mb_strtoupper; для первой буквы в PHP 8.4+ существуют mb_lcfirst/mb_ucfirst. Для сравнения идентификаторов заранее задайте правила регистра, не нормализуйте секреты и пароли.
Сопоставьте: strtoupper, lcfirst, ucfirst, ucwords. Байты, символы и выбор операции.
mb_strtolowerВ поисковом поле покупатель написал «КИСТЬ», а товар называется «Кисть». Для простого русского поиска можно сравнить копии в нижнем регистре и вывести исходное название. mb_strtolower понимает Unicode-буквы; обычная strtolower для этой задачи с кириллицей не подходит.
PHP 4.3+ · mbstring
mb_strtolower(string $string, ?string $encoding = null): string- КИСТЬ → кисть; Кисть широкая → кисть широкая.
- Поиск сравнивает подготовленные копии.
- Покупатель видит сохранённое название Кисть широкая.
| Аргумент / результат | Что передать и получить |
|---|---|
| string | Текст; преобразование — нижний регистр. |
| encoding = null | Имя кодировки исходных байтов. null или пропуск использует текущее mb_internal_encoding(); явное UTF-8 делает локальный пример независимым от чужих настроек. Это не преобразование входа. |
| return | Новая строка той же кодировки. Unicode-отображение может изменить число кодовых точек/байтов. |
<?php
$title = 'КИСТЬ';
echo mb_strtolower($title, 'UTF-8'), "\n";
echo 'Оригинал: ', $title, "\n";
Ожидаемый результат
кисть
Оригинал: КИСТЬ
Функция возвращает строку, не переписывает переменную. Явный UTF-8 сообщает кодировку входа. Числа и пунктуация не становятся буквами; регистр не зависит от setlocale.
<?php
$query = mb_strtolower('КИСТЬ', 'UTF-8');
$titles = ['Молоток', 'Кисть широкая', 'Валик'];
foreach ($titles as $title) {
    if (str_contains(mb_strtolower($title, 'UTF-8'), $query)) {
        echo 'Найдено: ', $title, "\n";
    }
}
Ожидаемый результат
Найдено: Кисть широкая
str_contains ищет точную последовательность уже подготовленных байтов; обе строки здесь корректный UTF-8. Поиск не требует вычисления позиции, поэтому этого достаточно. Это небольшой список: в большой базе используют её индекс и согласованные правила сравнения. Для общего Unicode-сопоставления рассмотрите MB_CASE_FOLD, а пустой запрос обработайте отдельно.
<?php
echo mb_strtolower('ΟΣ', 'UTF-8'), "\n";
echo mb_convert_case('ΟΣ', MB_CASE_LOWER_SIMPLE, 'UTF-8'), "\n";
Ожидаемый результат
ος
οσ
В современном полном lowercase конечная Σ получает форму ς; simple-режим не использует это контекстное правило. Такие различия важны для многоязычных ключей поиска. Не делайте вывод, что любое визуально похожее слово даст одинаковые байты.
Ошибки и границы. Неизвестная кодировка — ValueError. Преобразование основано на Unicode, не на setlocale; турецкие языковые правила и красивое написание имени человека не гарантируются. С 8.3 mb_strtolower учитывает условный конечный греческий sigma.
Рядом: mb_convert_case, mb_strtoupper, mb_lcfirst. Байты, кодовые точки и графемы; общие правила вызова.
sprintfНужно собрать строку одинакового вида из меняющихся значений: номер заказа, название и количество. sprintf возвращает готовую строку по шаблону. Её можно сохранить в переменную, передать отправителю уведомлений или вывести позже.
PHP 4+ · Core
sprintf(string $format, mixed ...$values): stringПрочитайте вызов слева направо: как оформить, затем каждое значение отдельно. Результат функции описан отдельно от её вывода.
| Часть договора | Что передать и что получить |
|---|---|
| format | Фиксированный шаблон: %s — строка, %d — целое, %.2F — дробное с точкой и двумя знаками. Полная грамматика разобрана в отдельном разделе ниже по ссылке. |
| values | Отдельные значения после формата; ... в сигнатуре означает любое их число. Каждый спецификатор потребляет нужное значение. |
| Результат | Возвращает сформированную строку и ничего не печатает. |
| Ошибки и границы | Ошибочный формат/номер/ширина/точность — ValueError; недостаток значений — ArgumentCountError. С PHP 8 эти функции не используют старый false как универсальный ответ ошибки формата. |
| Версия / расширение | PHP 4+; standard |
- Шаблон "Заказ № %04d: %s — %d шт." описывает три места для значений.
- 42 занимает %04d, Кисть — %s, 3 — %d.
- sprintf возвращает "Заказ № 0042: Кисть — 3 шт."; сама функция ничего не печатает.
<?php
$message = sprintf('Заказ № %04d: %s — %d шт.', 42, 'Кисть', 3);
echo $message, "\n";
Ожидаемый результат
Заказ № 0042: Кисть — 3 шт.
%d принимает целое, %s — строковое представление, %04d задаёт минимальную ширину четыре с заполнением нулями. Данные передаются по порядку после шаблона. Шаблон остаётся одним понятным предложением, а меняющиеся значения хранятся отдельно.
<?php
$template = 'Заказ %1$d готов. Назовите номер %1$d при получении. %2$s';
echo sprintf($template, 42, 'Пункт выдачи: Северный.'), "\n";
echo sprintf('Готовность: %d%%', 80), "\n";
echo sprintf('Измерение: %.2F', 12.5), "\n";
Ожидаемый результат
Заказ 42 готов. Назовите номер 42 при получении. Пункт выдачи: Северный.
Готовность: 80%
Измерение: 12.50
1$ и 2$ явно выбирают аргументы; шаблон в одинарных кавычках, чтобы PHP не интерпретировал $. %% выводит один знак процента. %.2F даёт две цифры после точки независимо от локали; %f может зависеть от LC_NUMERIC. Подробная грамматика ширины, точности и флагов находится в этой же книге.
<?php
try {
    echo sprintf('Товар: %s, количество: %d', 'Кисть');
} catch (ArgumentCountError) {
    echo "Для шаблона не передано количество\n";
}
echo sprintf('Комментарий: %s', 'Скидка 20%'), "\n";
Ожидаемый результат
Для шаблона не передано количество
Комментарий: Скидка 20%
Обработчик демонстрирует ошибку: в рабочем коде нужно исправить набор аргументов. Процент внутри отдельного значения безопасен для синтаксиса шаблона, потому что значение повторно не разбирается. Не принимайте произвольный пользовательский текст как формат; для буквального текста передавайте его через %s. Форматирование не экранирует HTML.
Формат задаёт автор программы, пользовательский текст передают через %s. Не путайте оформление с экранированием и проверкой типов/диапазонов. Ширина задаёт минимум, а не обрезание. Все спецификаторы, флаги, точность, аргументы по номеру и ошибки.
Сопоставьте: printf, fprintf, vprintf, vsprintf, vfprintf, number_format. Байты, символы и выбор операции.
htmlspecialcharsЧитатель должен увидеть название «Кабель <Pro> & крепёж» именно как текст. Без обработки браузер может принять <Pro> за тег. htmlspecialchars сохраняет смысл текста, заменяя специальные знаки на запись, безопасную в обычном HTML-тексте и значении атрибута в кавычках.
PHP 4+ · Core
htmlspecialchars(string $string, int $flags = ENT_QUOTES | ENT_SUBSTITUTE | ENT_HTML401, ?string $encoding = null, bool $double_encode = true): stringENT_* — именованные целые константы; | объединяет их биты. Вызов возвращает строку, а не печатает её. Флаги и UTF-8 пишутся явно, чтобы настройка окружения не меняла договор.
| Часть договора | Что передать и что получить |
|---|---|
| string | Исходный текст, корректный в выбранной кодировке. |
| flags | Какие кавычки обрабатывать, как обходиться с повреждением и для какого типа документа. Основной безопасный текстовый пример: ENT_QUOTES | ENT_SUBSTITUTE | ENT_HTML5. |
| encoding | Явное имя, например UTF-8. null использует default_charset; это не автоматическая проверка кодировки. |
| double_encode | true обрабатывает все амперсанды, включая уже записанные сущности. false оставляет распознанные сущности данного типа документа. |
| Результат | Строка с заменами &: &, <: <, >: > и выбранных кавычек. Одиночная кавычка для HTML401 становится ', для XML1/XHTML/HTML5 — '. |
| Ошибки и границы | Повреждённые байты без ENT_SUBSTITUTE/ENT_IGNORE могут дать ""; неизвестная encoding вызывает предупреждение и fallback. ENT_IGNORE не рекомендуют. С PHP 8.1 изменились flags по умолчанию; nullable encoding поддерживается в PHP 8. |
| Версия / расширение | PHP 4+; standard |
- В PHP хранится исходное название: Кабель <Pro> & крепёж.
- htmlspecialchars создаёт Кабель <Pro> & крепёж.
- Браузер читает эту запись и показывает прежние знаки <, > и & как текст.
<?php
$title = 'Кабель <Pro> & крепёж';
$safeTitle = htmlspecialchars($title, ENT_QUOTES | ENT_SUBSTITUTE, 'UTF-8');
echo '<p>', $safeTitle, "</p>\n";
Ожидаемый результат
<p>Кабель <Pro> & крепёж</p>
Ожидаемый результат выше — HTML, который выдаёт PHP. Под ним показано, как его отображает браузер. <p> и </p> — разметка автора, а $title — текстовые данные. ENT_QUOTES обрабатывает оба вида кавычек; ENT_SUBSTITUTE заменяет повреждённый UTF-8 знаком замены. Знак | объединяет флаги, а UTF-8 явно задаёт кодировку.
Кабель <Pro> & крепёж
<?php
$title = 'Кабель "Pro"';
$value = htmlspecialchars($title, ENT_QUOTES | ENT_SUBSTITUTE, 'UTF-8');
echo '<label>Название <input readonly value="', $value, '"></label>', "\n";
Ожидаемый результат
<label>Название <input readonly value="Кабель "Pro""></label>
Значение value заключено в двойные кавычки, а кавычки внутри названия превращены в ". Поэтому Pro остаётся частью названия, а не новым атрибутом. Поле readonly добавлено только для просмотра этого результата. Для настоящей формы также нужны обработчик, проверка введённых данных и остальные шаги главы о формах.
<?php
$original = 'Кисть & валик';
$once = htmlspecialchars($original, ENT_QUOTES | ENT_SUBSTITUTE, 'UTF-8');
$twice = htmlspecialchars($once, ENT_QUOTES | ENT_SUBSTITUTE, 'UTF-8');
echo 'Один раз: ', $once, "\n";
echo 'Дважды: ', $twice, "\n";
echo 'Не кодировать готовые сущности: ', htmlspecialchars($once, ENT_QUOTES | ENT_SUBSTITUTE, 'UTF-8', false), "\n";
Ожидаемый результат
Один раз: Кисть & валик
Дважды: Кисть &amp; валик
Не кодировать готовые сущности: Кисть & валик
В браузере второй вариант покажет буквальное & вместо одного &. Обычная схема — хранить исходный текст и экранировать один раз в нужном месте вывода. double_encode=false подходит осознанному формату, где уже разрешены сущности; он не исправляет неизвестную смесь слоёв. Если пользователь действительно написал буквальные символы &, изменение этого параметра меняет его текст.
<?php
$broken = "Кисть \xC3(";
echo htmlspecialchars($broken, ENT_QUOTES | ENT_SUBSTITUTE, 'UTF-8'), "\n";
echo '[', htmlspecialchars($broken, ENT_QUOTES, 'UTF-8'), "]\n";
Ожидаемый результат
Кисть �(
[]
Байт C3 требует продолжения UTF-8, а вместо него пришла (. С ENT_SUBSTITUTE плохая последовательность видна как �; без него в этом примере возвращается пустая строка. Это защита вывода, а причину повреждения источника ещё нужно найти. Функция не готовит данные для SQL, JavaScript, CSS или shell: там другие правила.
Экранируйте на границе нужного вывода, храните исходный текст. Не вызывайте декодер «на всякий случай» перед экранированием: это меняет буквальные сущности пользователя. URL в href дополнительно требует проверки допустимой схемы/формирования самого URL; скрипт и CSS имеют другие контексты. Полные флаги, их приоритет, кодировки и правила повреждённых данных.
Сопоставьте: htmlentities, html_entity_decode, htmlspecialchars_decode, get_html_translation_table. Байты, символы и выбор операции.
Источники и обсуждения
- PHP Manual: language.types.string
- strlen() — официальный справочник
- mb_strlen() — официальный справочник
- htmlspecialchars() — официальный справочник
- grapheme_substr() — официальный справочник
- PHP Manual: function.trim
- PHP Manual: language.operators.string
- PHP Manual: function.grapheme-strlen
- PHP Manual: function.implode
- PHP Manual: function.explode
- PHP Manual: migration82.deprecated
- PHP Manual: function.bin2hex
- PHP Manual: function.json-encode
Код и руководство с собой
Скачайте самостоятельные примеры с исходными данными, инструкциями и ожидаемыми результатами. Примеры HTTP и фрагменты для проекта помечены отдельно: им нужно указанное окружение.
Код не исполняется на сайте. Скачайте нужный пример и запускайте его в своём локальном окружении.
Материалы сверены 2026-10-12. Примеры и объяснения написаны для этого руководства; источники и обсуждения доступны в каждой главе.